可靠性,写进工程。
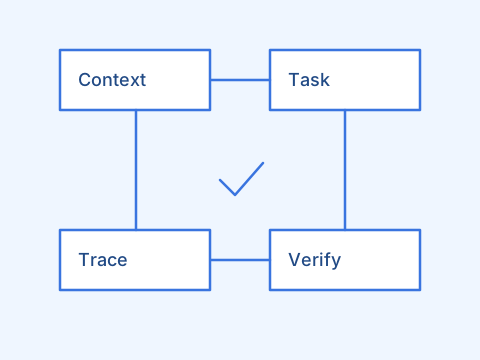
原创流程示意:任务经过 Agent 执行、工具验证与人的复核,反馈重新进入任务循环

openEuler Meetup 西安站
AI Agent 可靠性 & 软件工程

2026 年 10 月 31 日
西安电子科技大学南校区

让 Agent 的工作经得起验证

从五场现场分享,整理能回看的知识、能反思的经验,以及能在下一个项目里执行的行动。

阅读五场讲座

从现场出发

5 场 / 74 张

一份会议海报,以及五场讲座的现场照片。

查看完整会议海报

贯穿五场分享的,是如何为 Agent 的执行建立边界、证据与反馈。

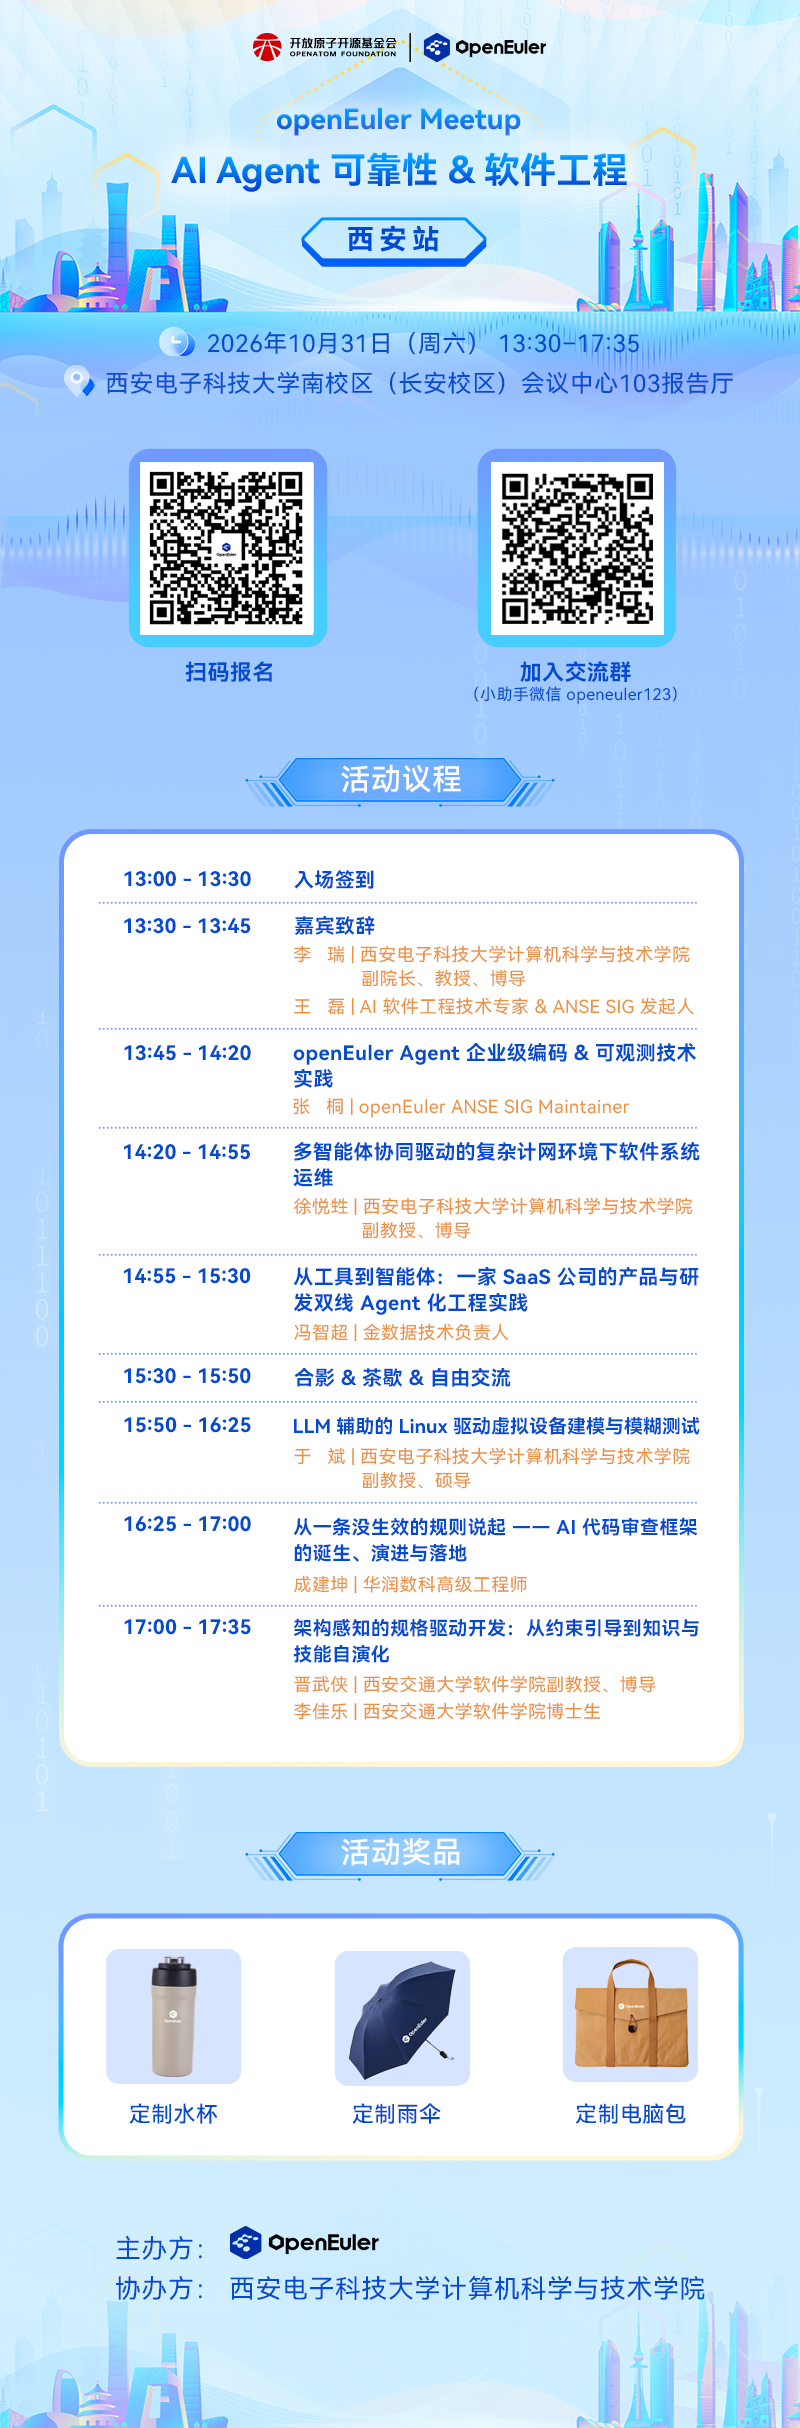
会议海报标注活动于 13:30–17:35 在西安电子科技大学南校区(长安校区)会议中心 103 报告厅举行,由 openEuler 主办、学校计算机科学与技术学院协办。本文按海报顺序整理已有照片的五场技术报告。

海报还列有 17:00–17:35 的“架构感知的规格驱动开发:从约束引导到知识与技能自演化”,本文件夹未提供该场资料,因此未纳入五场总结。

阅读约定:讲座内容注明照片依据;“我的心得”和行动计划是基于材料的思考与建议。现场照片不是完整逐字稿,照片中的实践数字也不自动等于独立验证的研究结论。

五场,逐一读懂

从执行与观测,走向测试和审查。
选择一个主题,阅读完整的内容、心得与行动。

企业级编码与可观测概念示意图

张桐
openEuler ANSE SIG Maintainer

13:45–14:20
议程时间,以会议海报为准

openEuler Agent 企业级编码 & 可观测技术实践

交付要有依据,执行要可追踪。

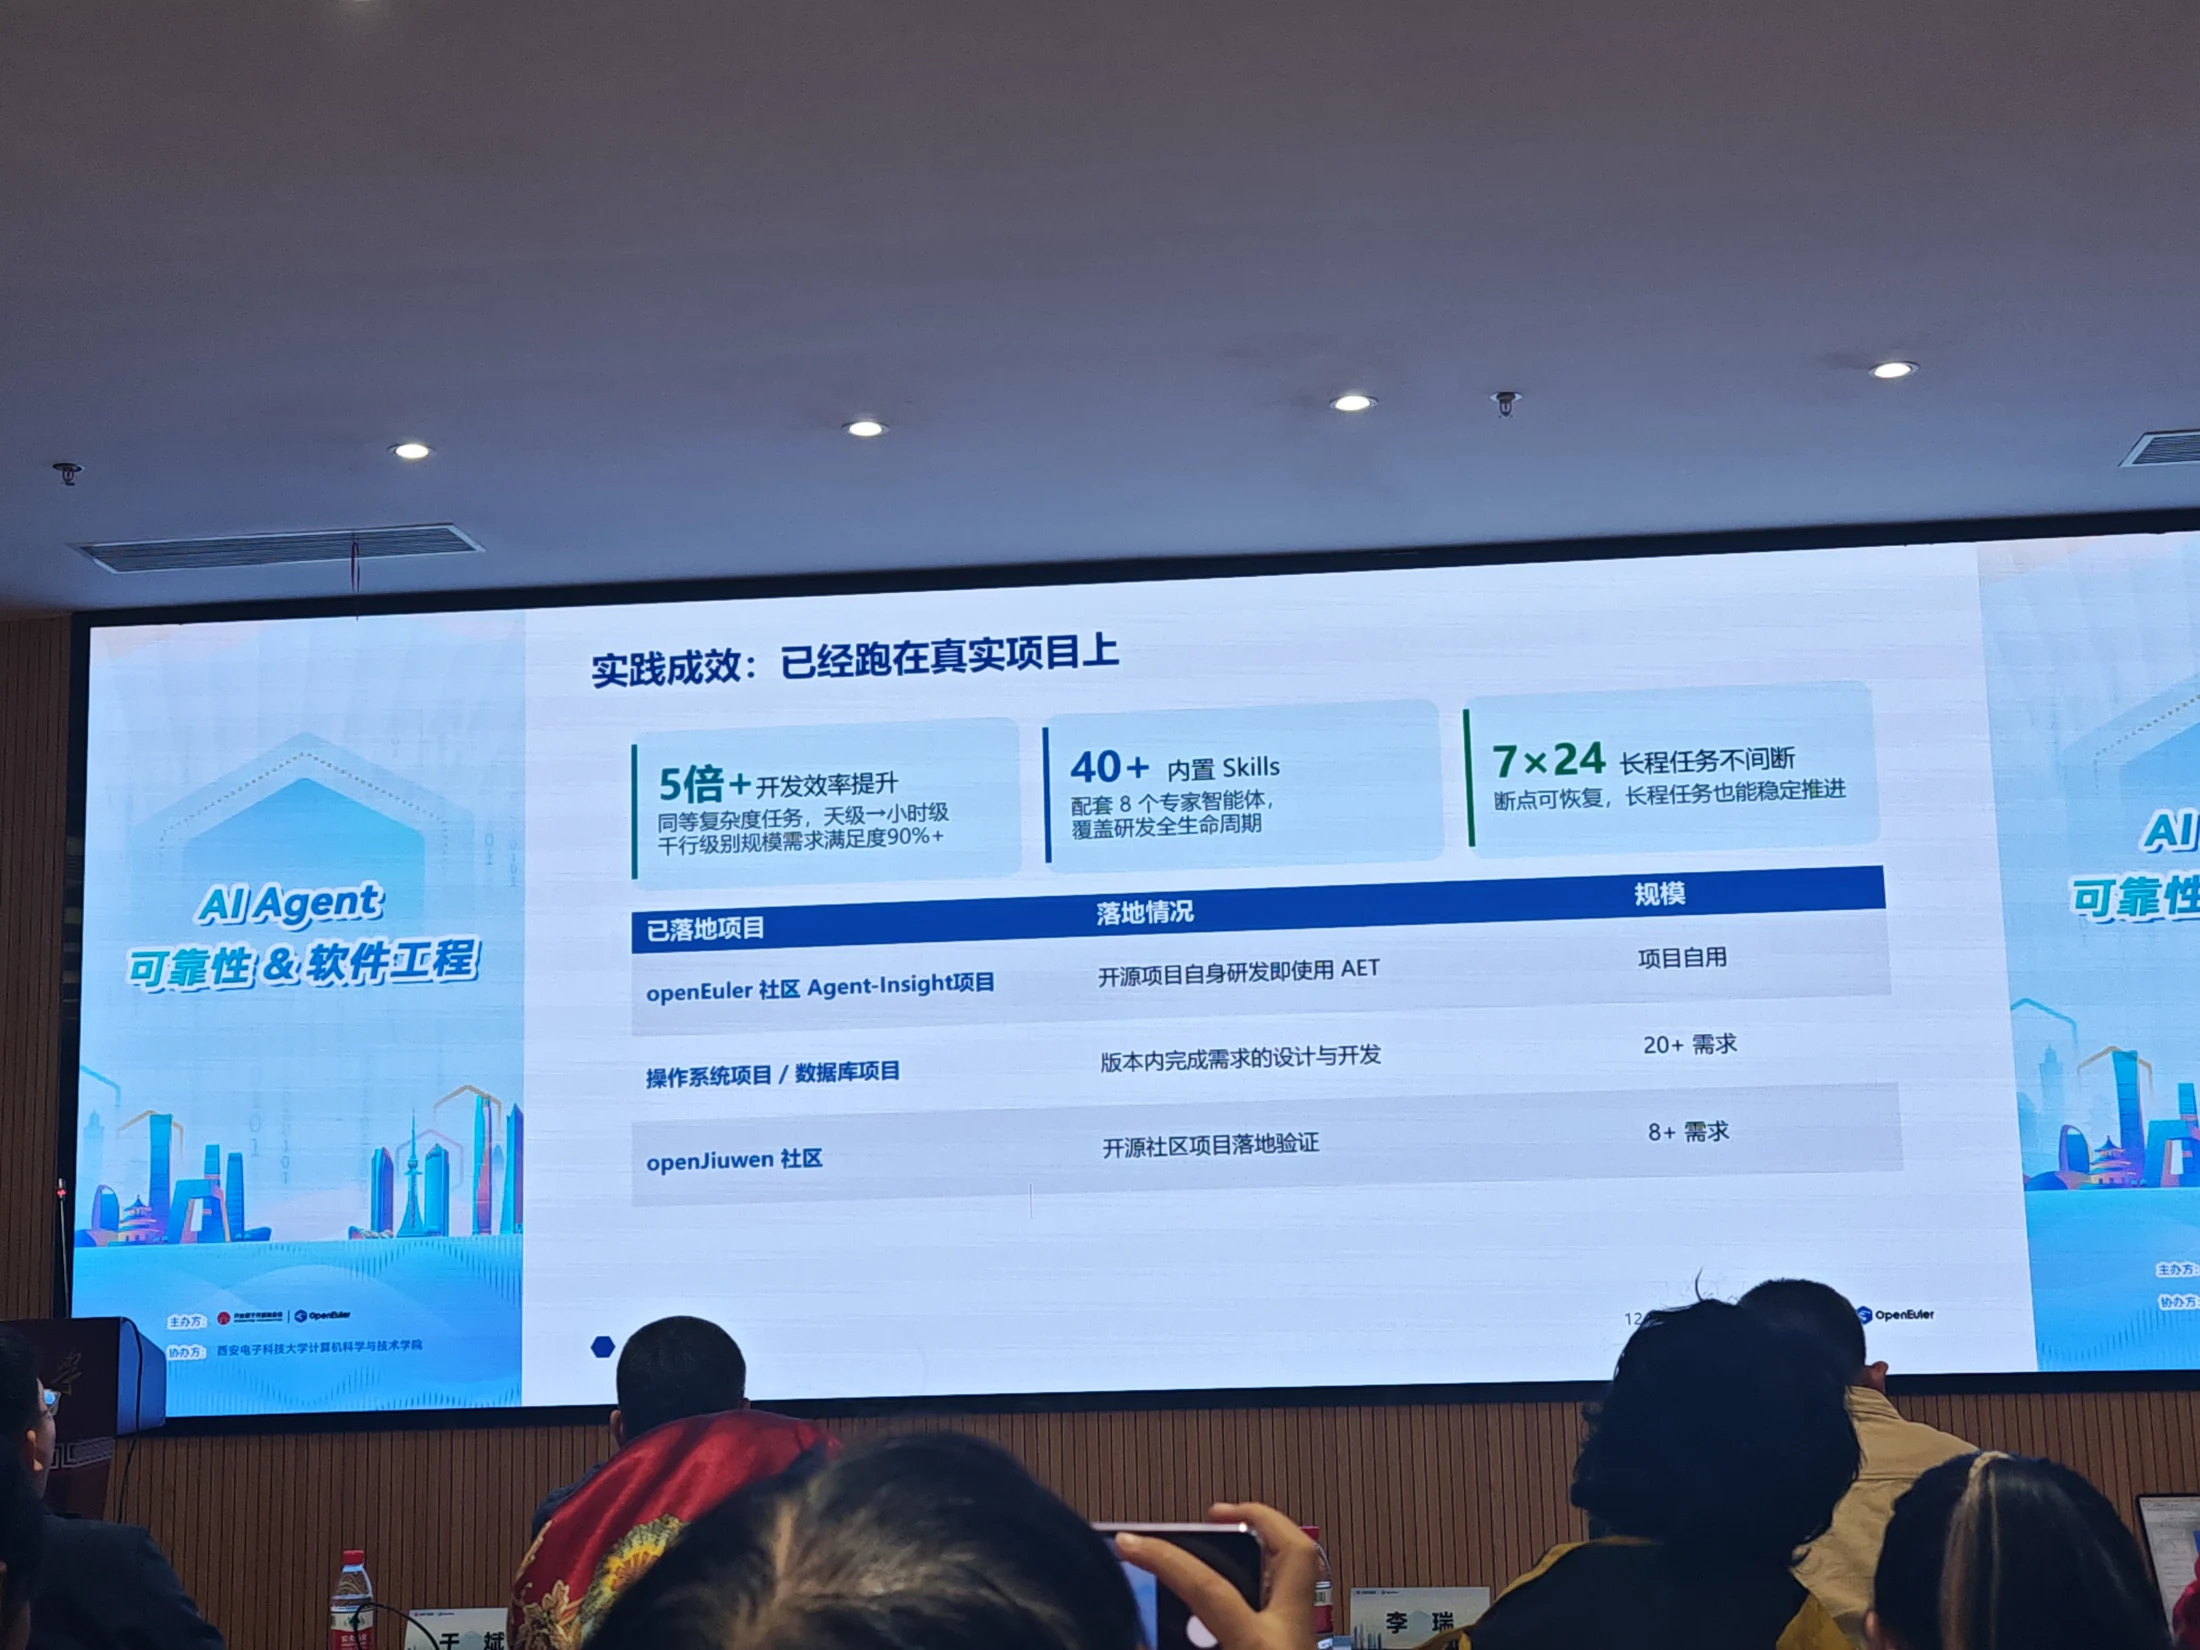
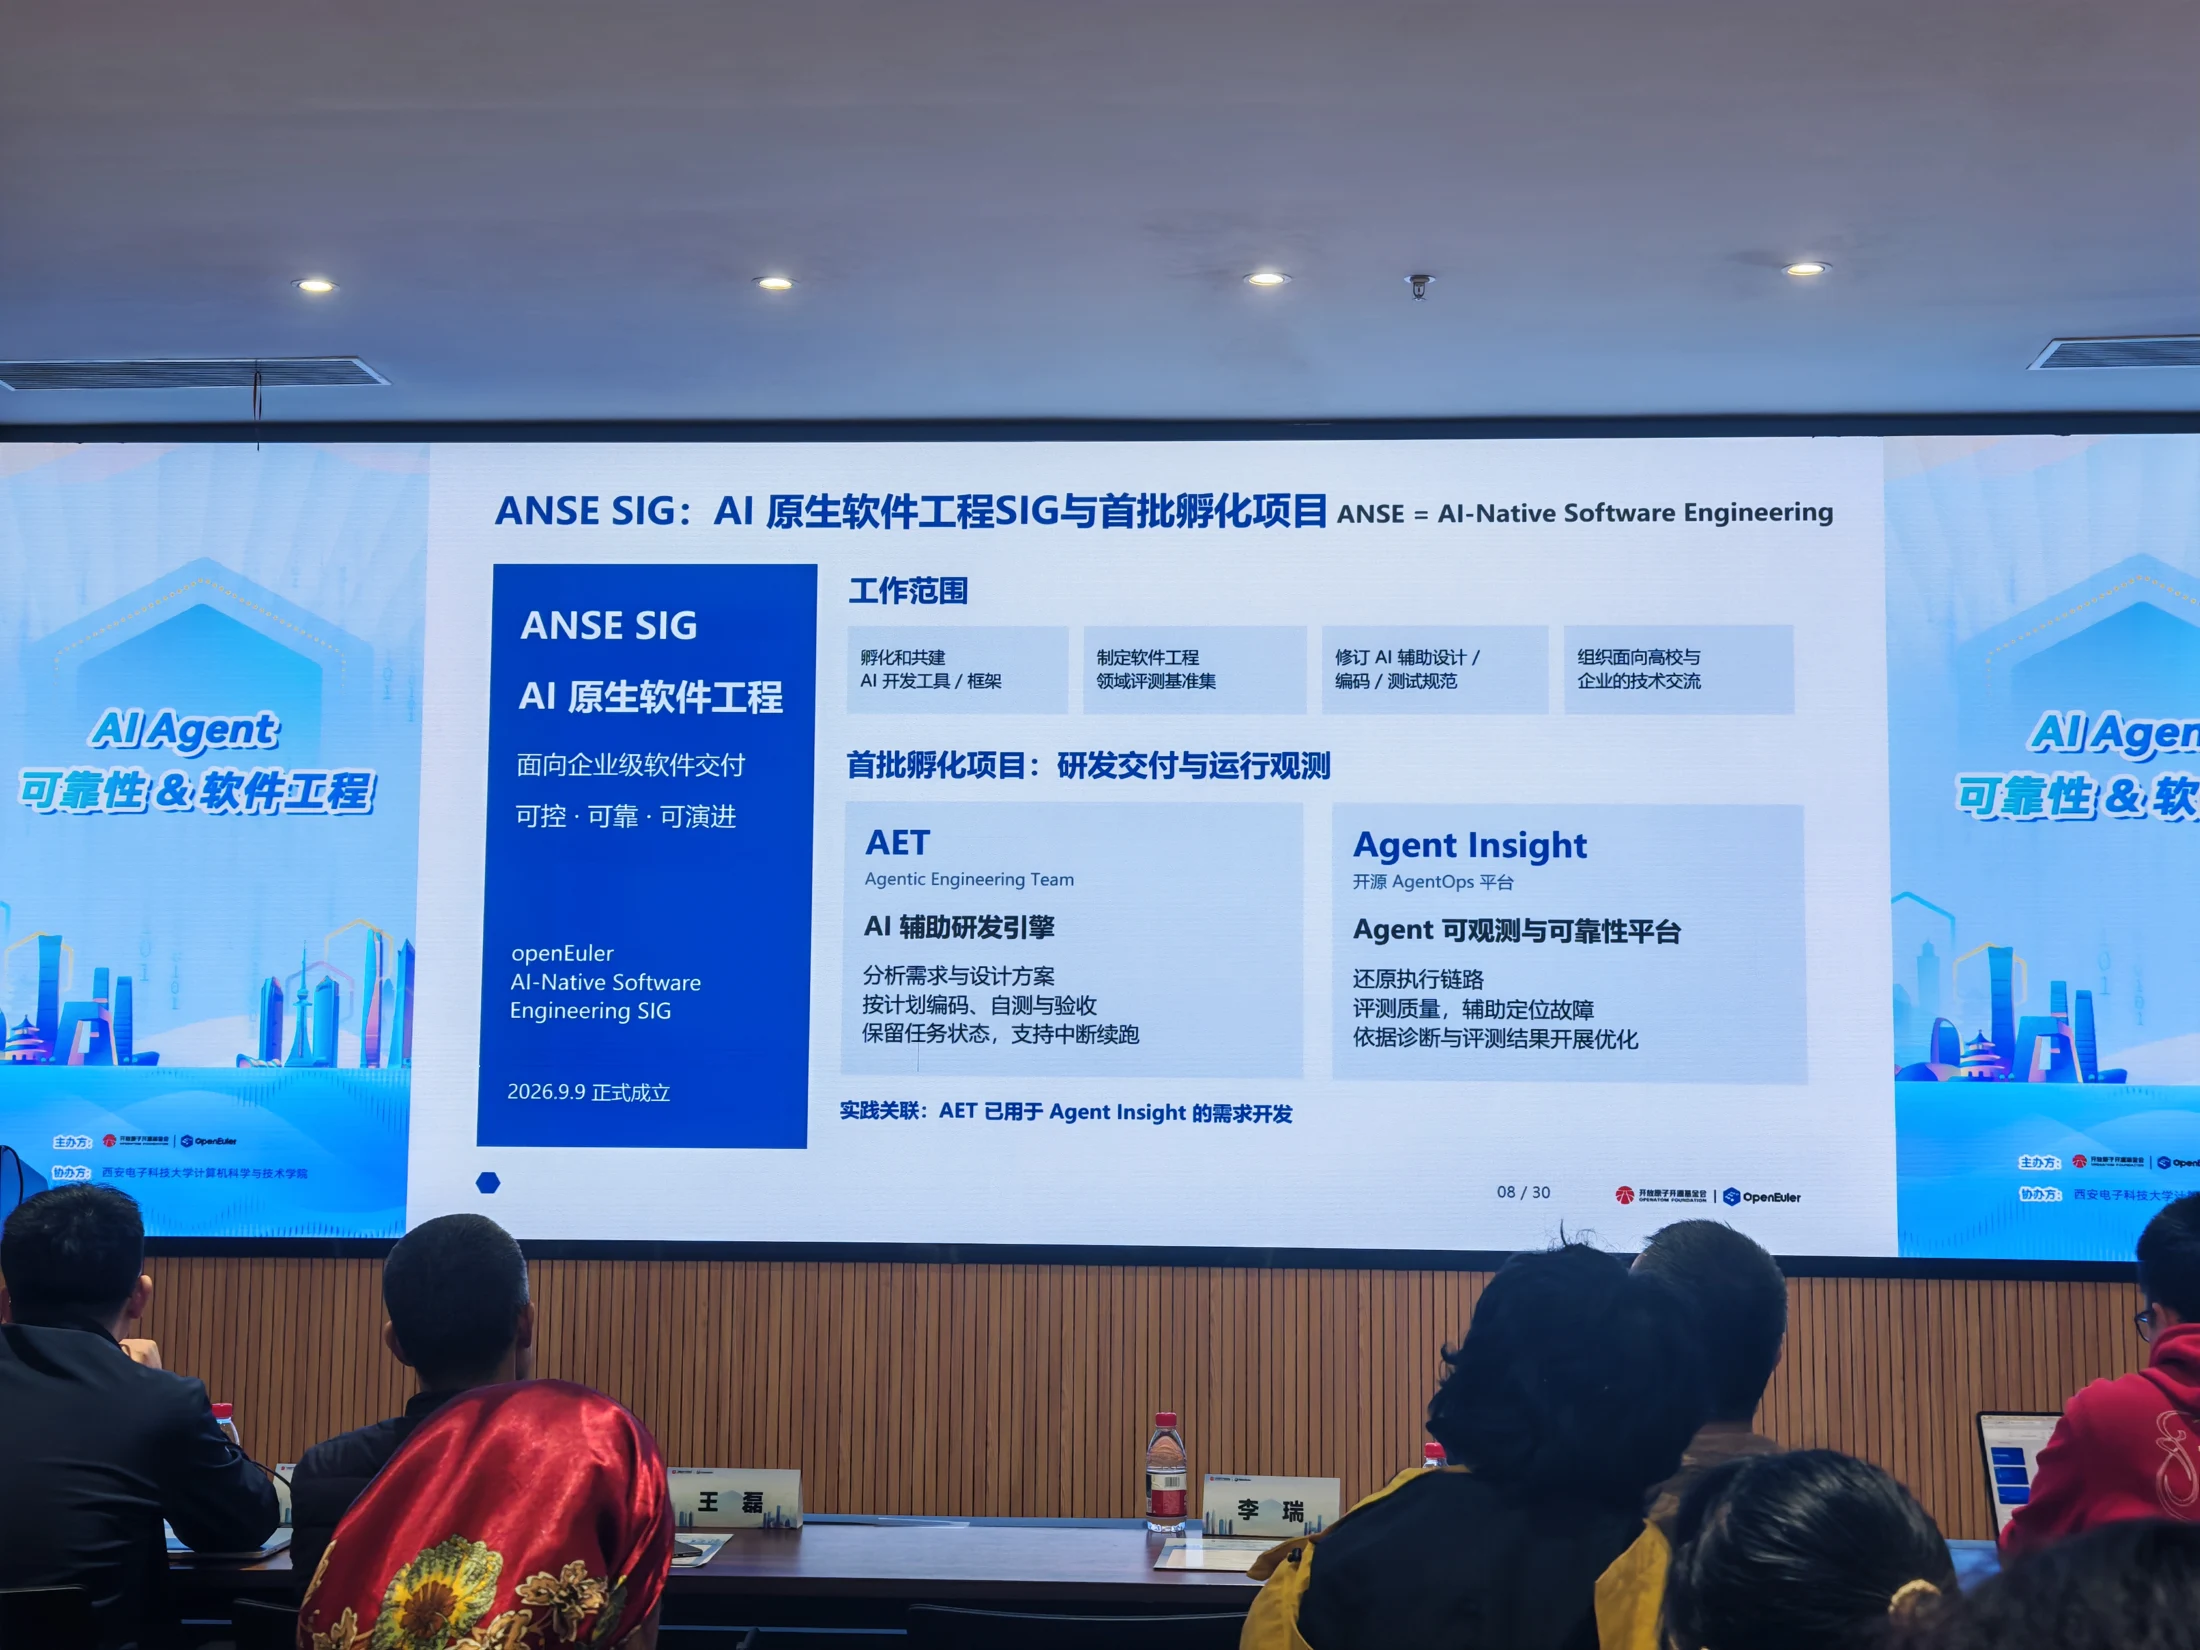
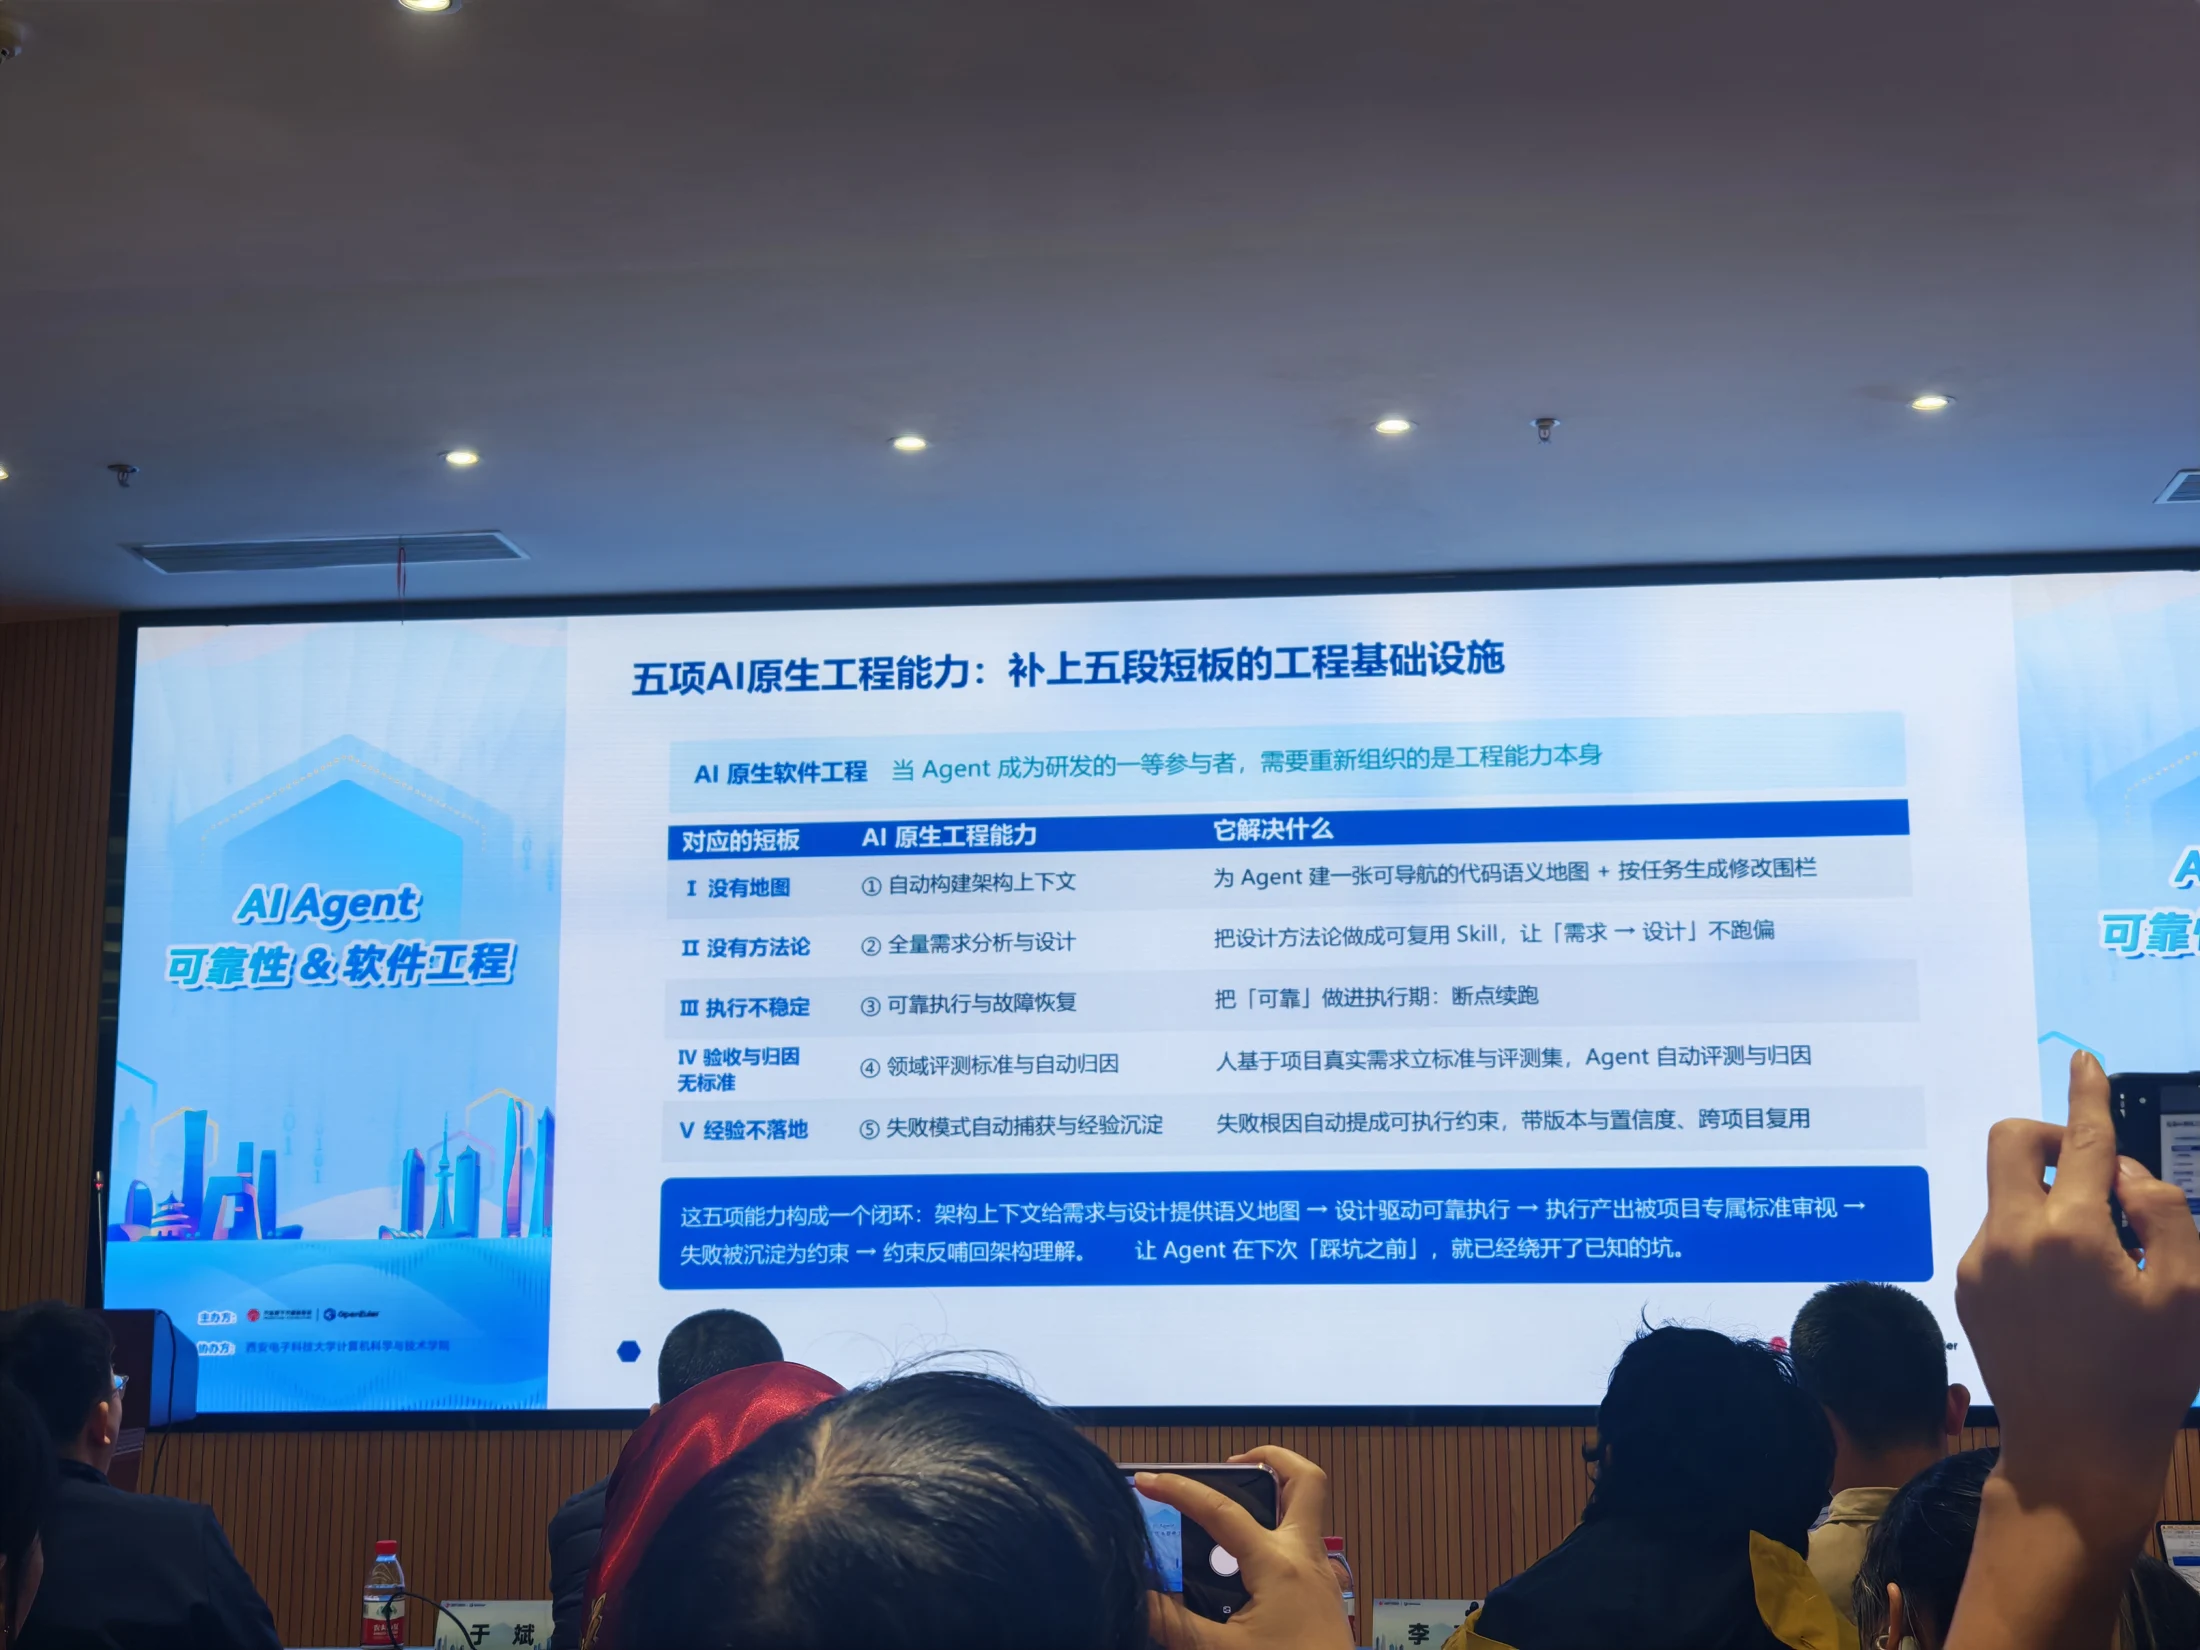
当 Agent 成为研发执行主体,工程师需要重新安排上下文、任务边界、验收和运行观测。AET 与 Agent Insight 分别承接研发交付和运行观测两条线。

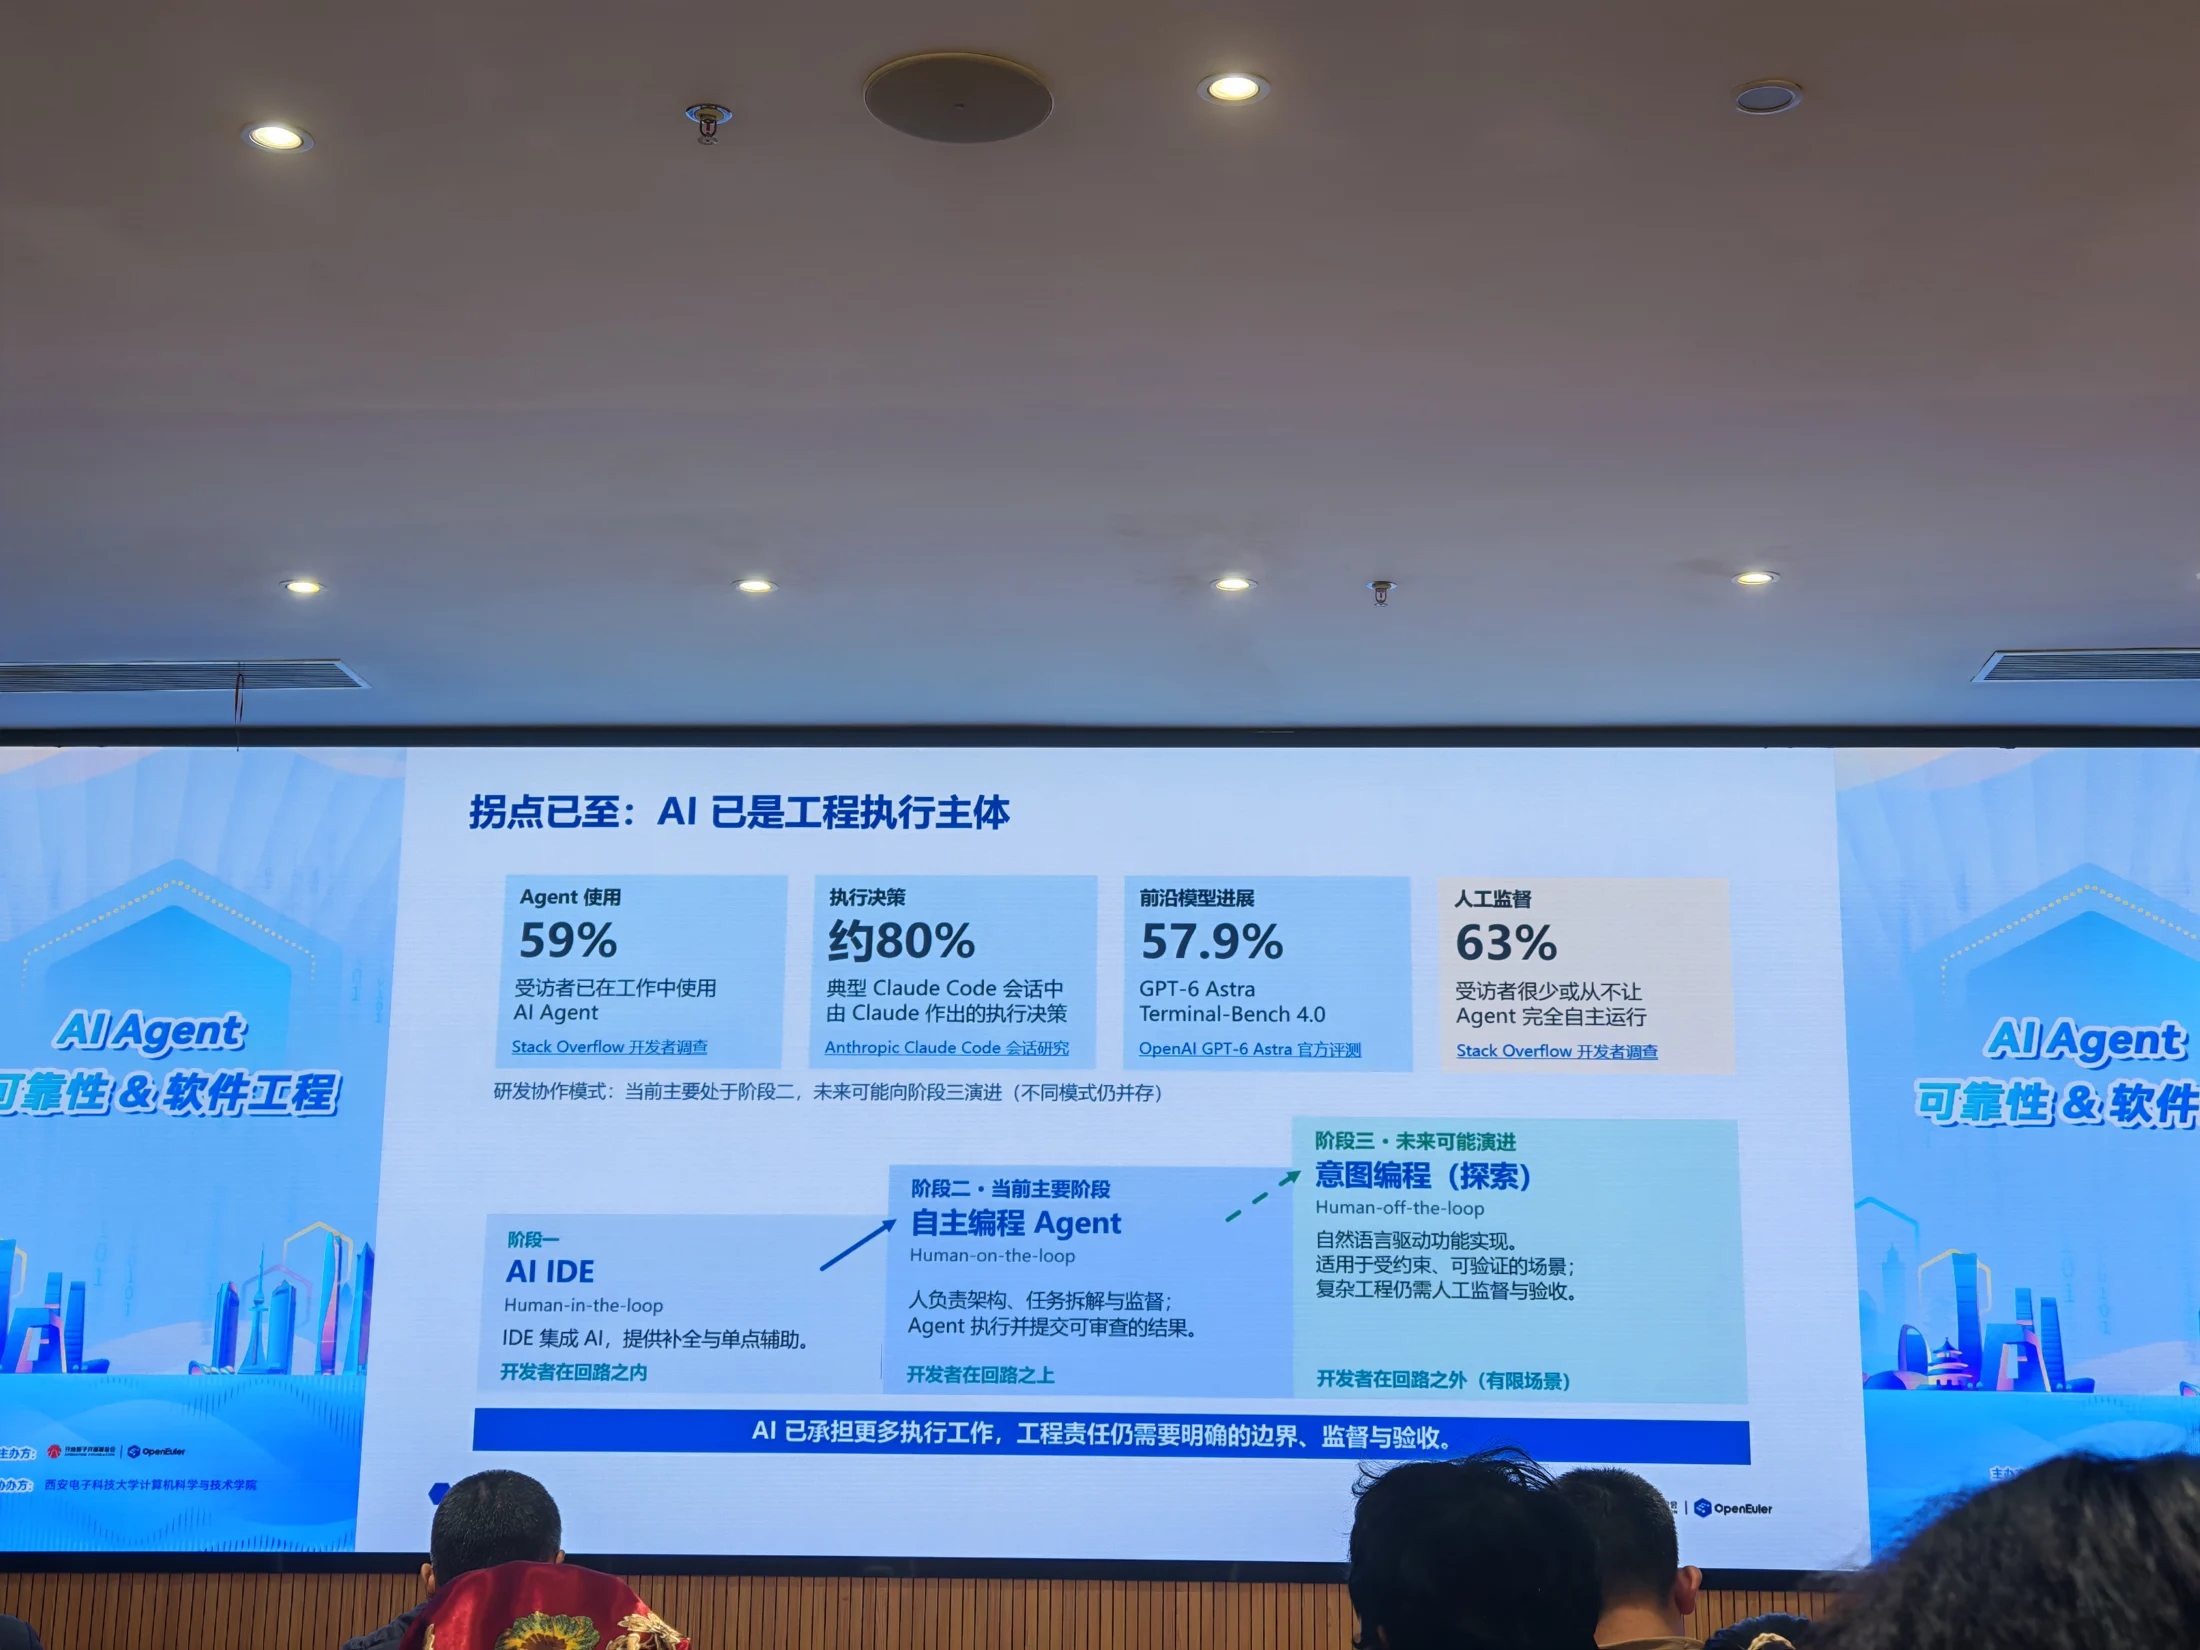
材料边界:照片中的使用率、模型评测和“5 倍+”等数字未逐一追溯原始研究,因此不作为本站的普适结论。

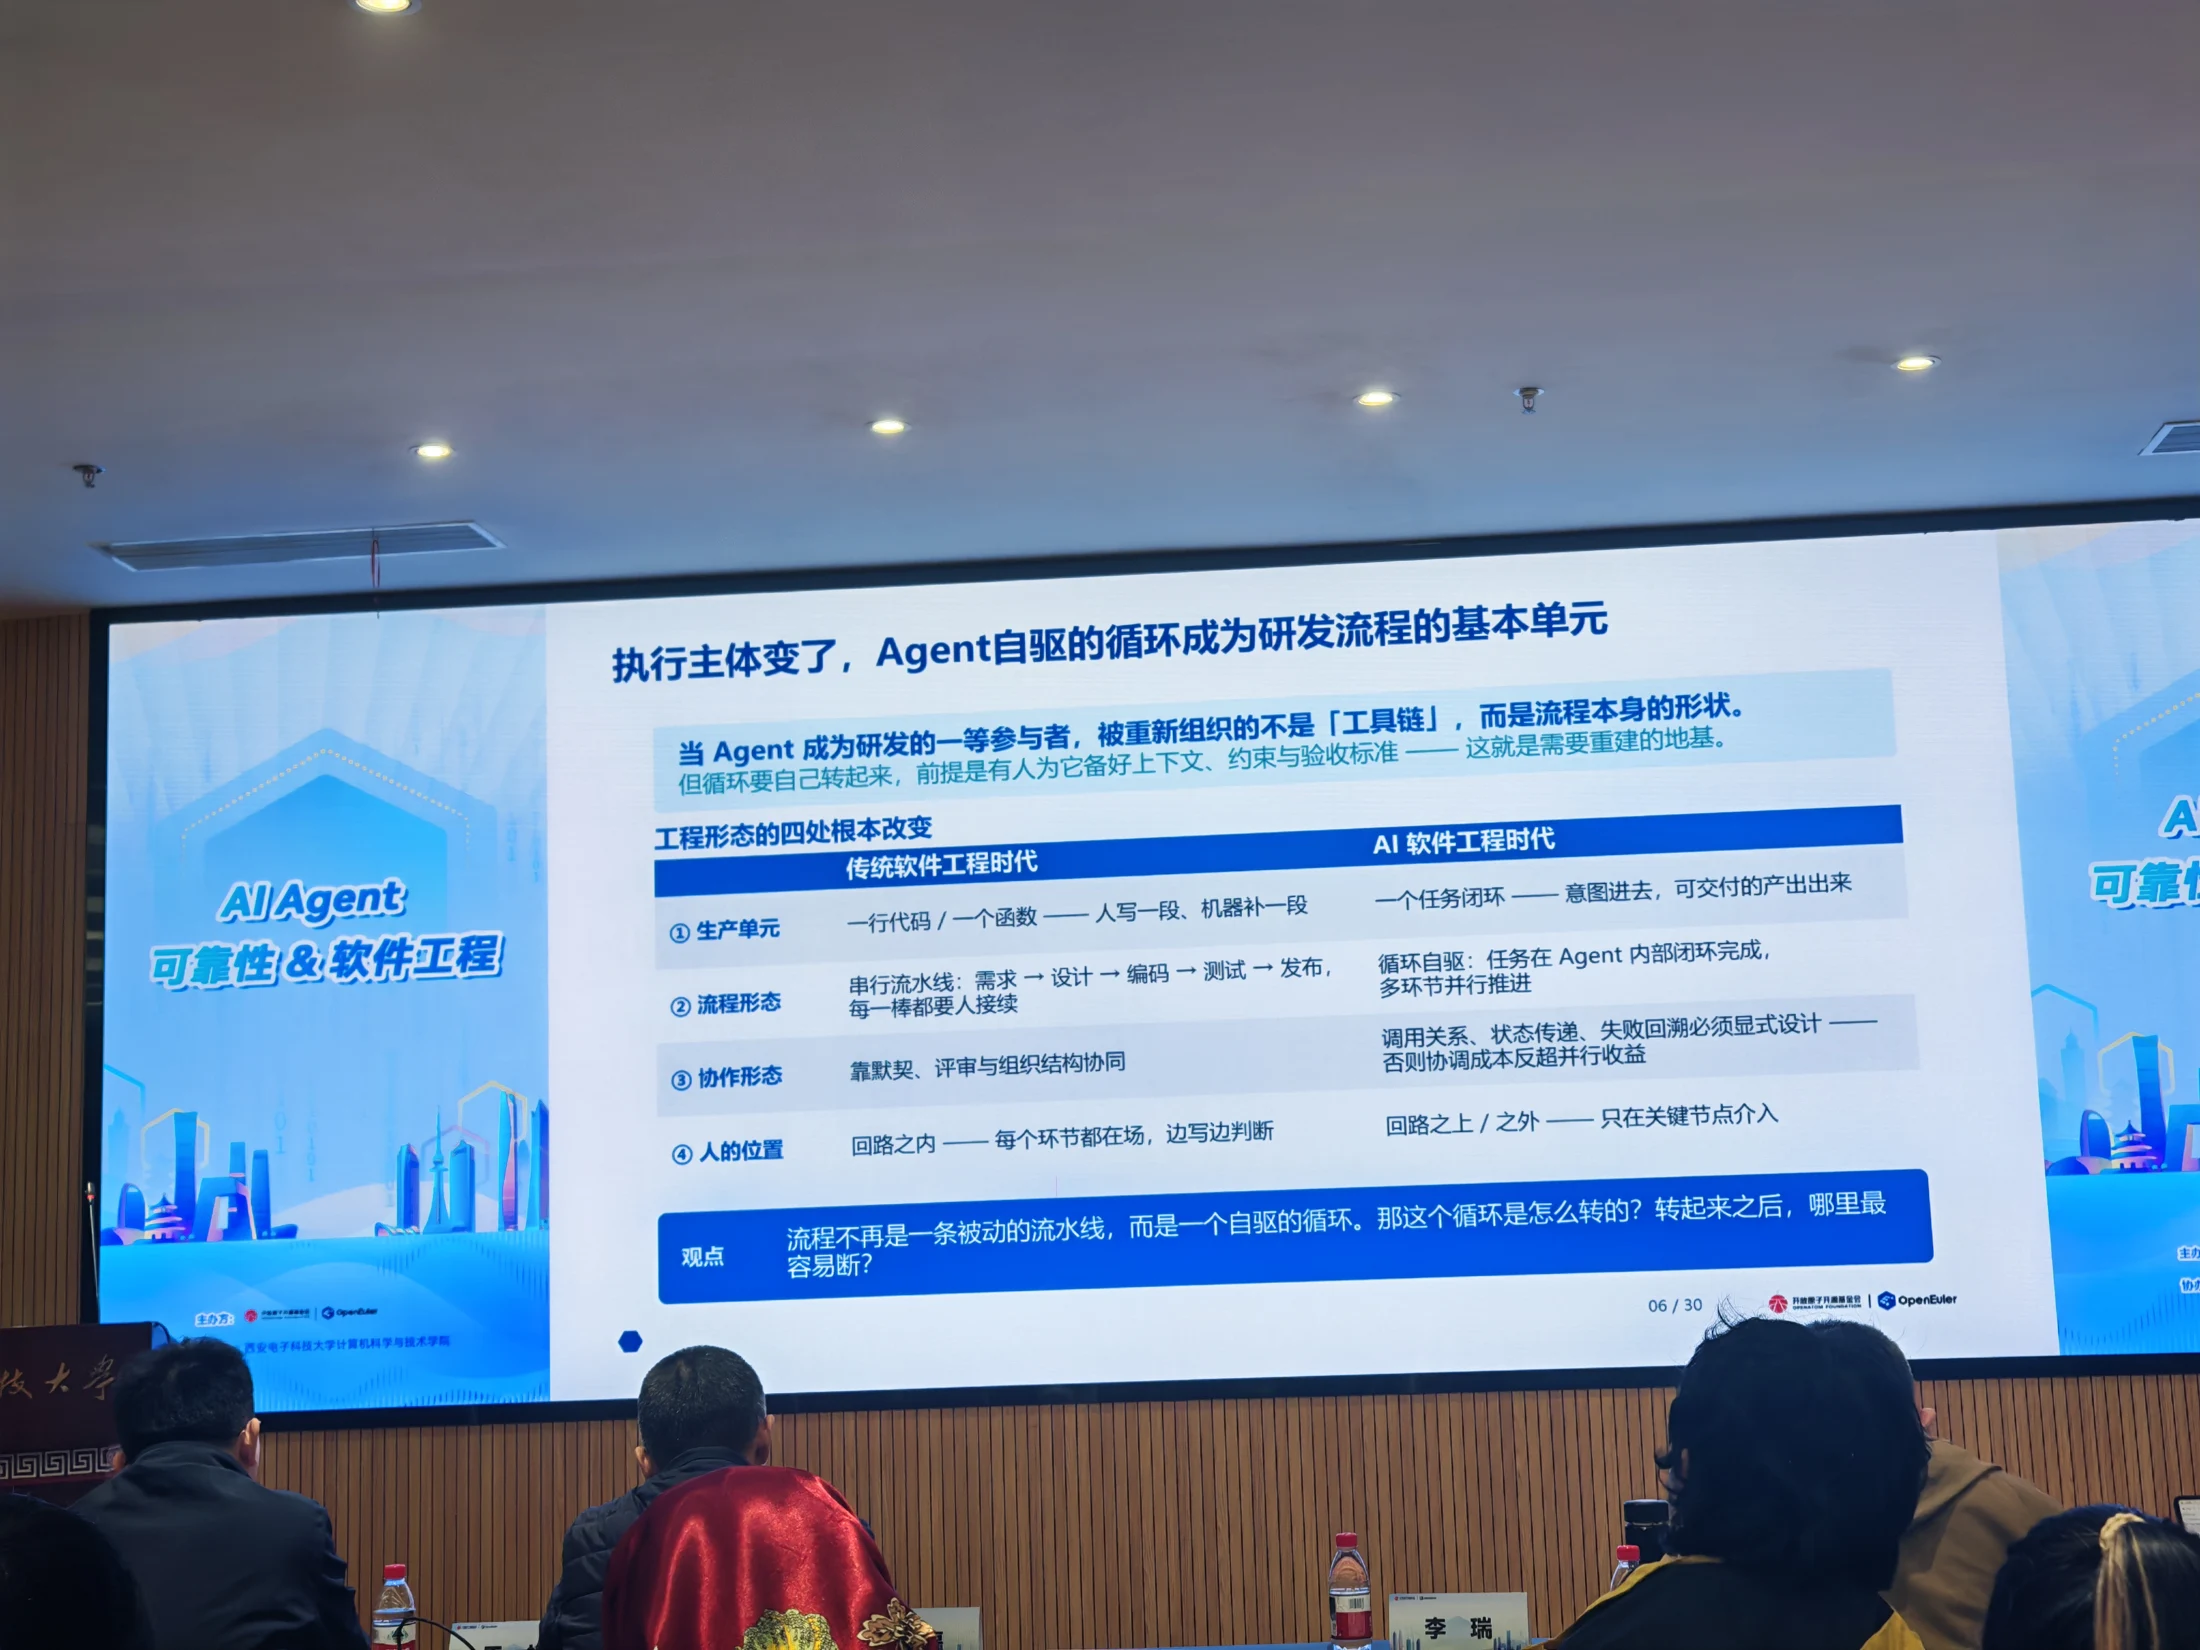
执行主体变了,工程责任仍在

照片把研发基本单元描述为 Agent 自驱的任务循环。人的工作集中在定义目标、准备上下文、明确约束,以及最终验收;长任务还需要状态管理、故障恢复和并行协同。

查看照片 IMG_20261031_134731.jpg

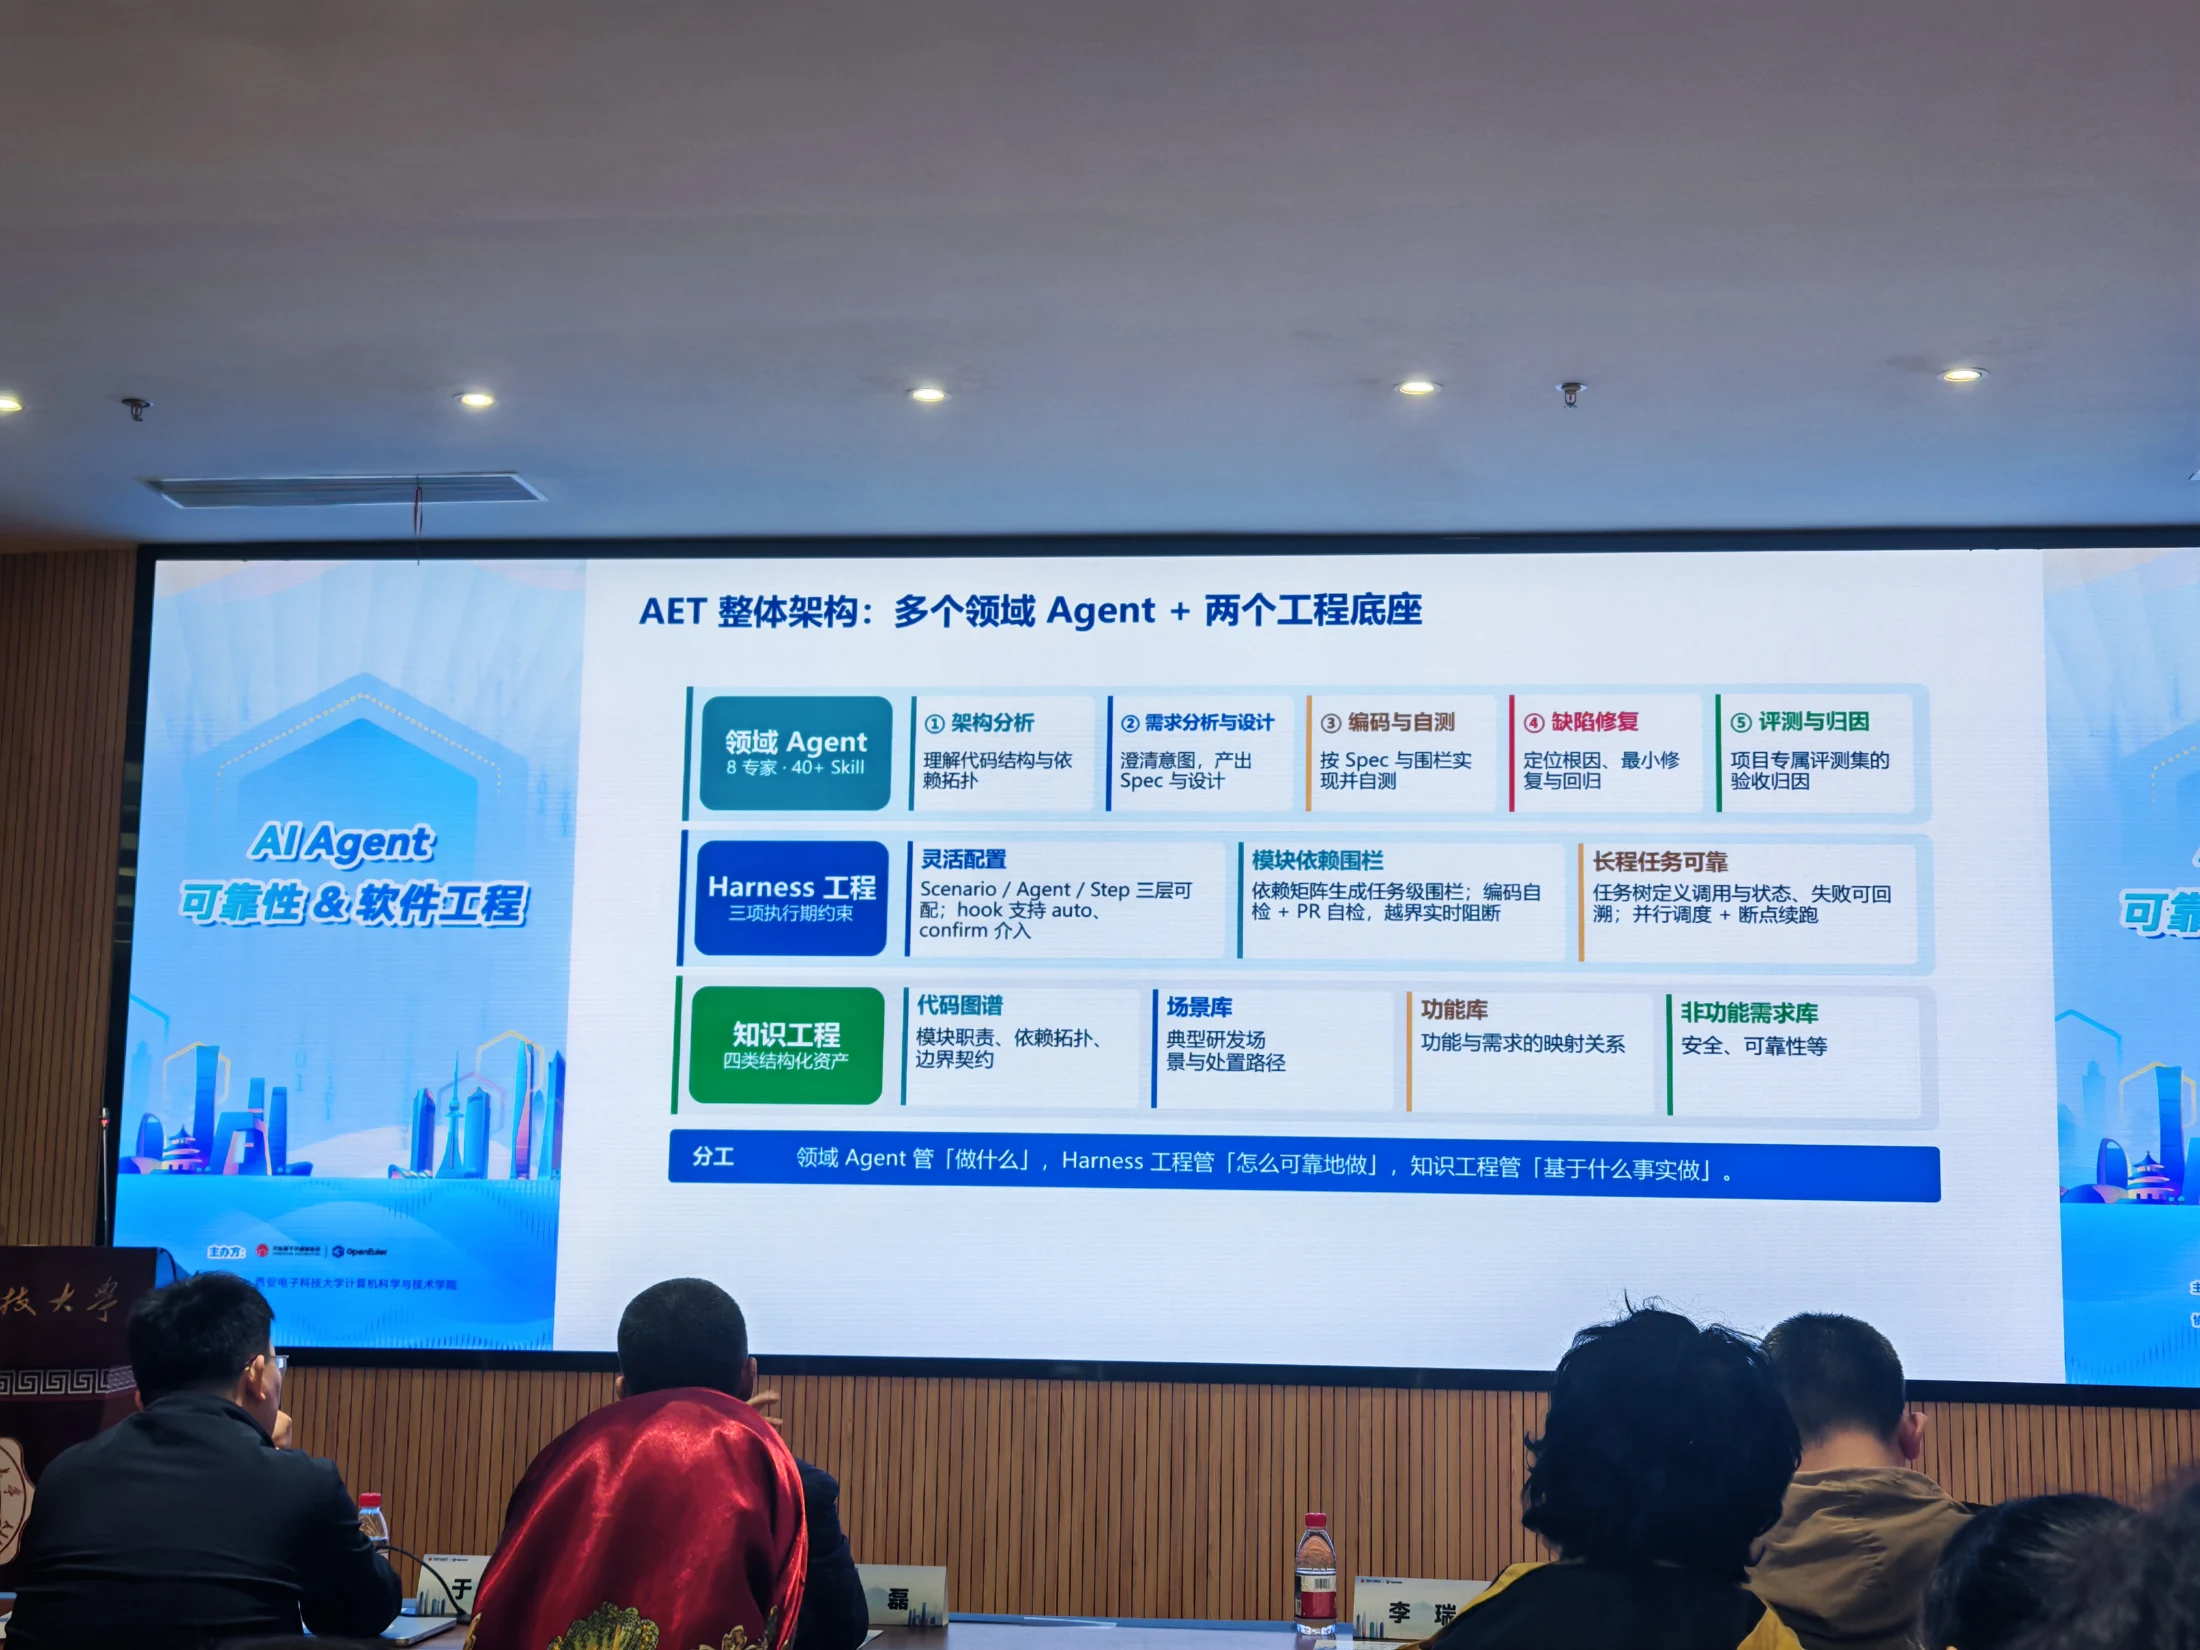
AET:领域 Agent 加两个工程底座

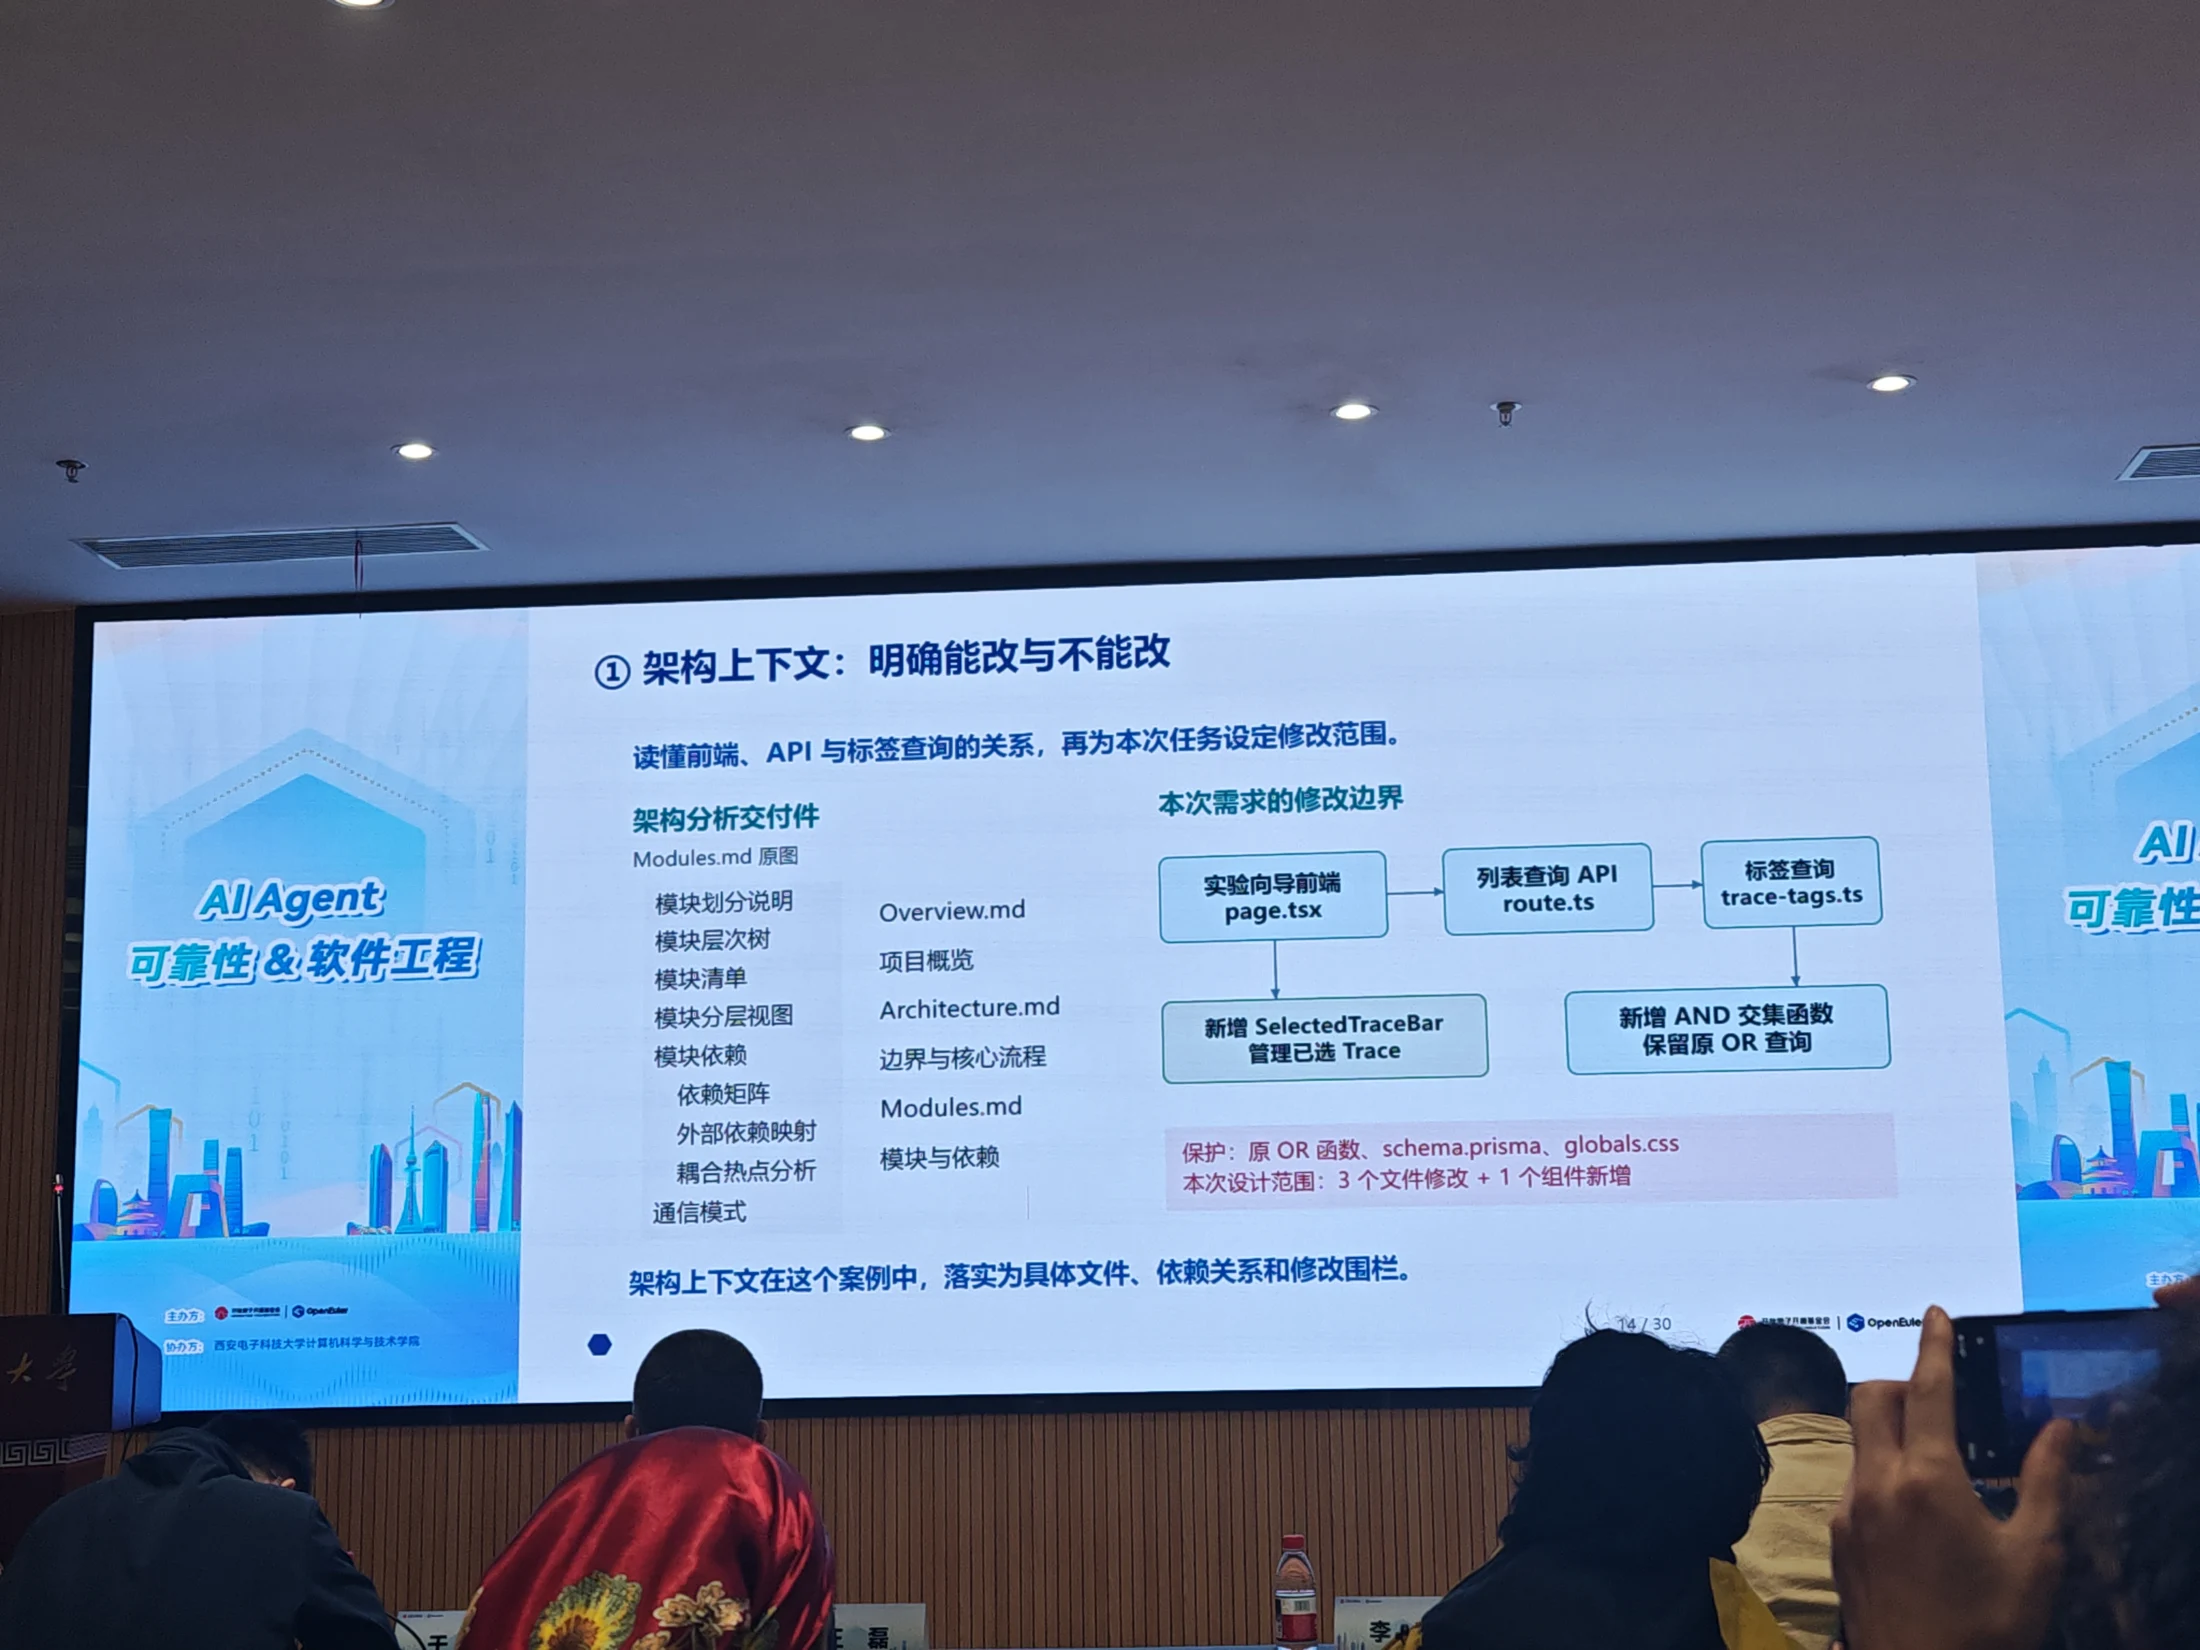
架构分析、需求分析与设计、编码与自测、缺陷修复、评测与归因由领域 Agent 承担。Harness 工程负责运行可靠性,知识工程提供代码图谱、场景库、功能库及安全可靠性等非功能约束。

查看照片 IMG_20261031_135422.jpg

把需求变成可验收的行为

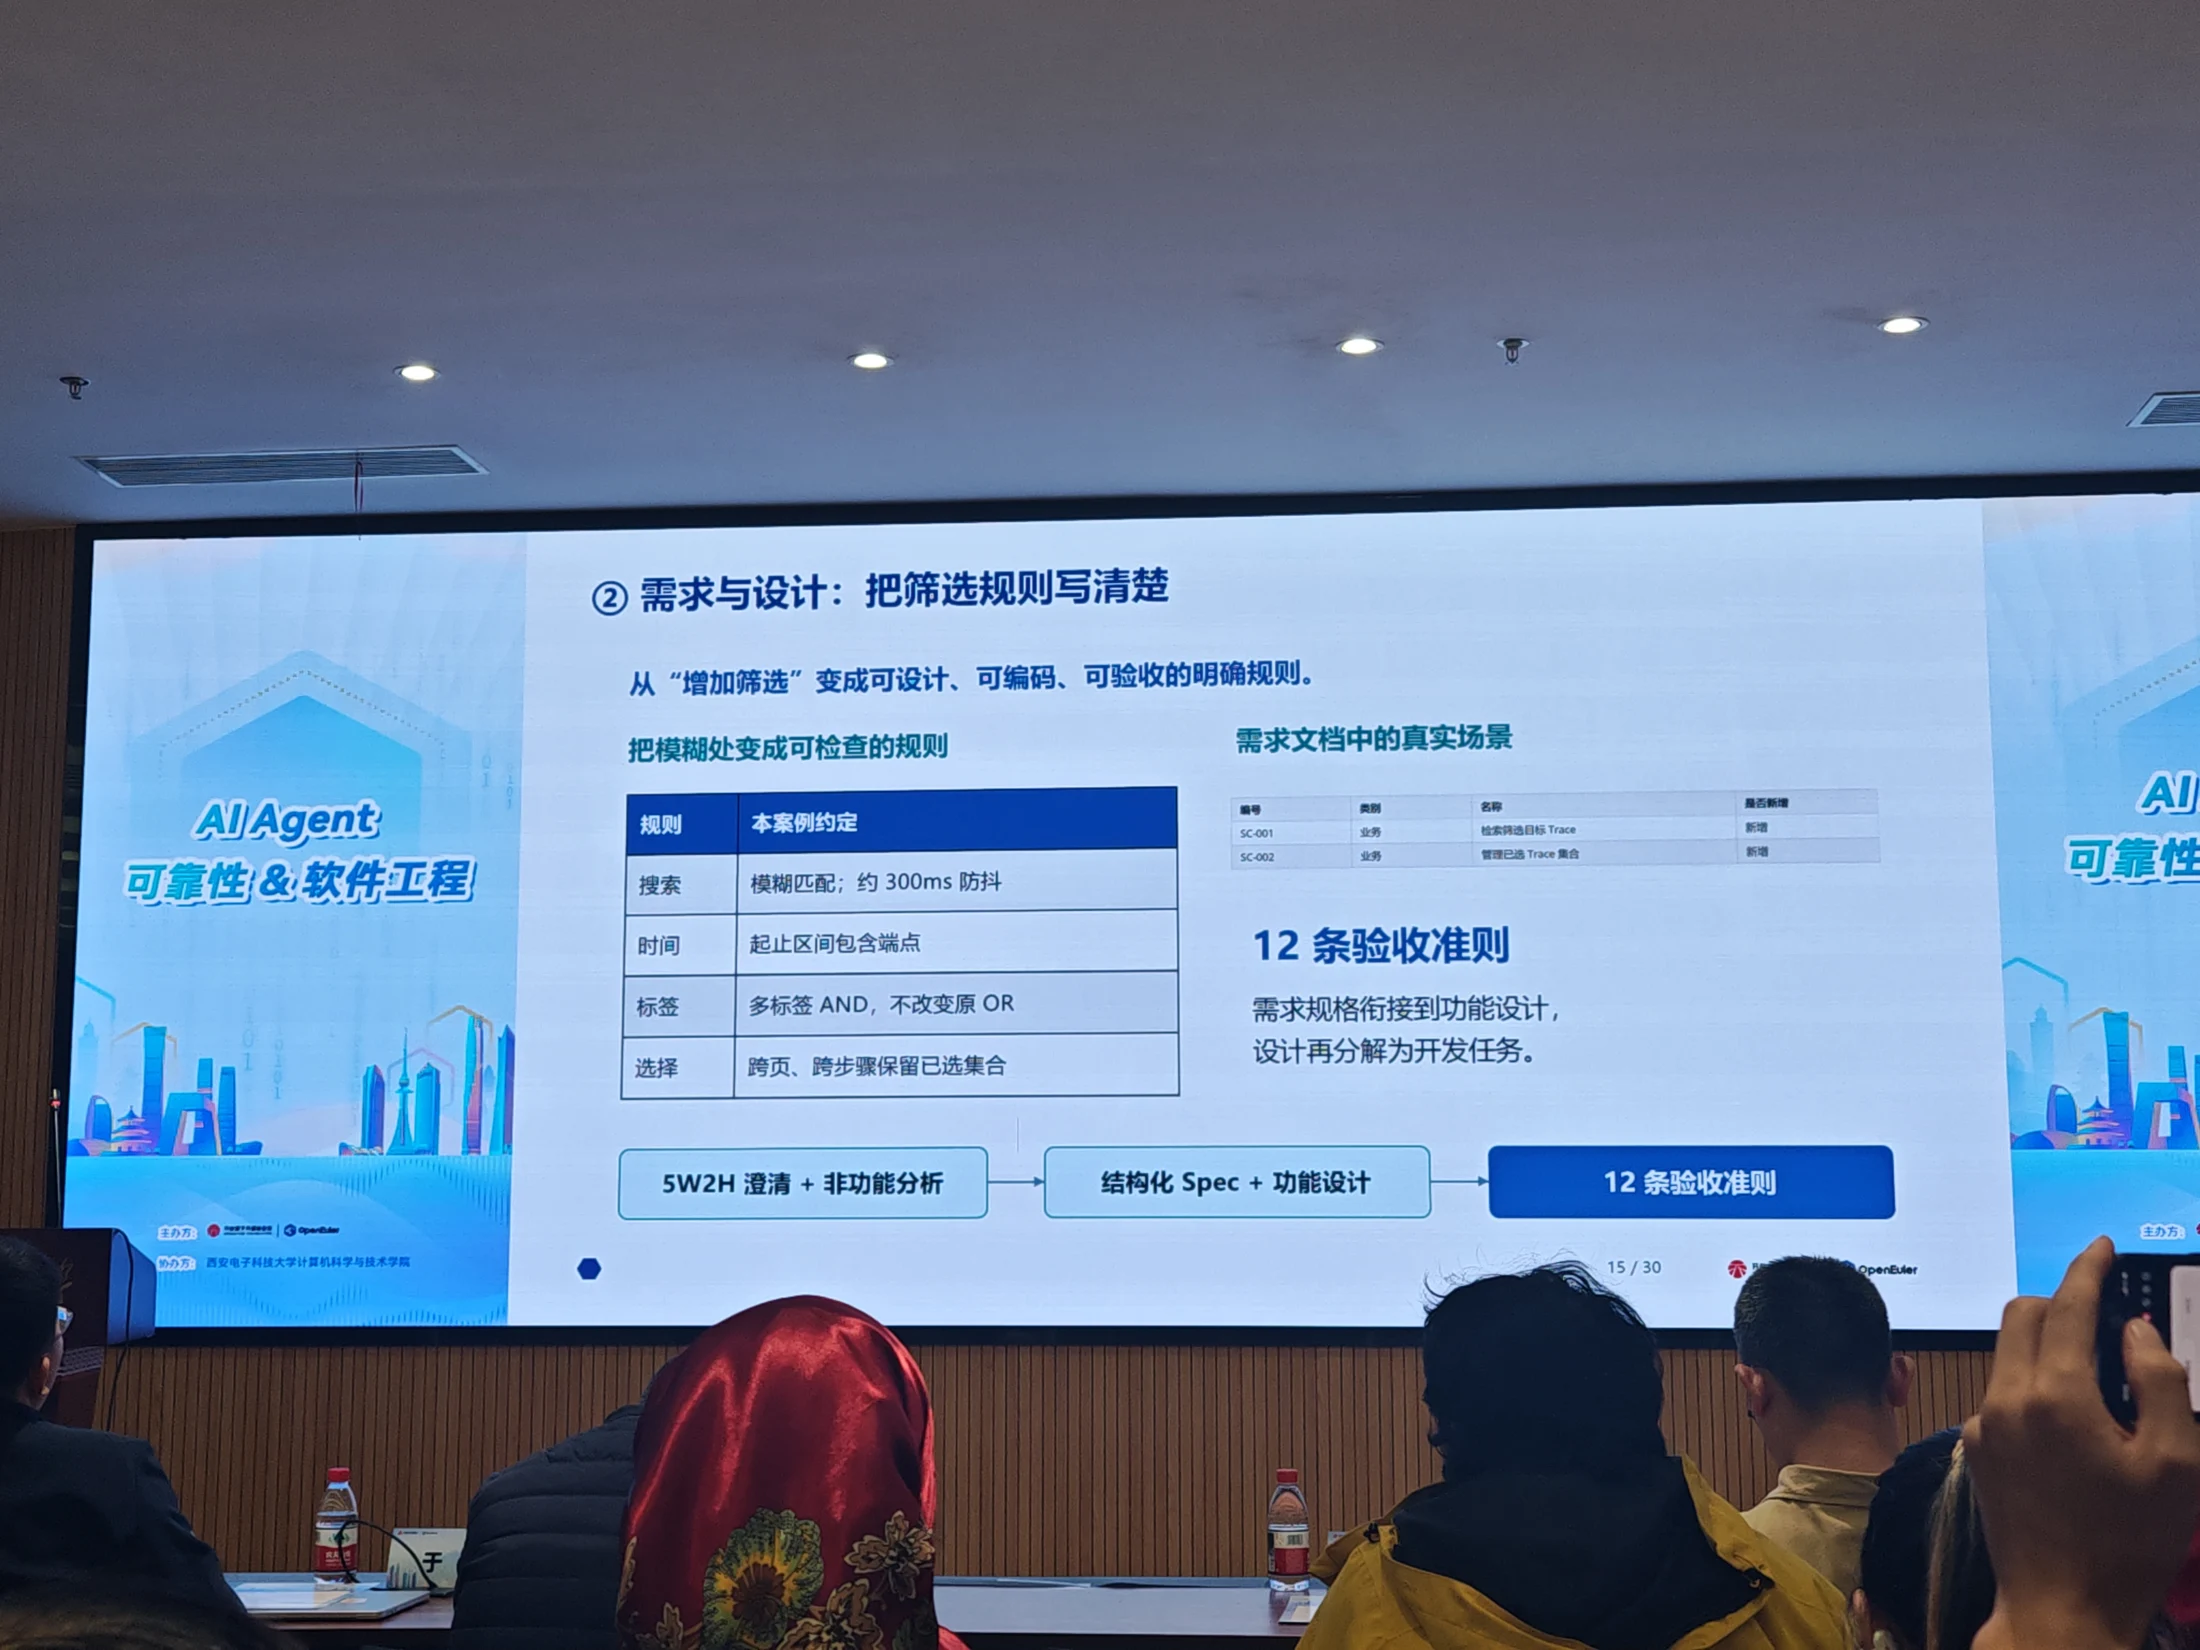
案例不是简单要求“增加筛选”,而是明确搜索防抖、时间边界、多标签 AND 关系、翻页保留状态等规则,并限定可修改文件和保护文件。照片展示了 12 条验收规则,这是案例记录,不是所有项目都适用的固定数量。

查看照片 IMG_20261031_140022.jpg

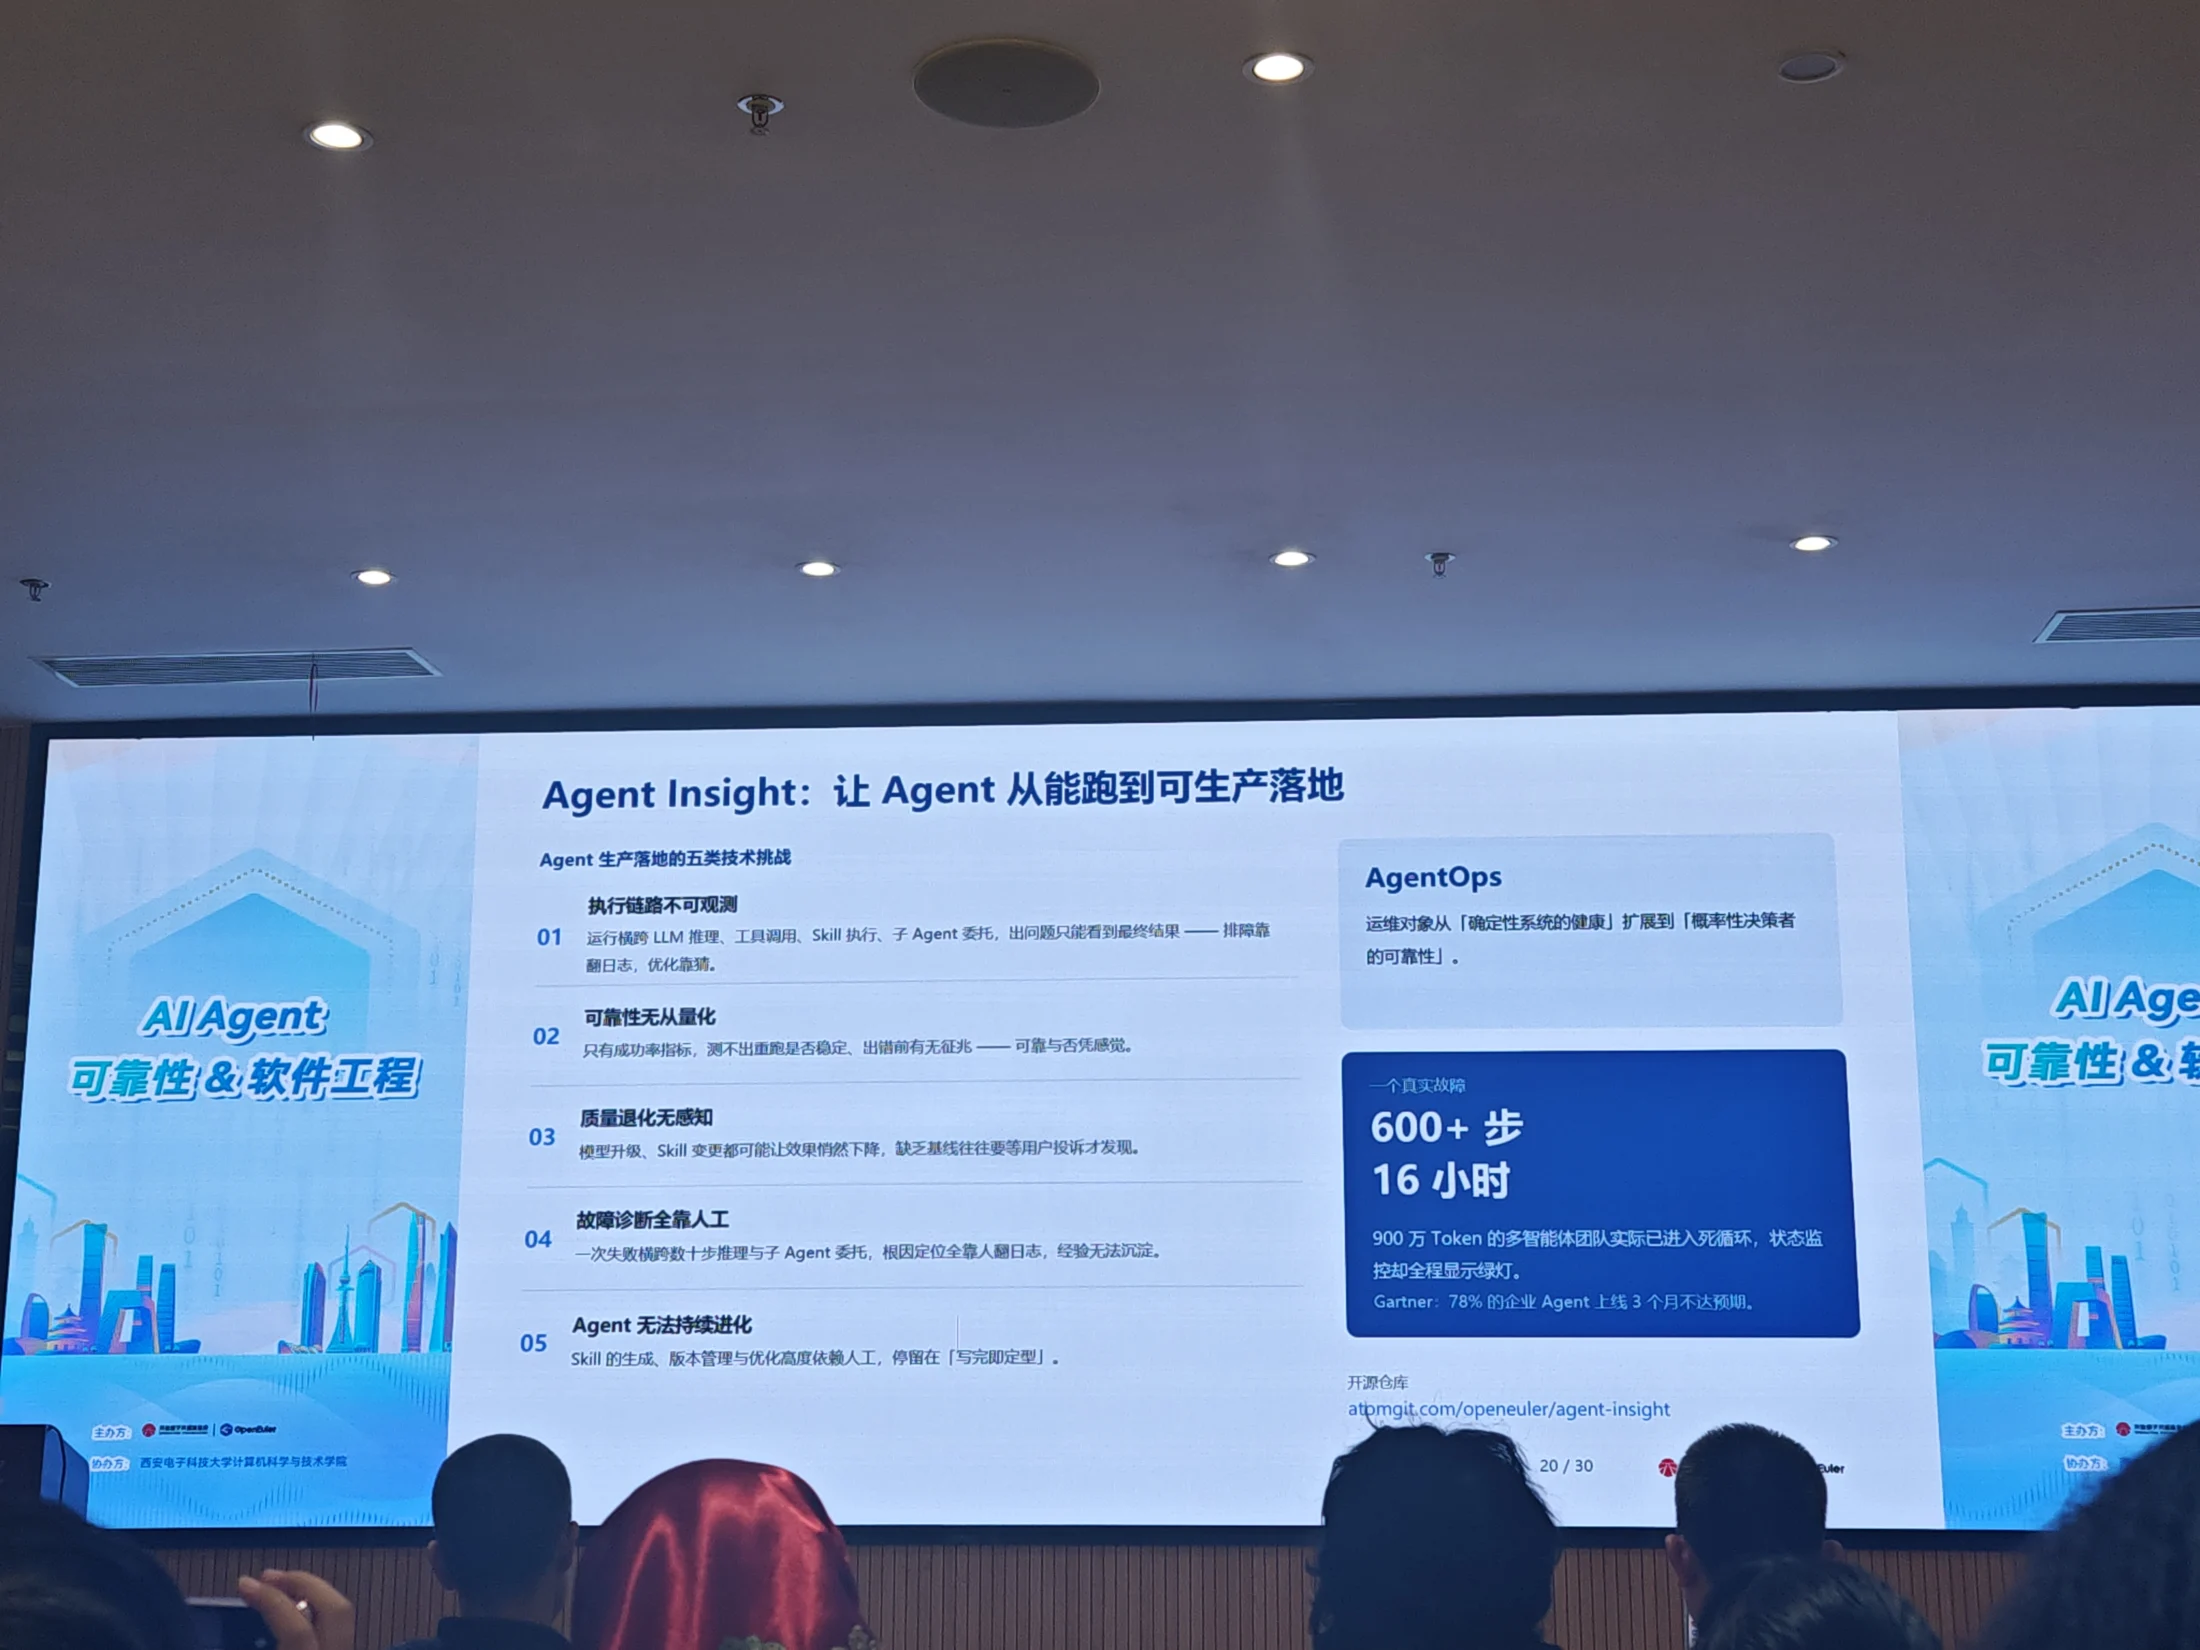
Agent Insight:从能运行到能诊断

长链路中,单条模型日志无法解释工具调用、Skill 执行和 Agent 交接。材料提出用 AgentOps 还原执行过程、定位卡点、量化质量变化,并辅助故障诊断。

查看照片 IMG_20261031_140315.jpg

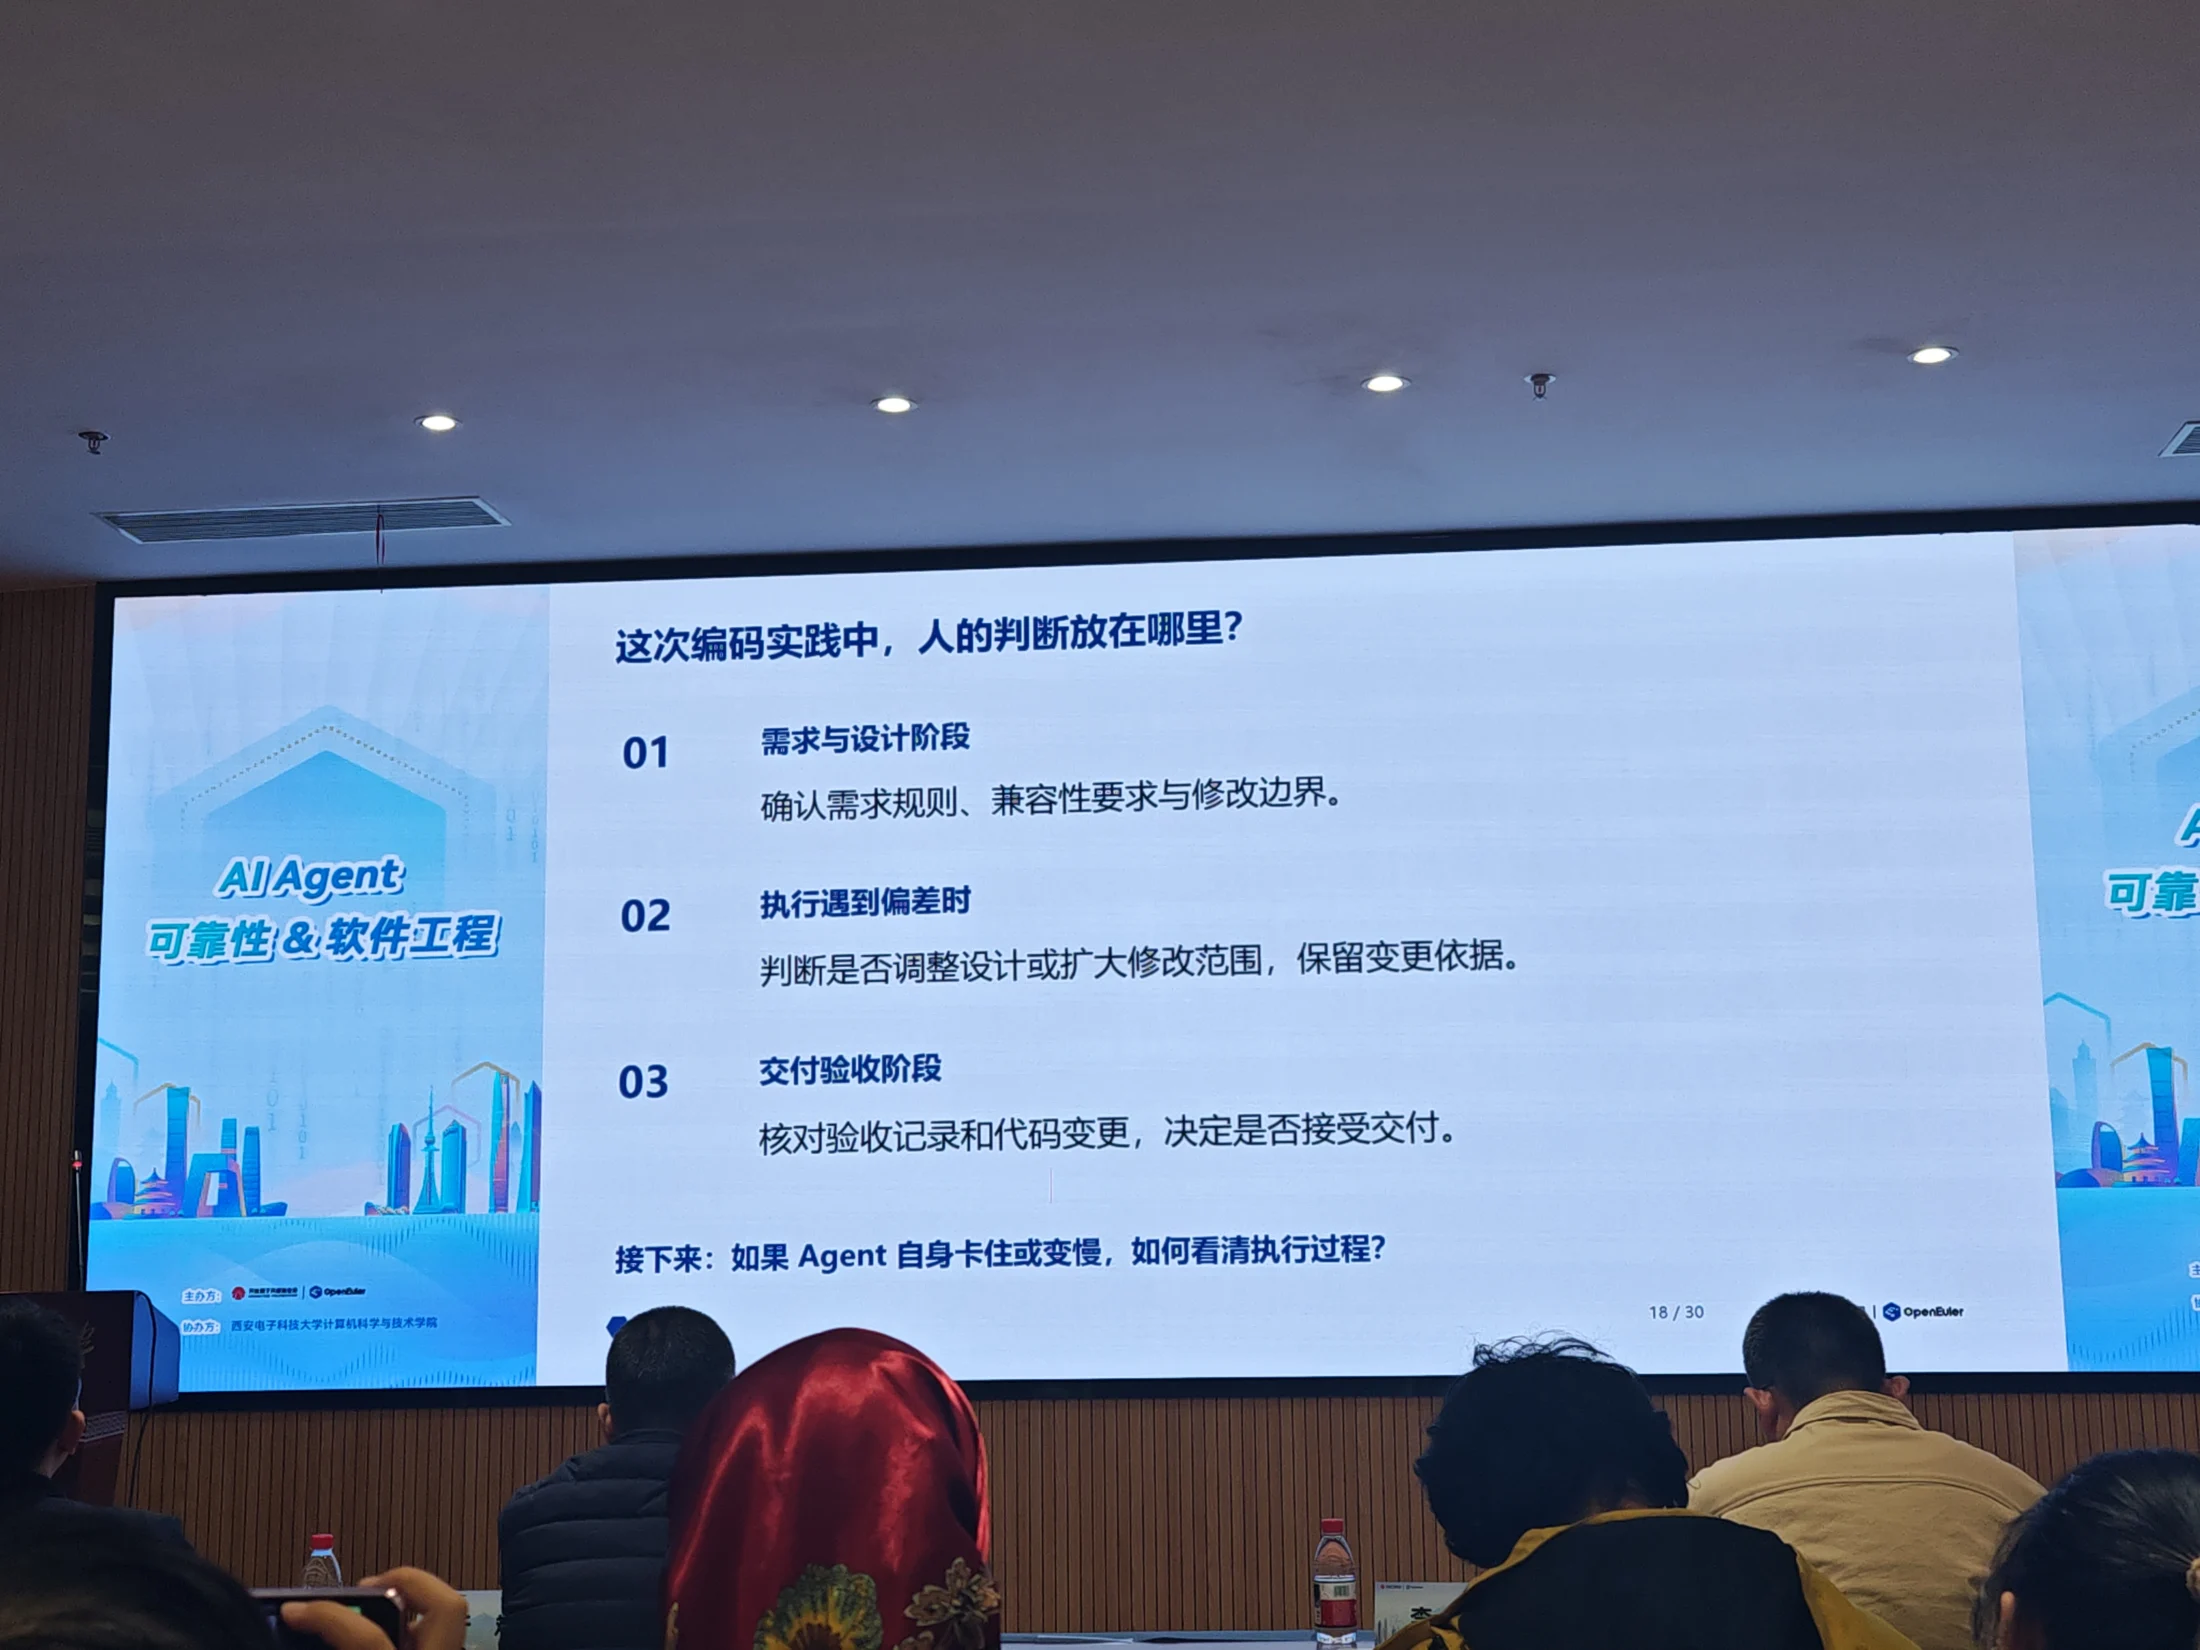
人保留三个判断位置

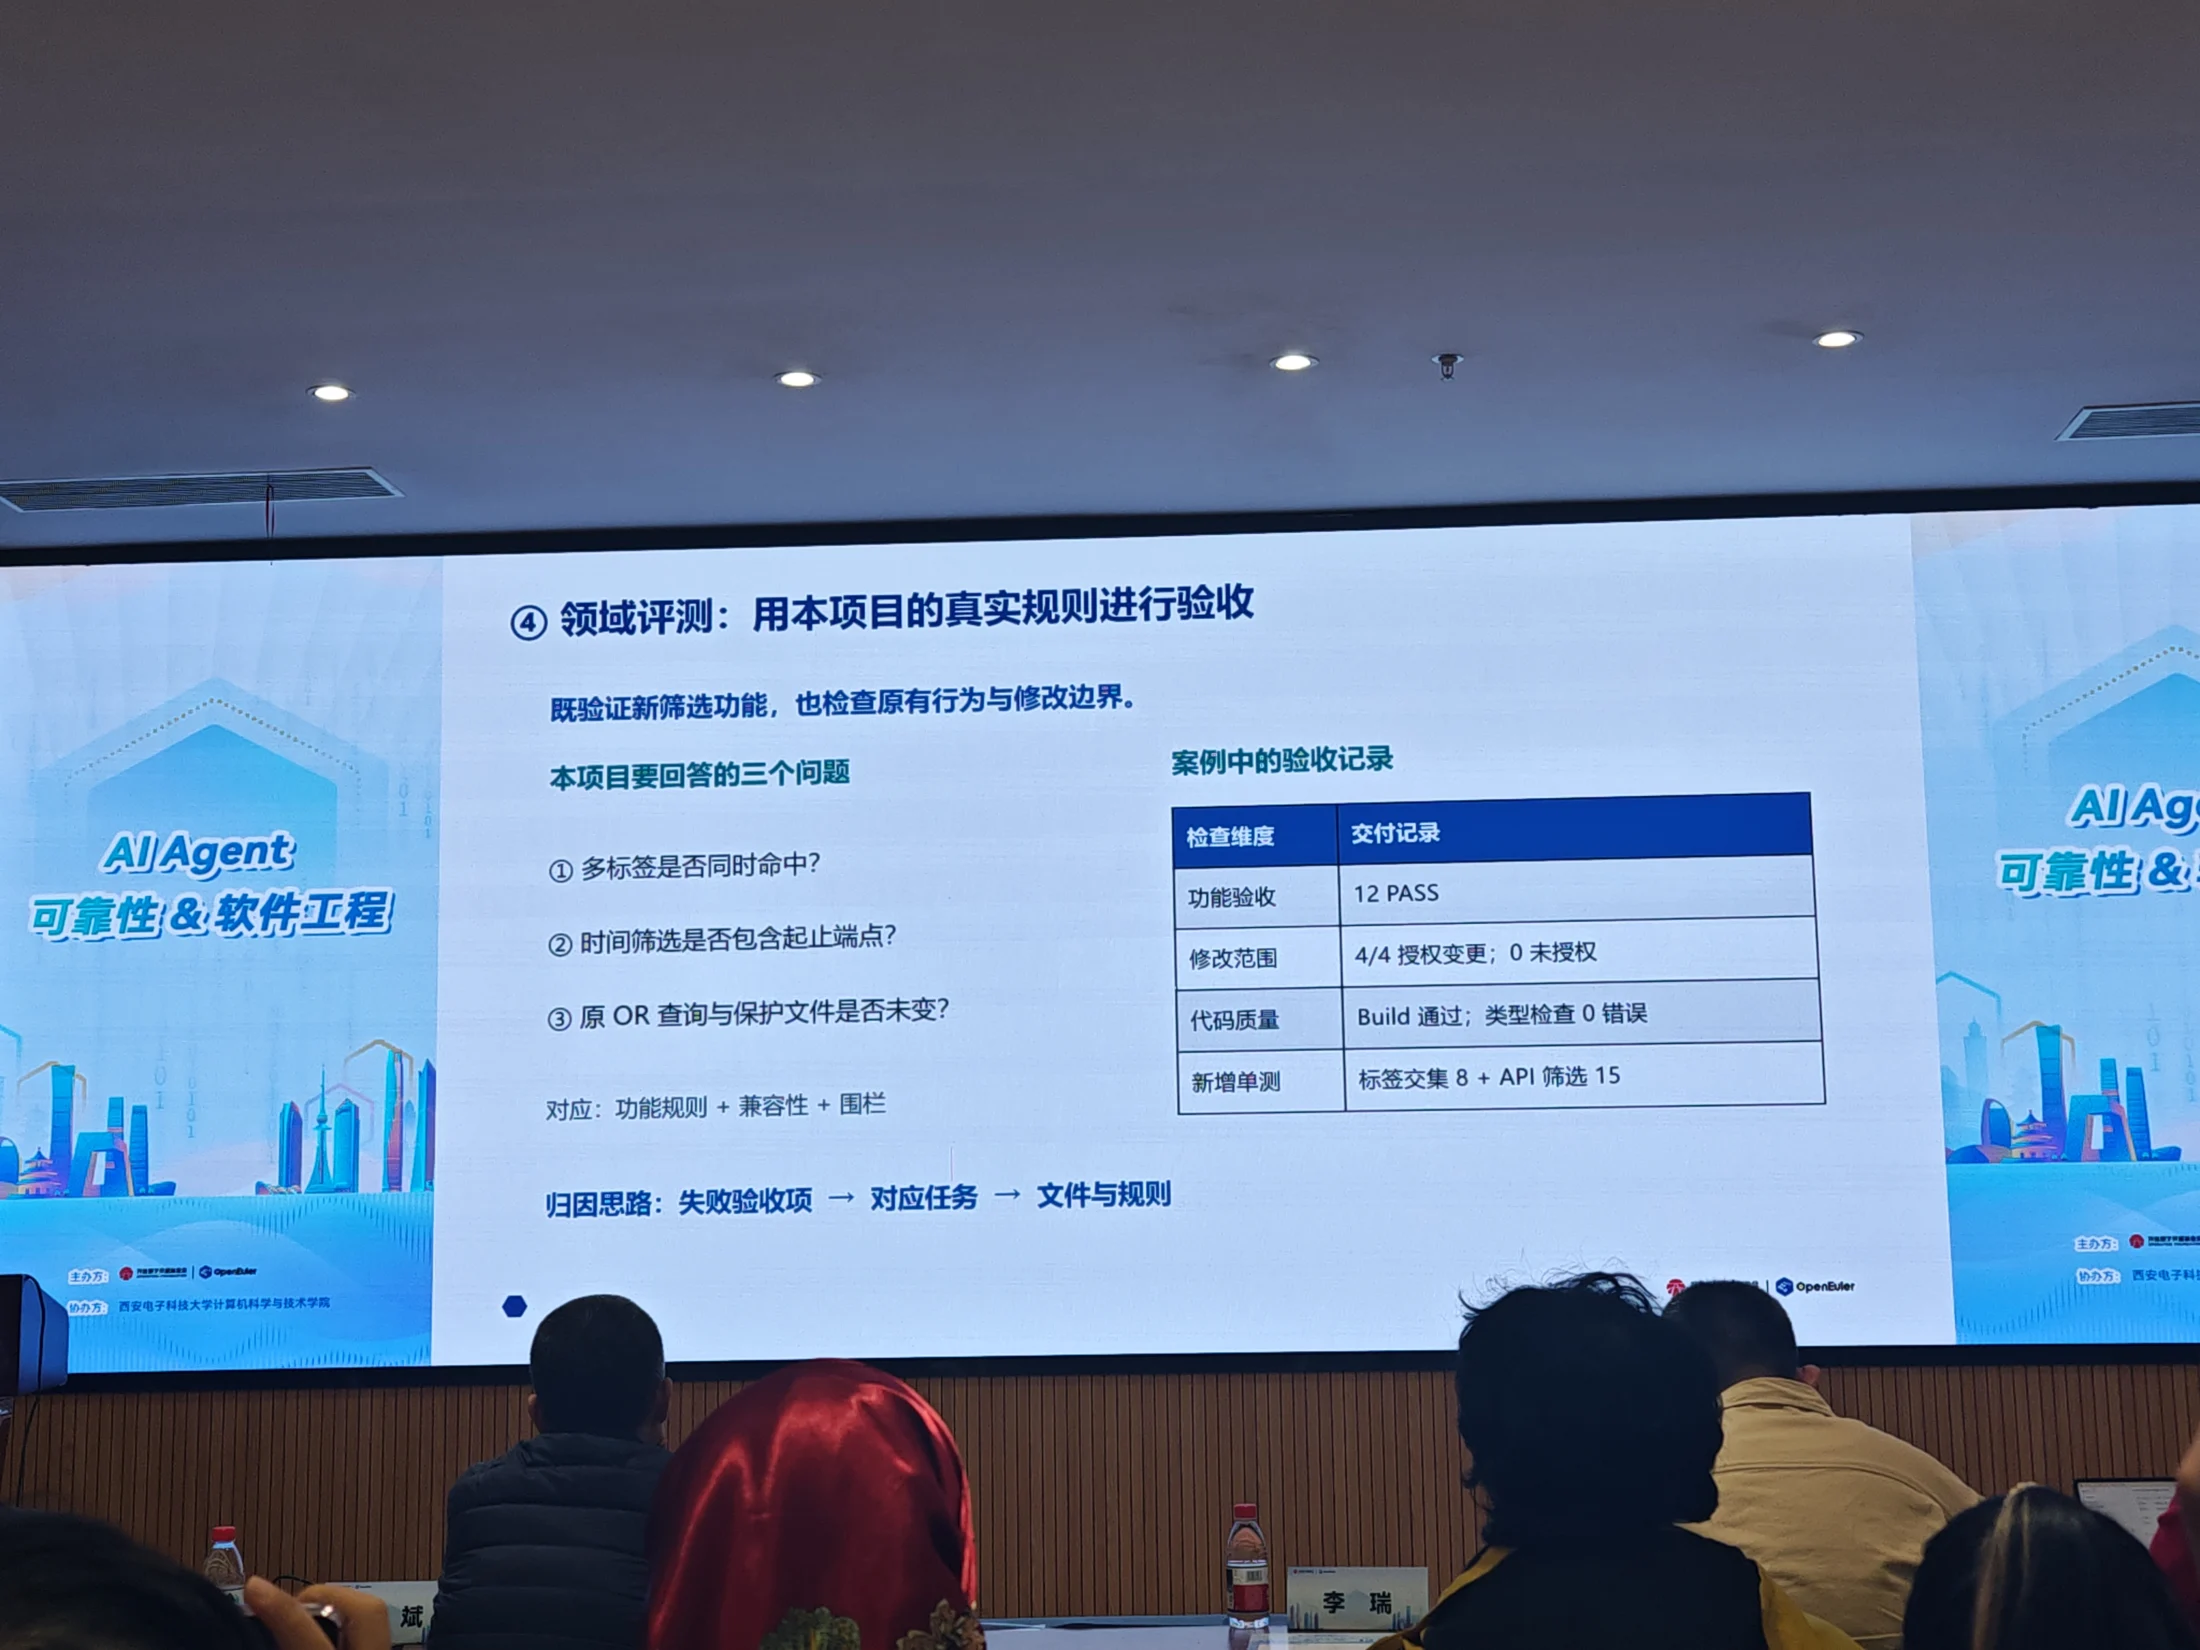
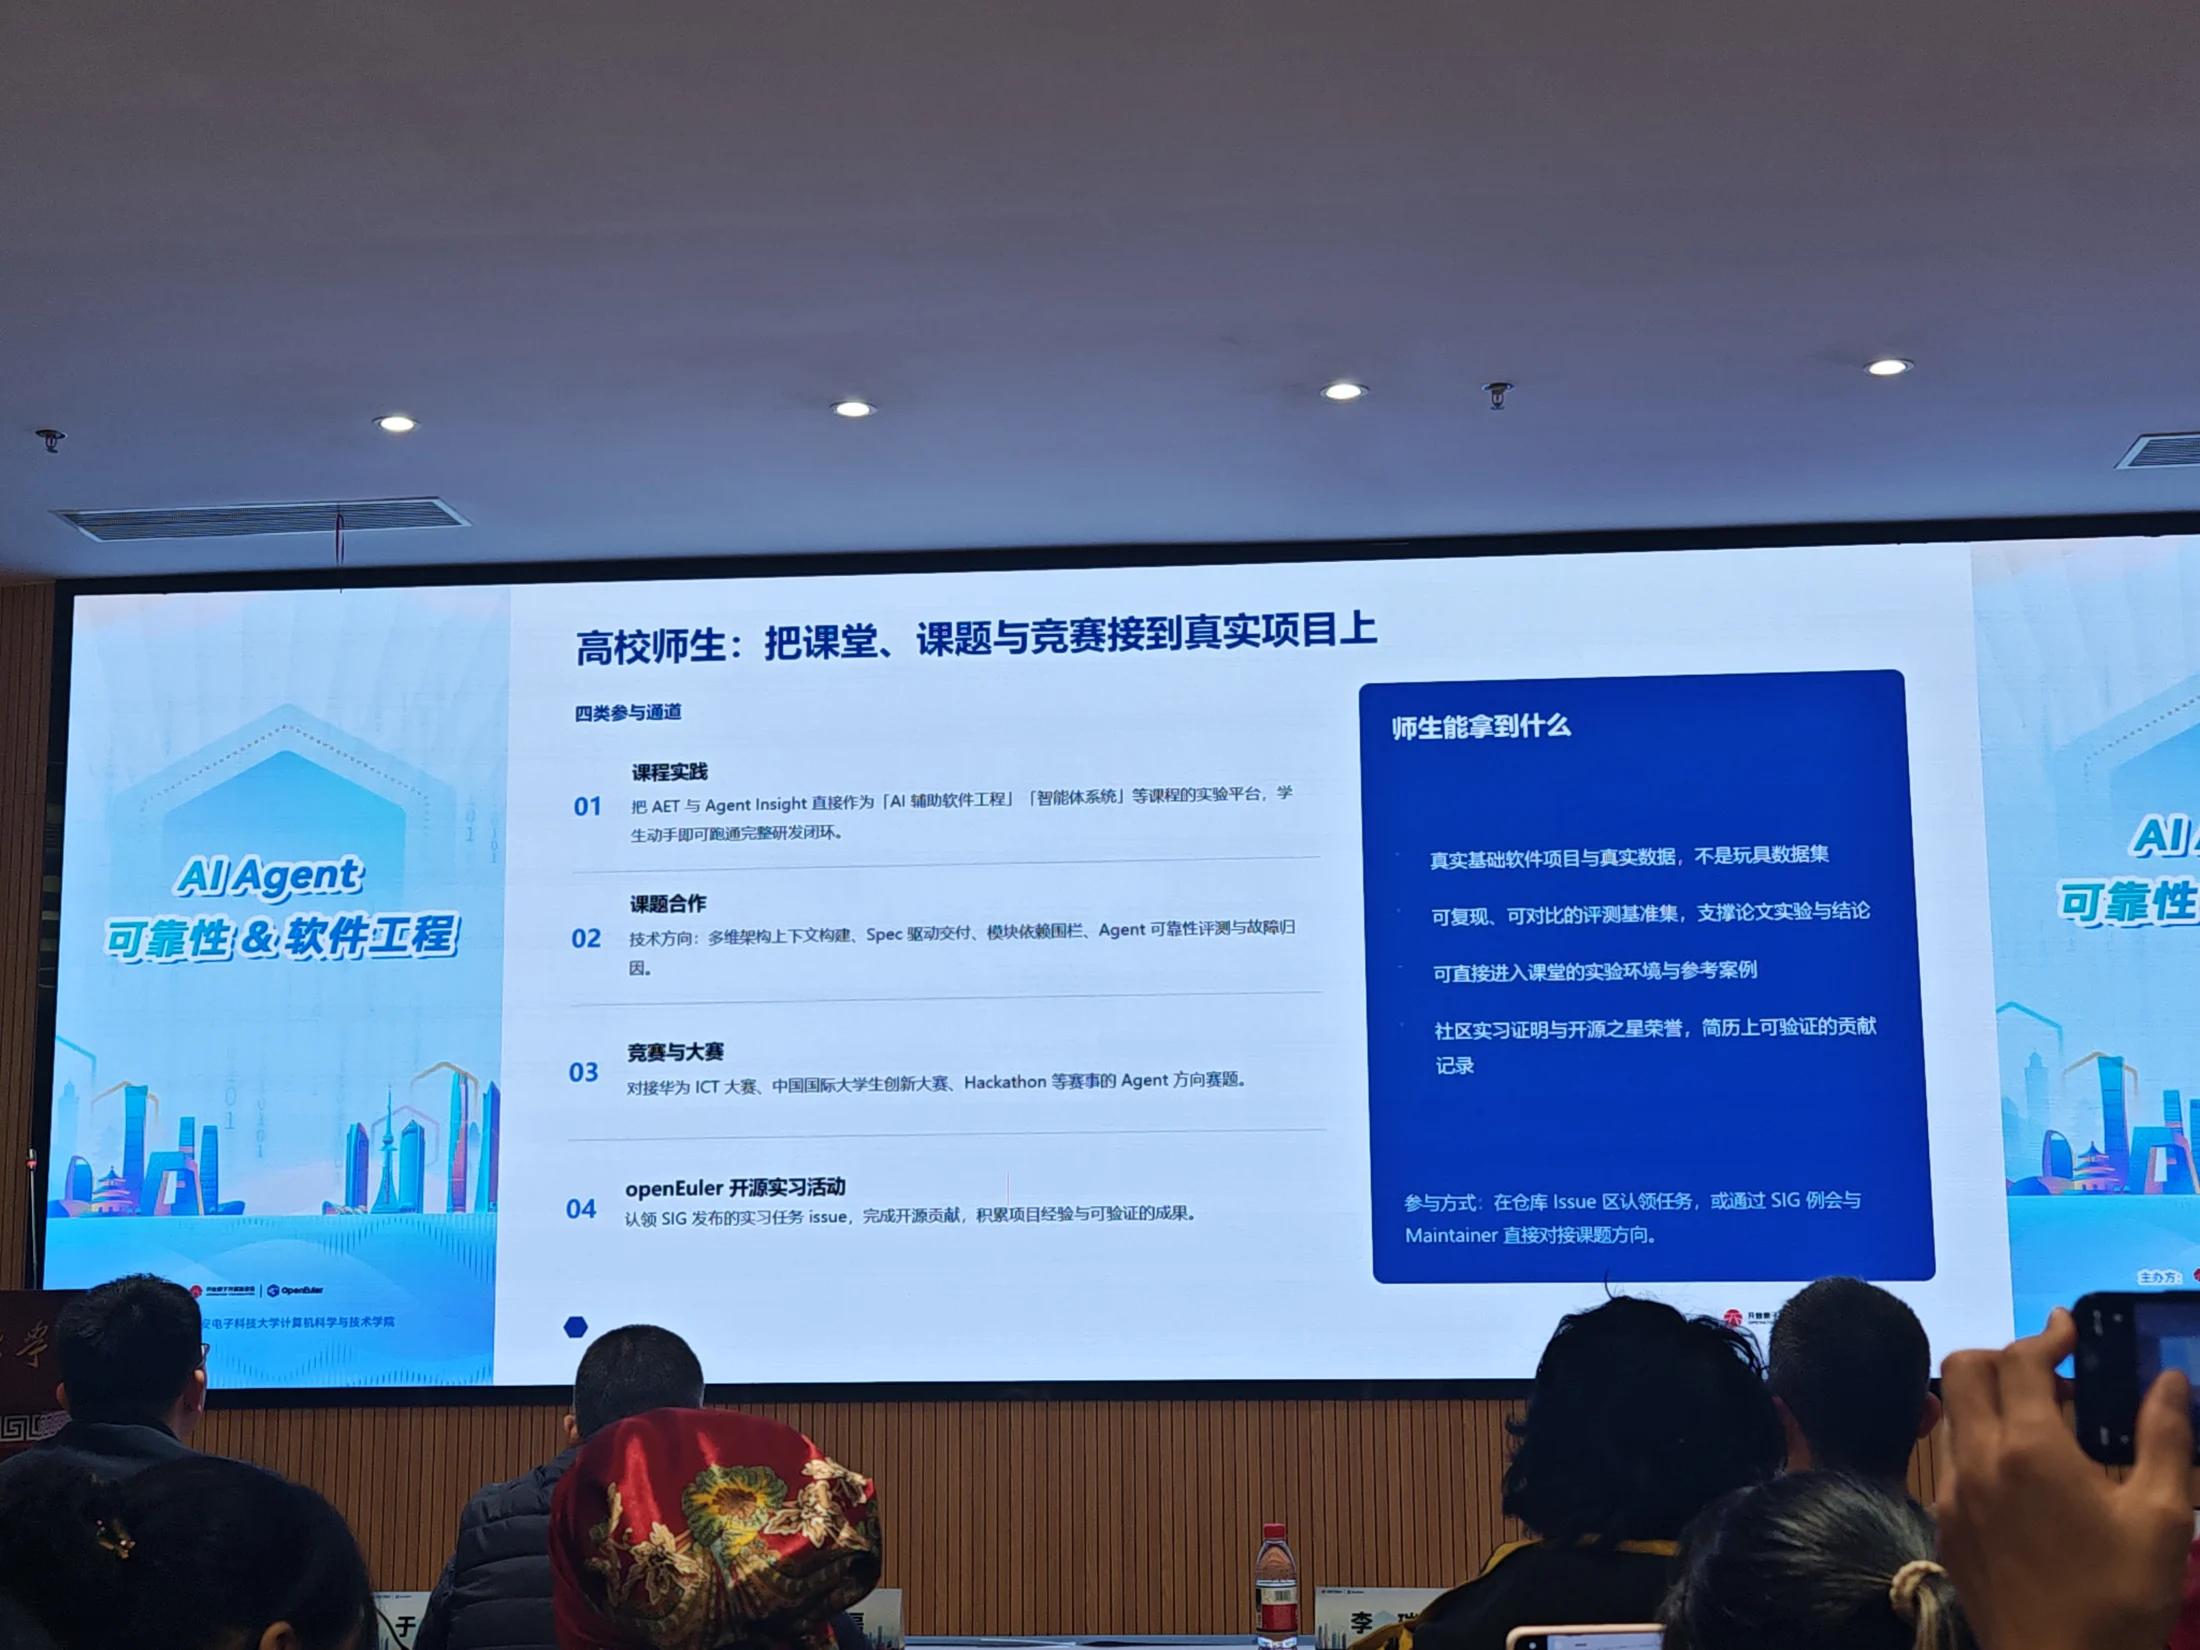
需求设计阶段确认规则与边界;执行受阻时判断是否调整设计或扩大范围;交付阶段核对测试和代码变更后决定是否接受。材料还给出了从 issue、课程、竞赛和 PR 进入开源实践的路径。

查看照片 IMG_20261031_140223.jpg

我最需要改变的是交任务的方法。过去我容易把“帮我做个功能”直接交给 AI,现在应该先交付一份范围明确、可以验收的任务说明,再让它执行。

可观测性也应该从自己的小项目开始:至少能回答它做到了哪一步、改了哪些文件、什么验证失败、为什么重试。只看最终回答,无法判断交付过程是否可靠。

课件展示的效率提升属于特定团队与任务条件下的实践报告。我不能把它直接当作自己的效率预期;应该记录自己项目中耗时、返工和缺陷的变化。

即使 Agent 说完成了,我能拿出哪些独立的交付证据?

  1. 给一个已有项目写任务说明

    写出目标、输入输出、允许修改的文件、禁止修改的部分与验收用例,交付一份 task.md。

  2. 记录一次完整执行

    按任务保存工具调用、测试结果、错误和修复记录,用唯一任务 ID 串联,形成一份可回放日志。

  3. 用真实规则验收

    同时检查新功能、旧功能和修改范围。提交前自己阅读 diff,并记录接受或退回的理由。

展开这场的 13 张现场照片

照片保持原始画面比例;点击放大,放大后可在新标签打开图片继续缩放。原始文件保留在原文件夹。
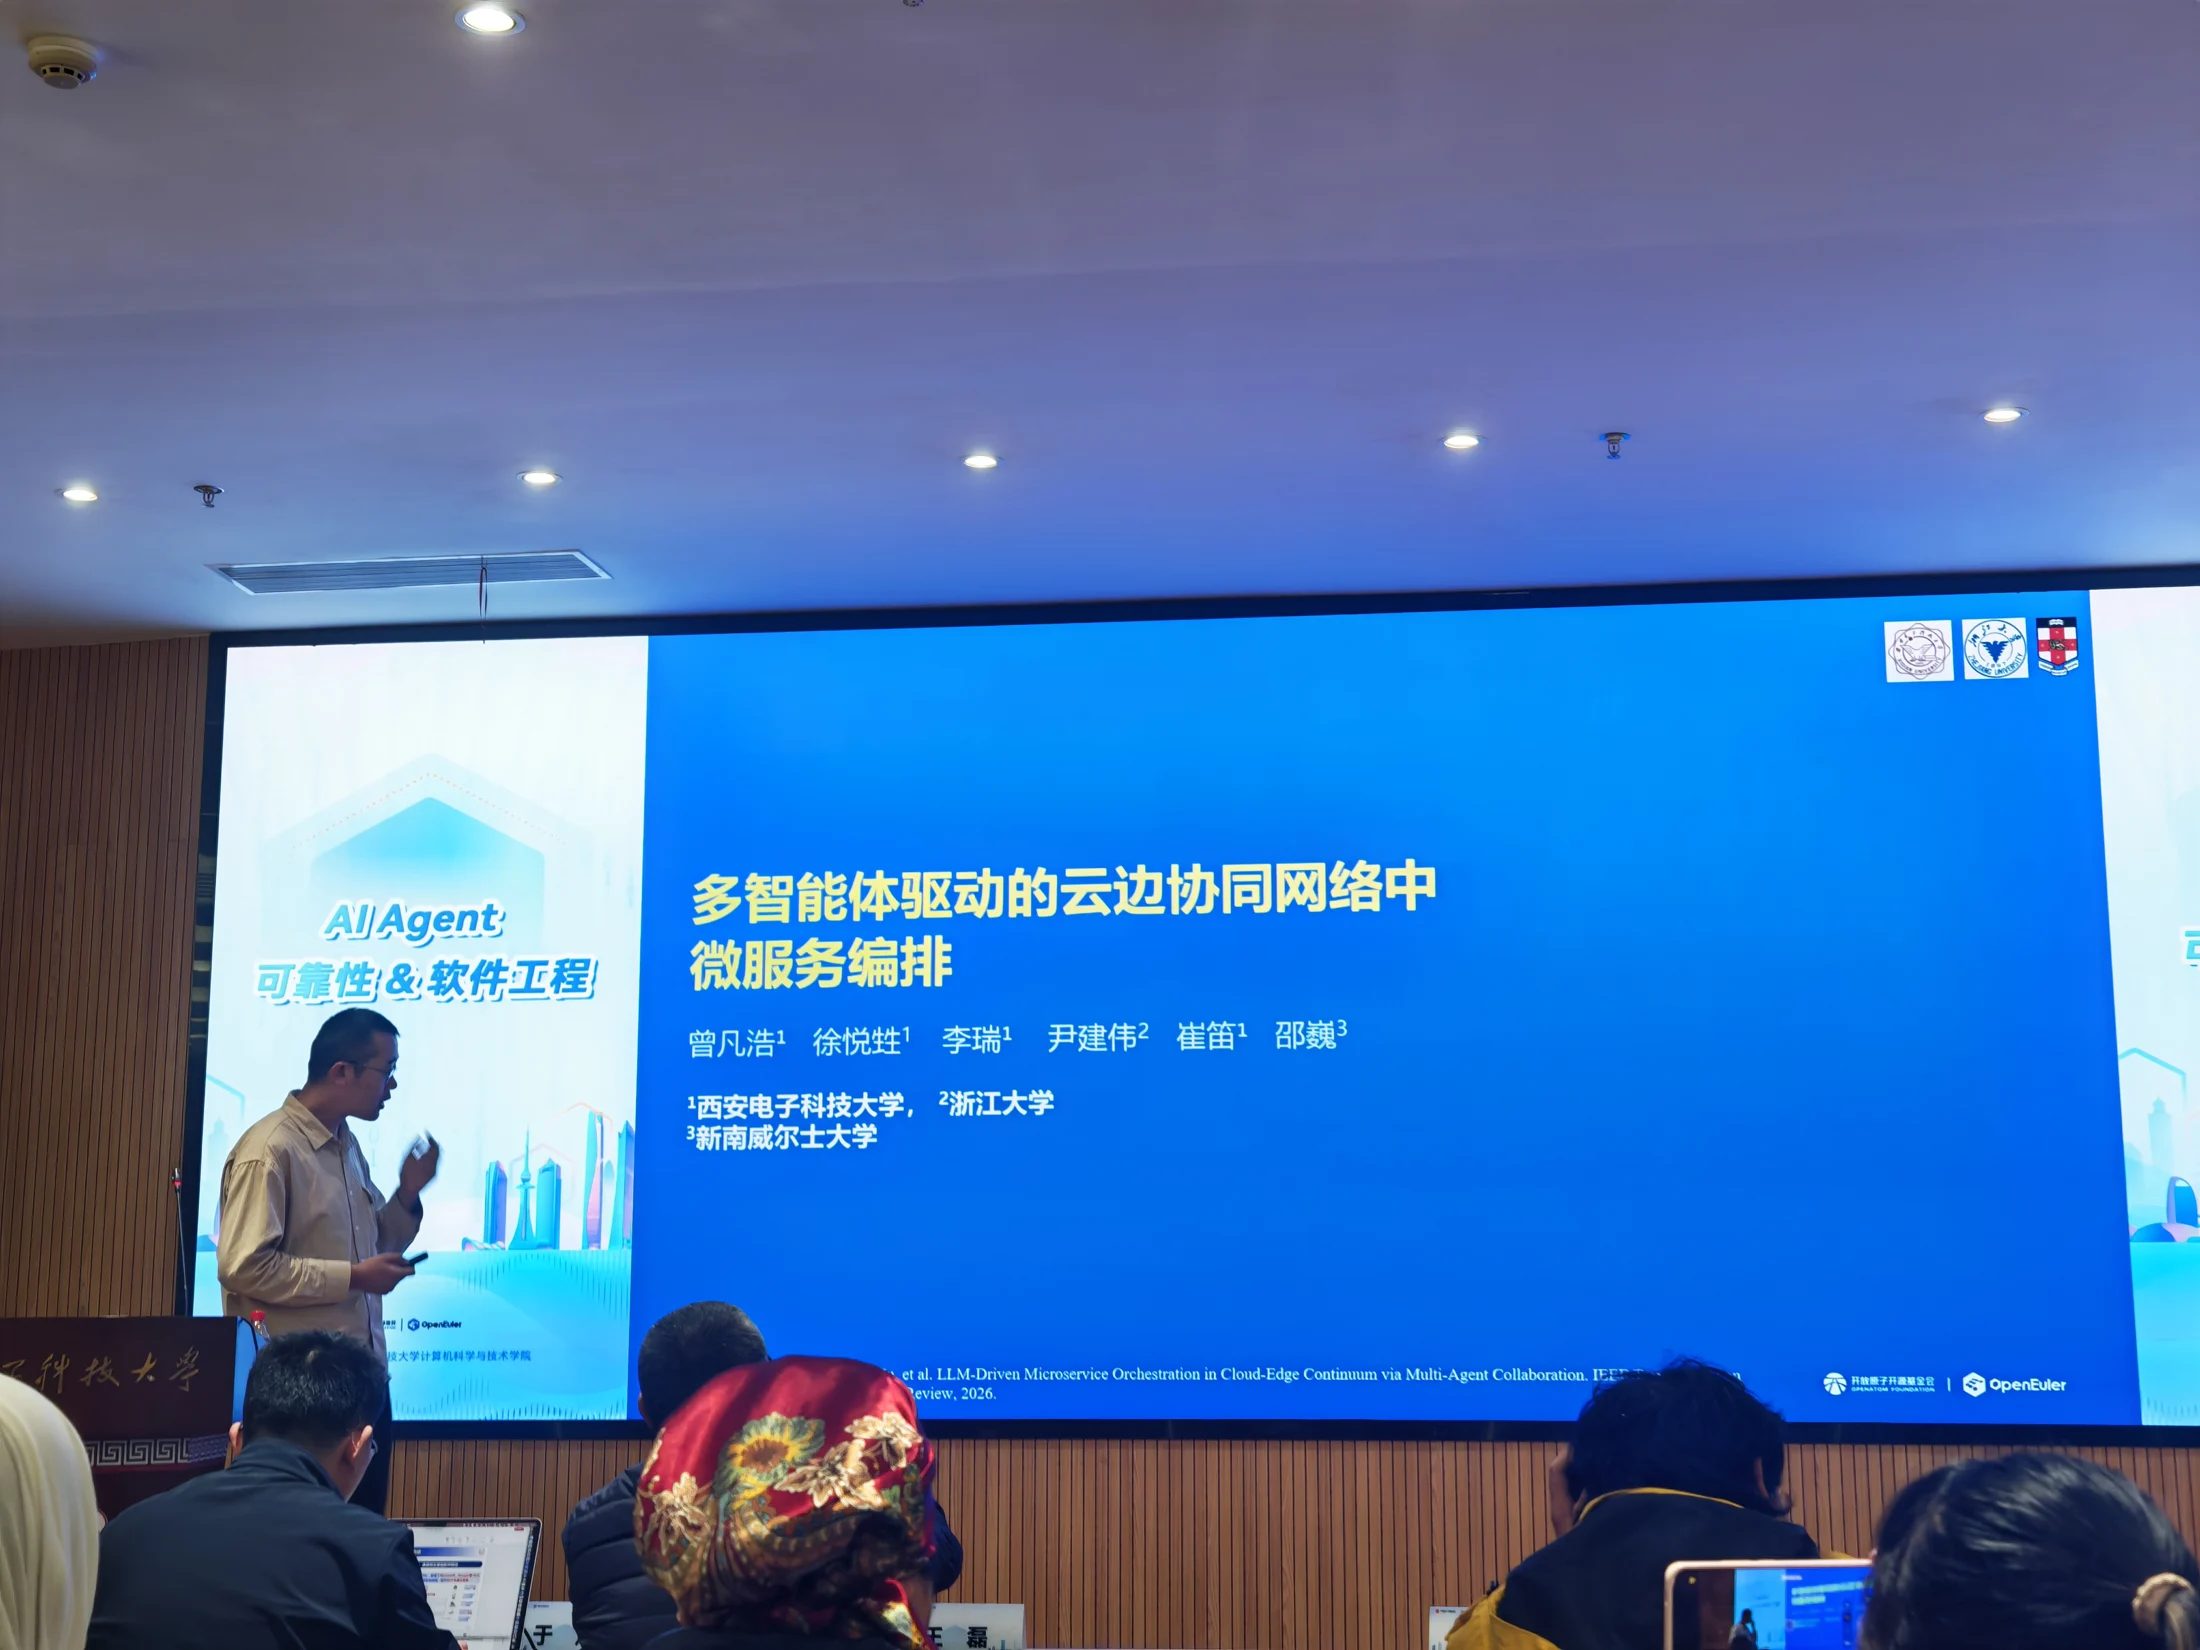
多智能体协同运维概念示意图

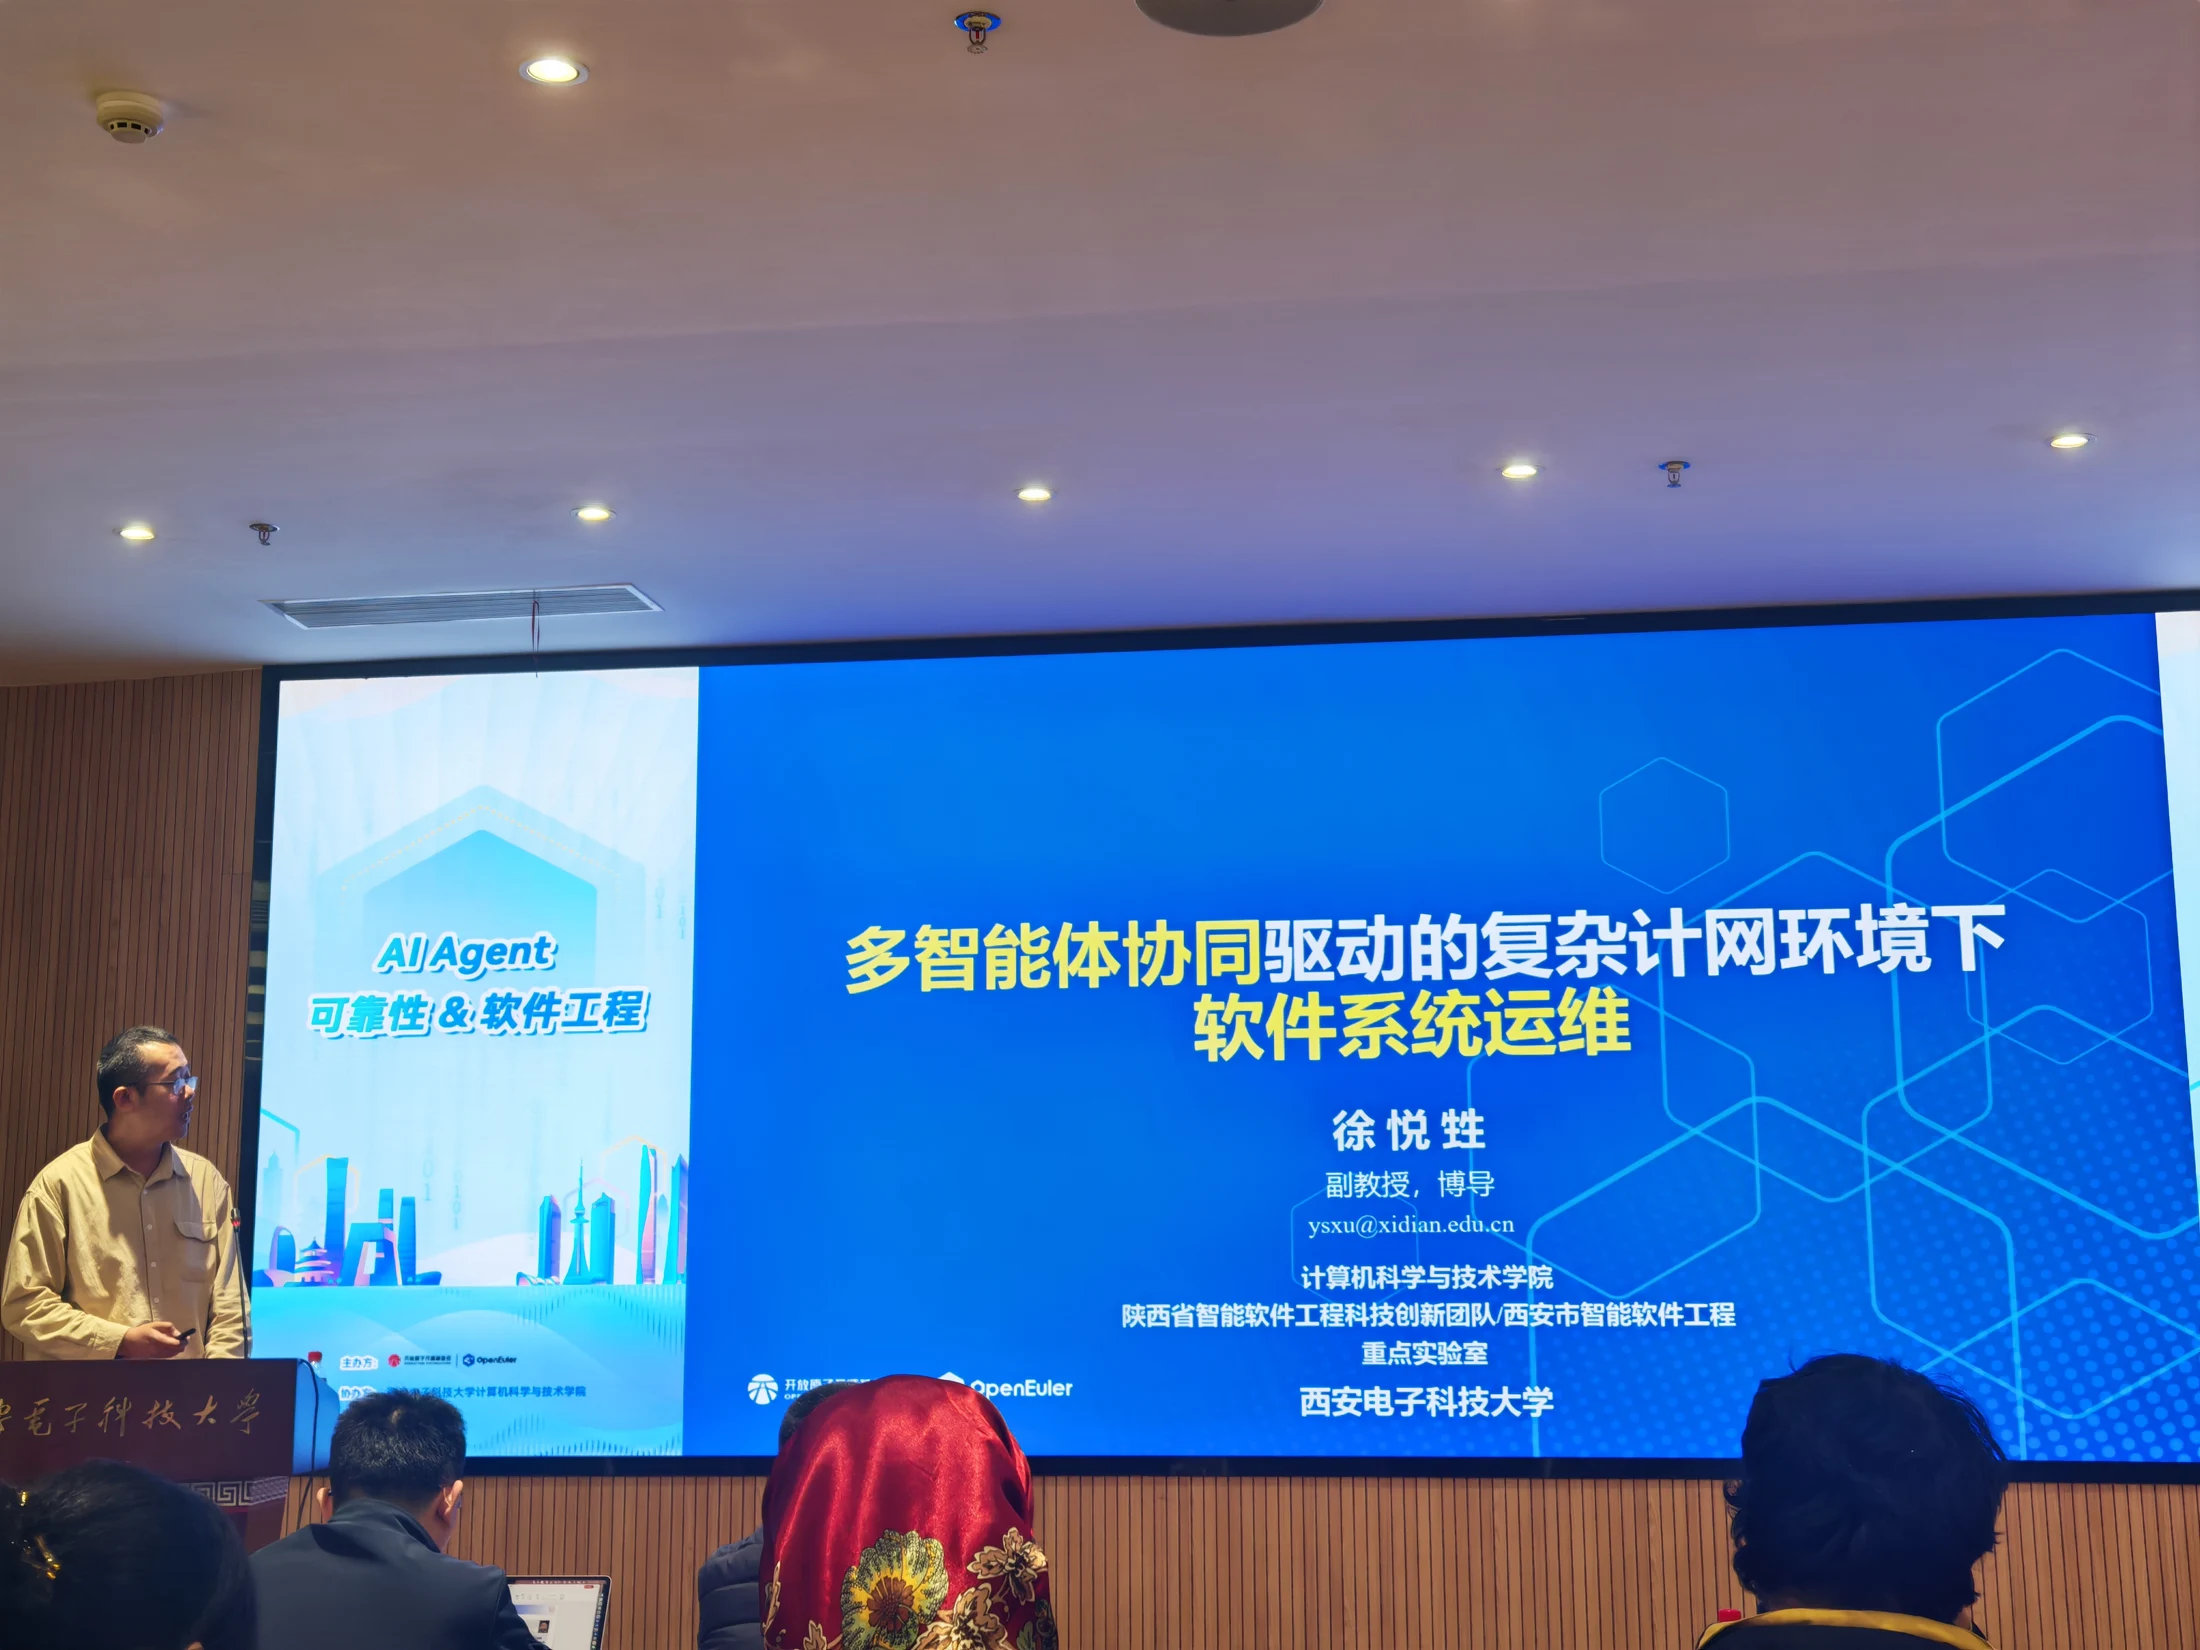
徐悦甡
西安电子科技大学计算机科学与技术学院副教授、博导

14:20–14:55
议程时间,以会议海报为准

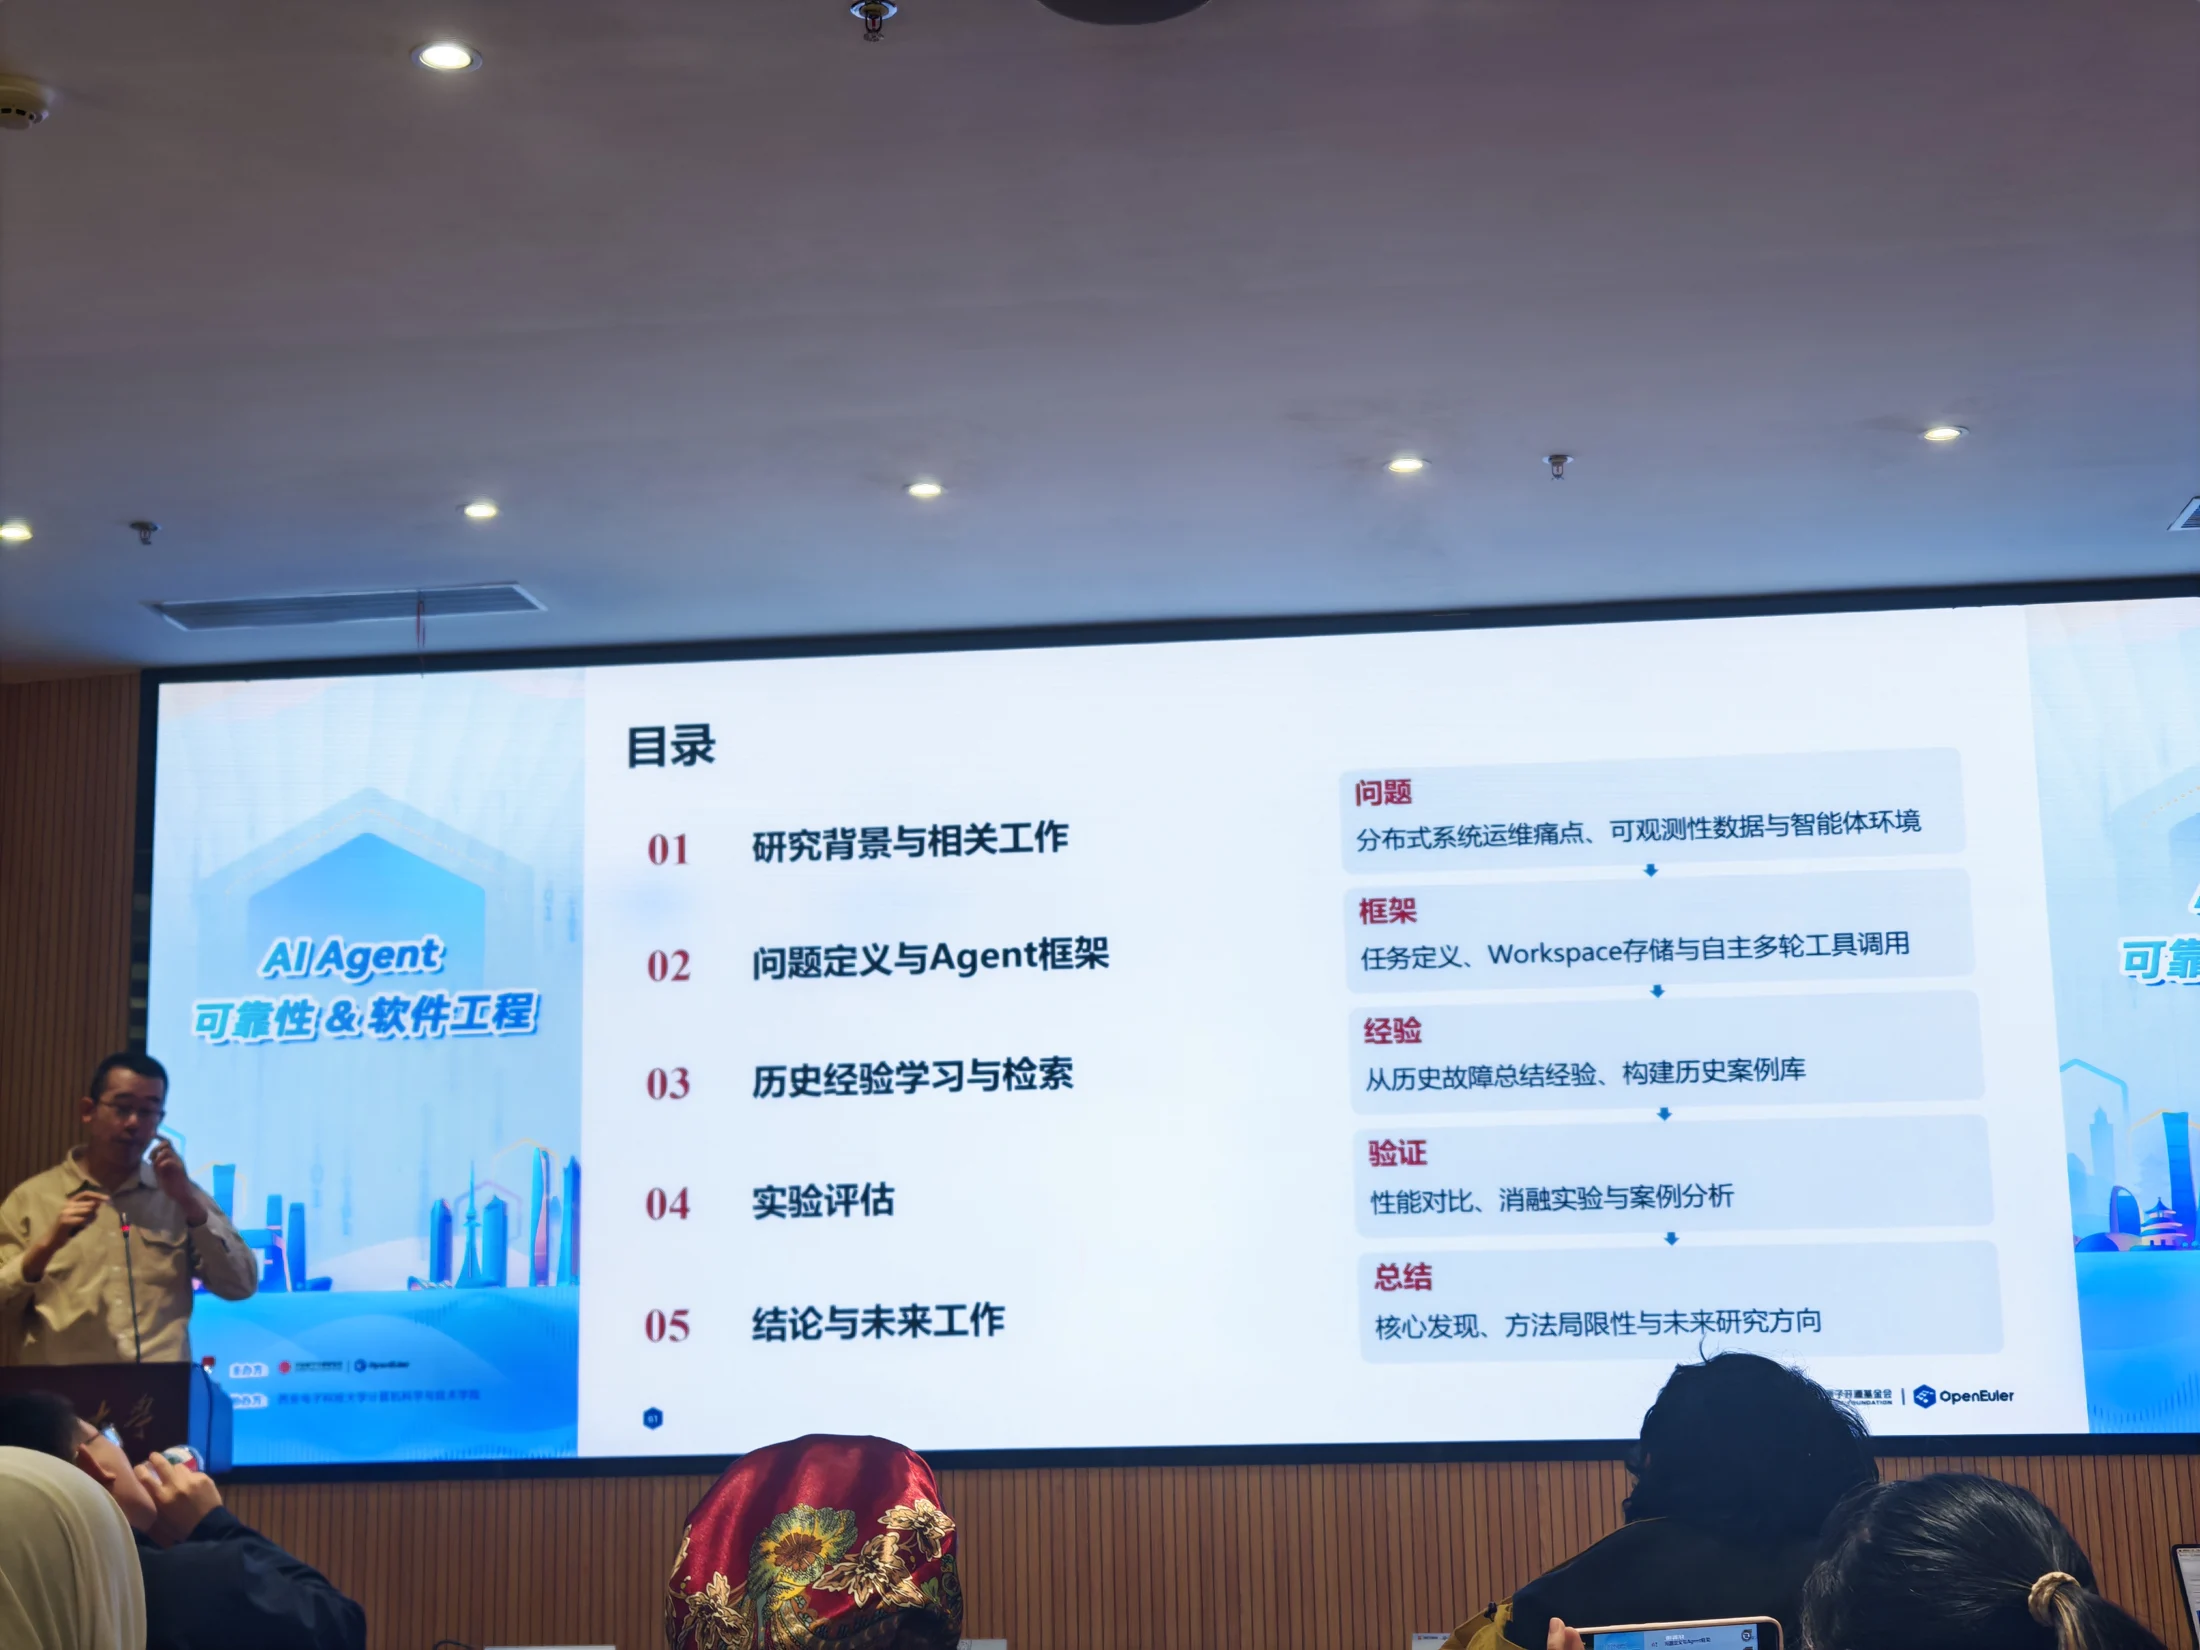
多智能体协同驱动的复杂计网环境下软件系统运维

先保证方案可执行,再比较方案有多好。

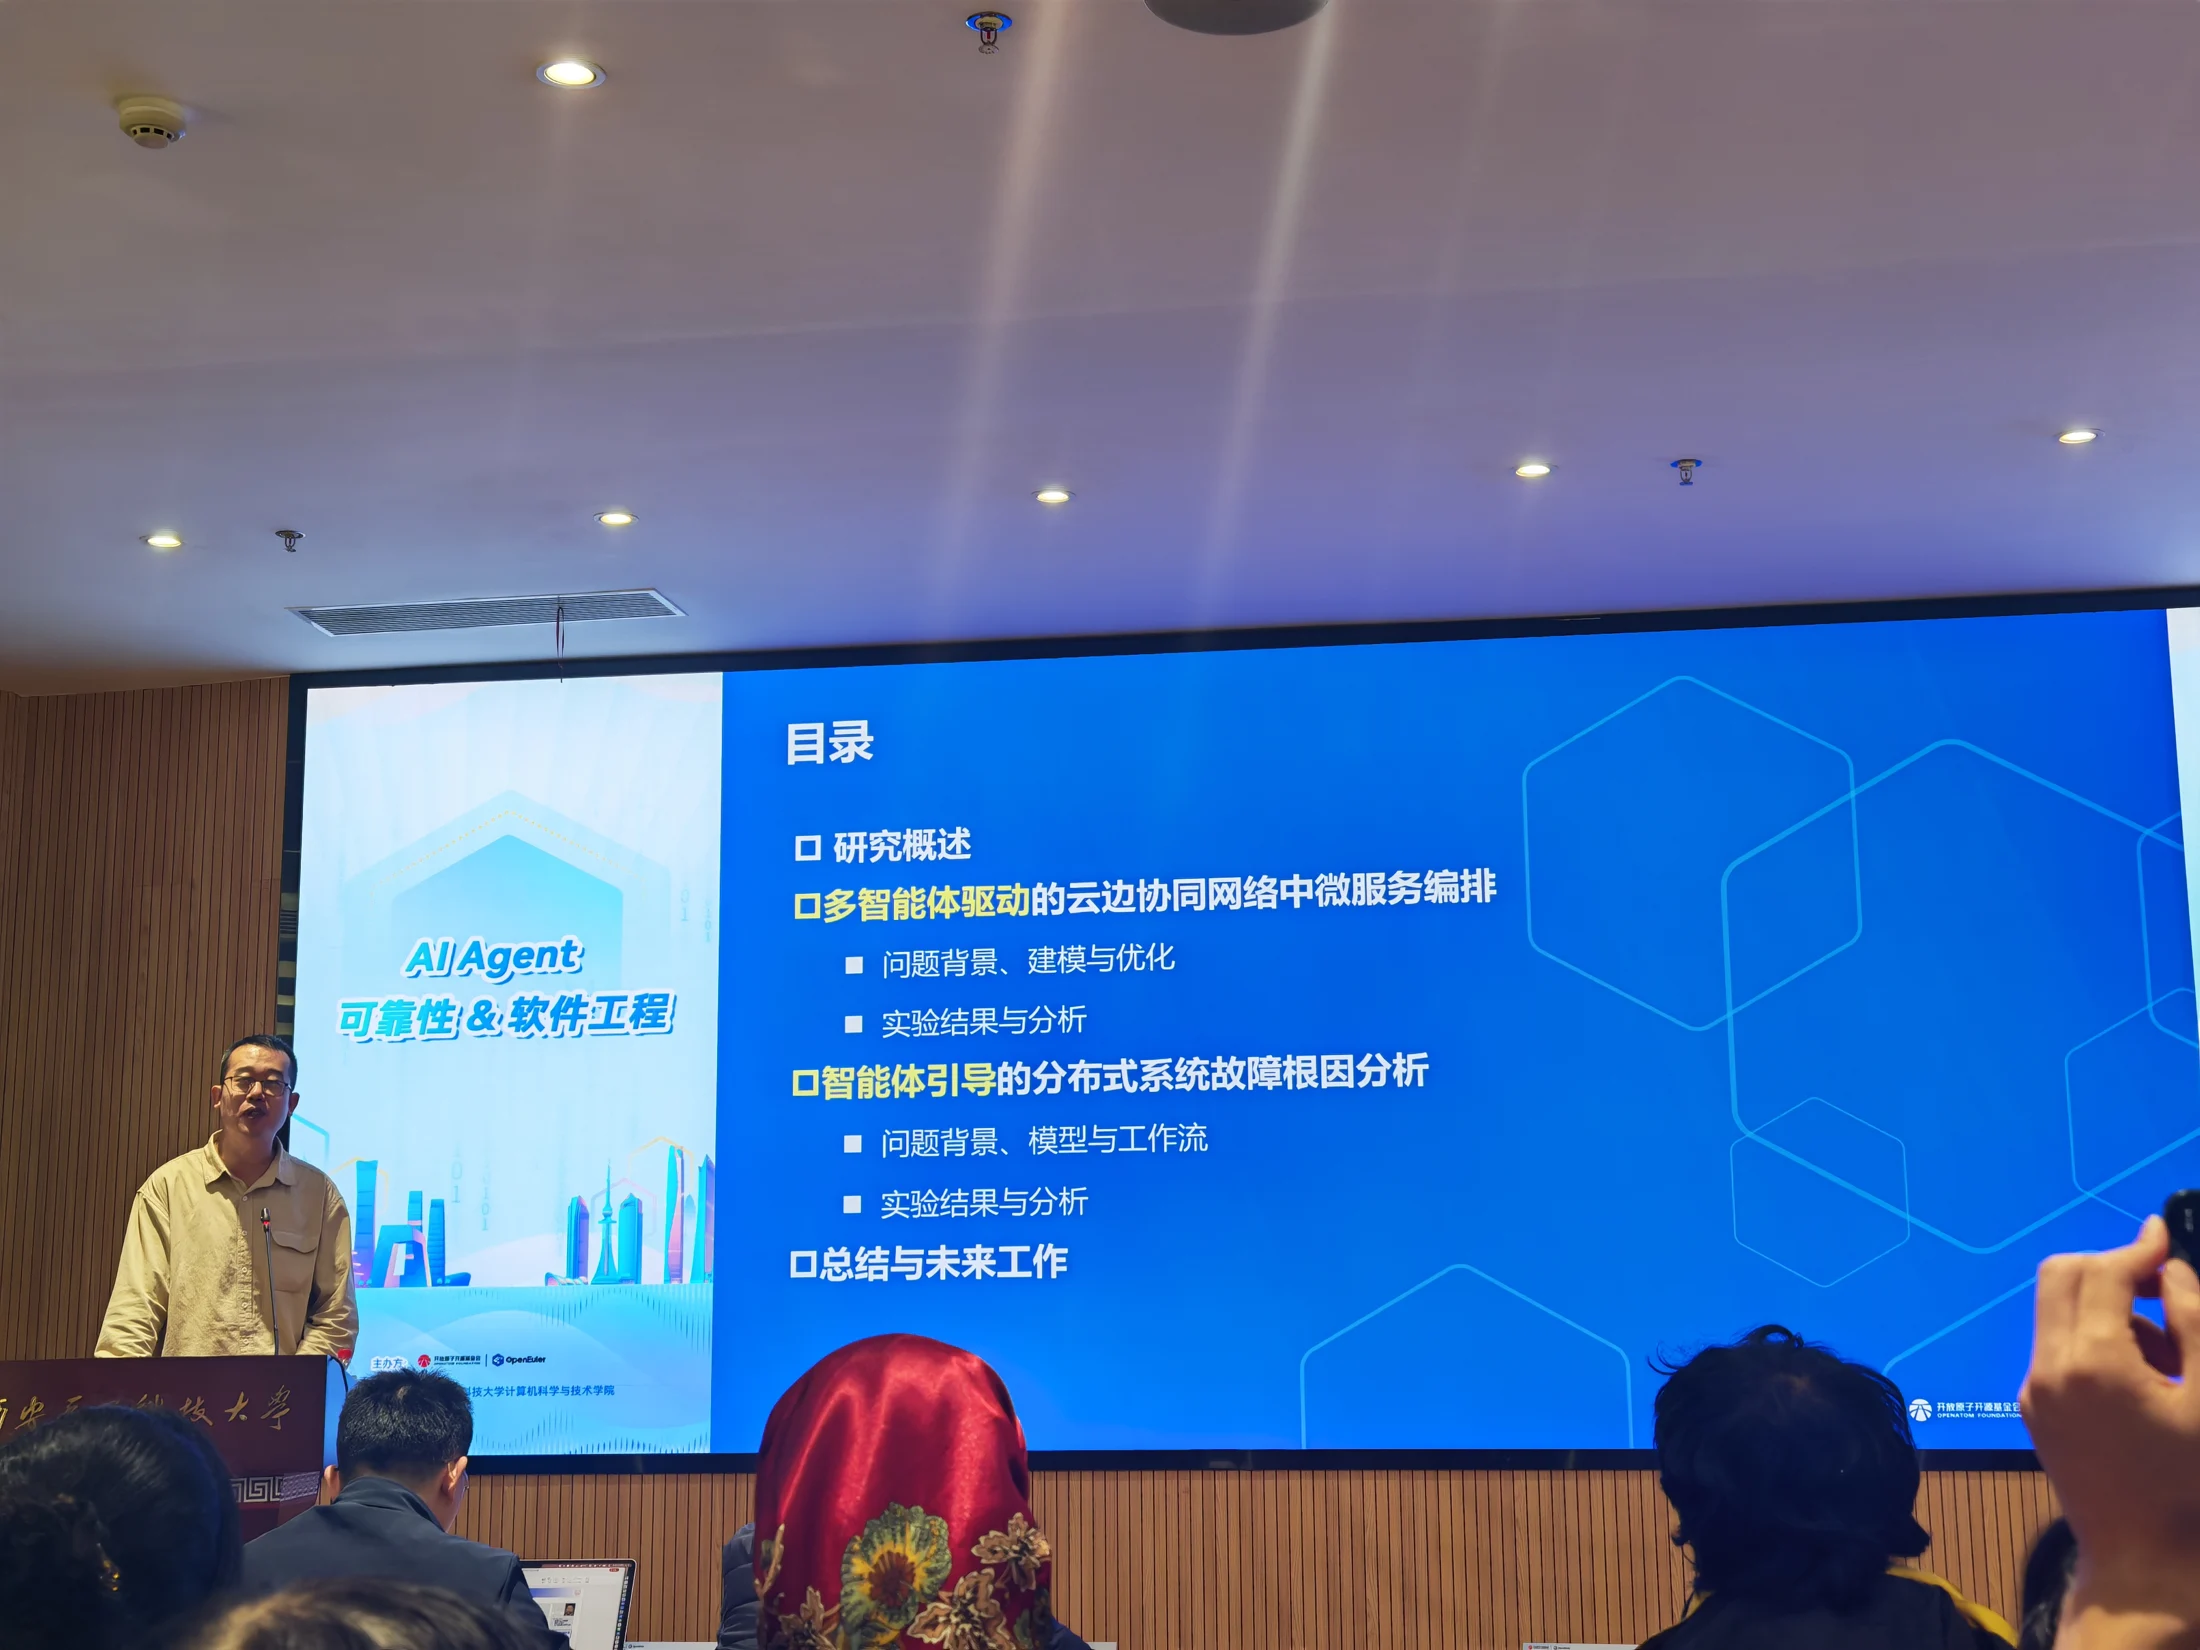
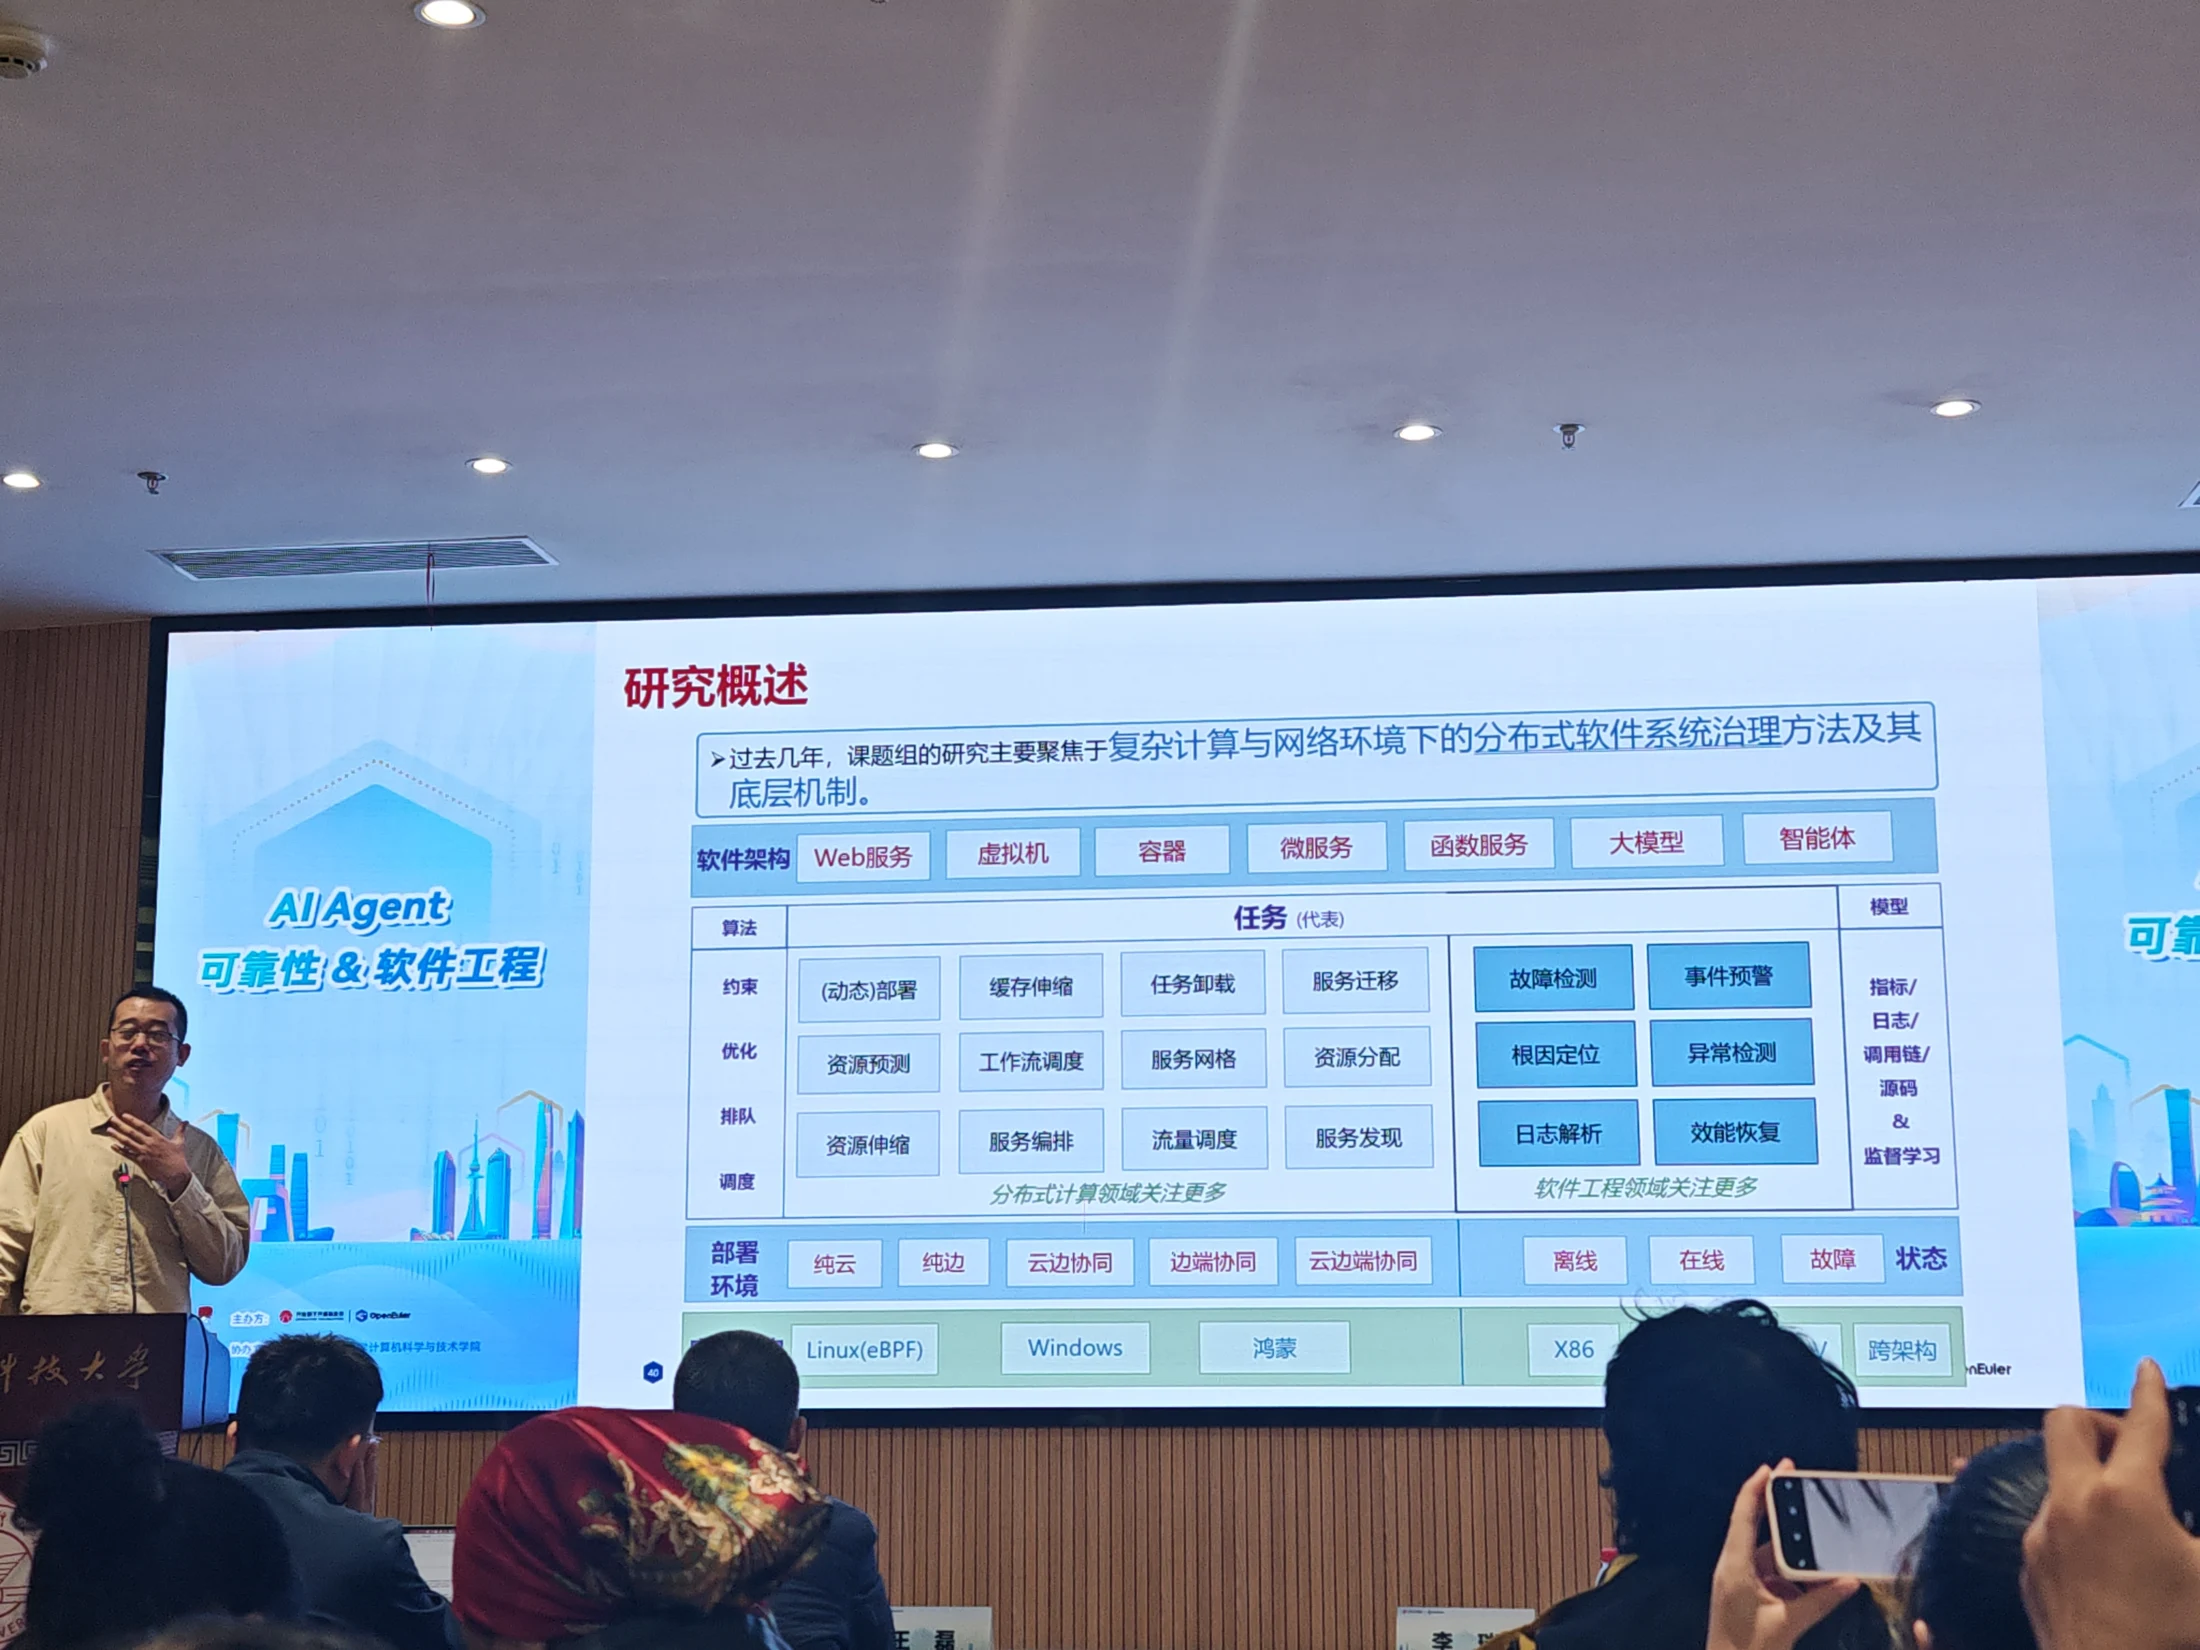
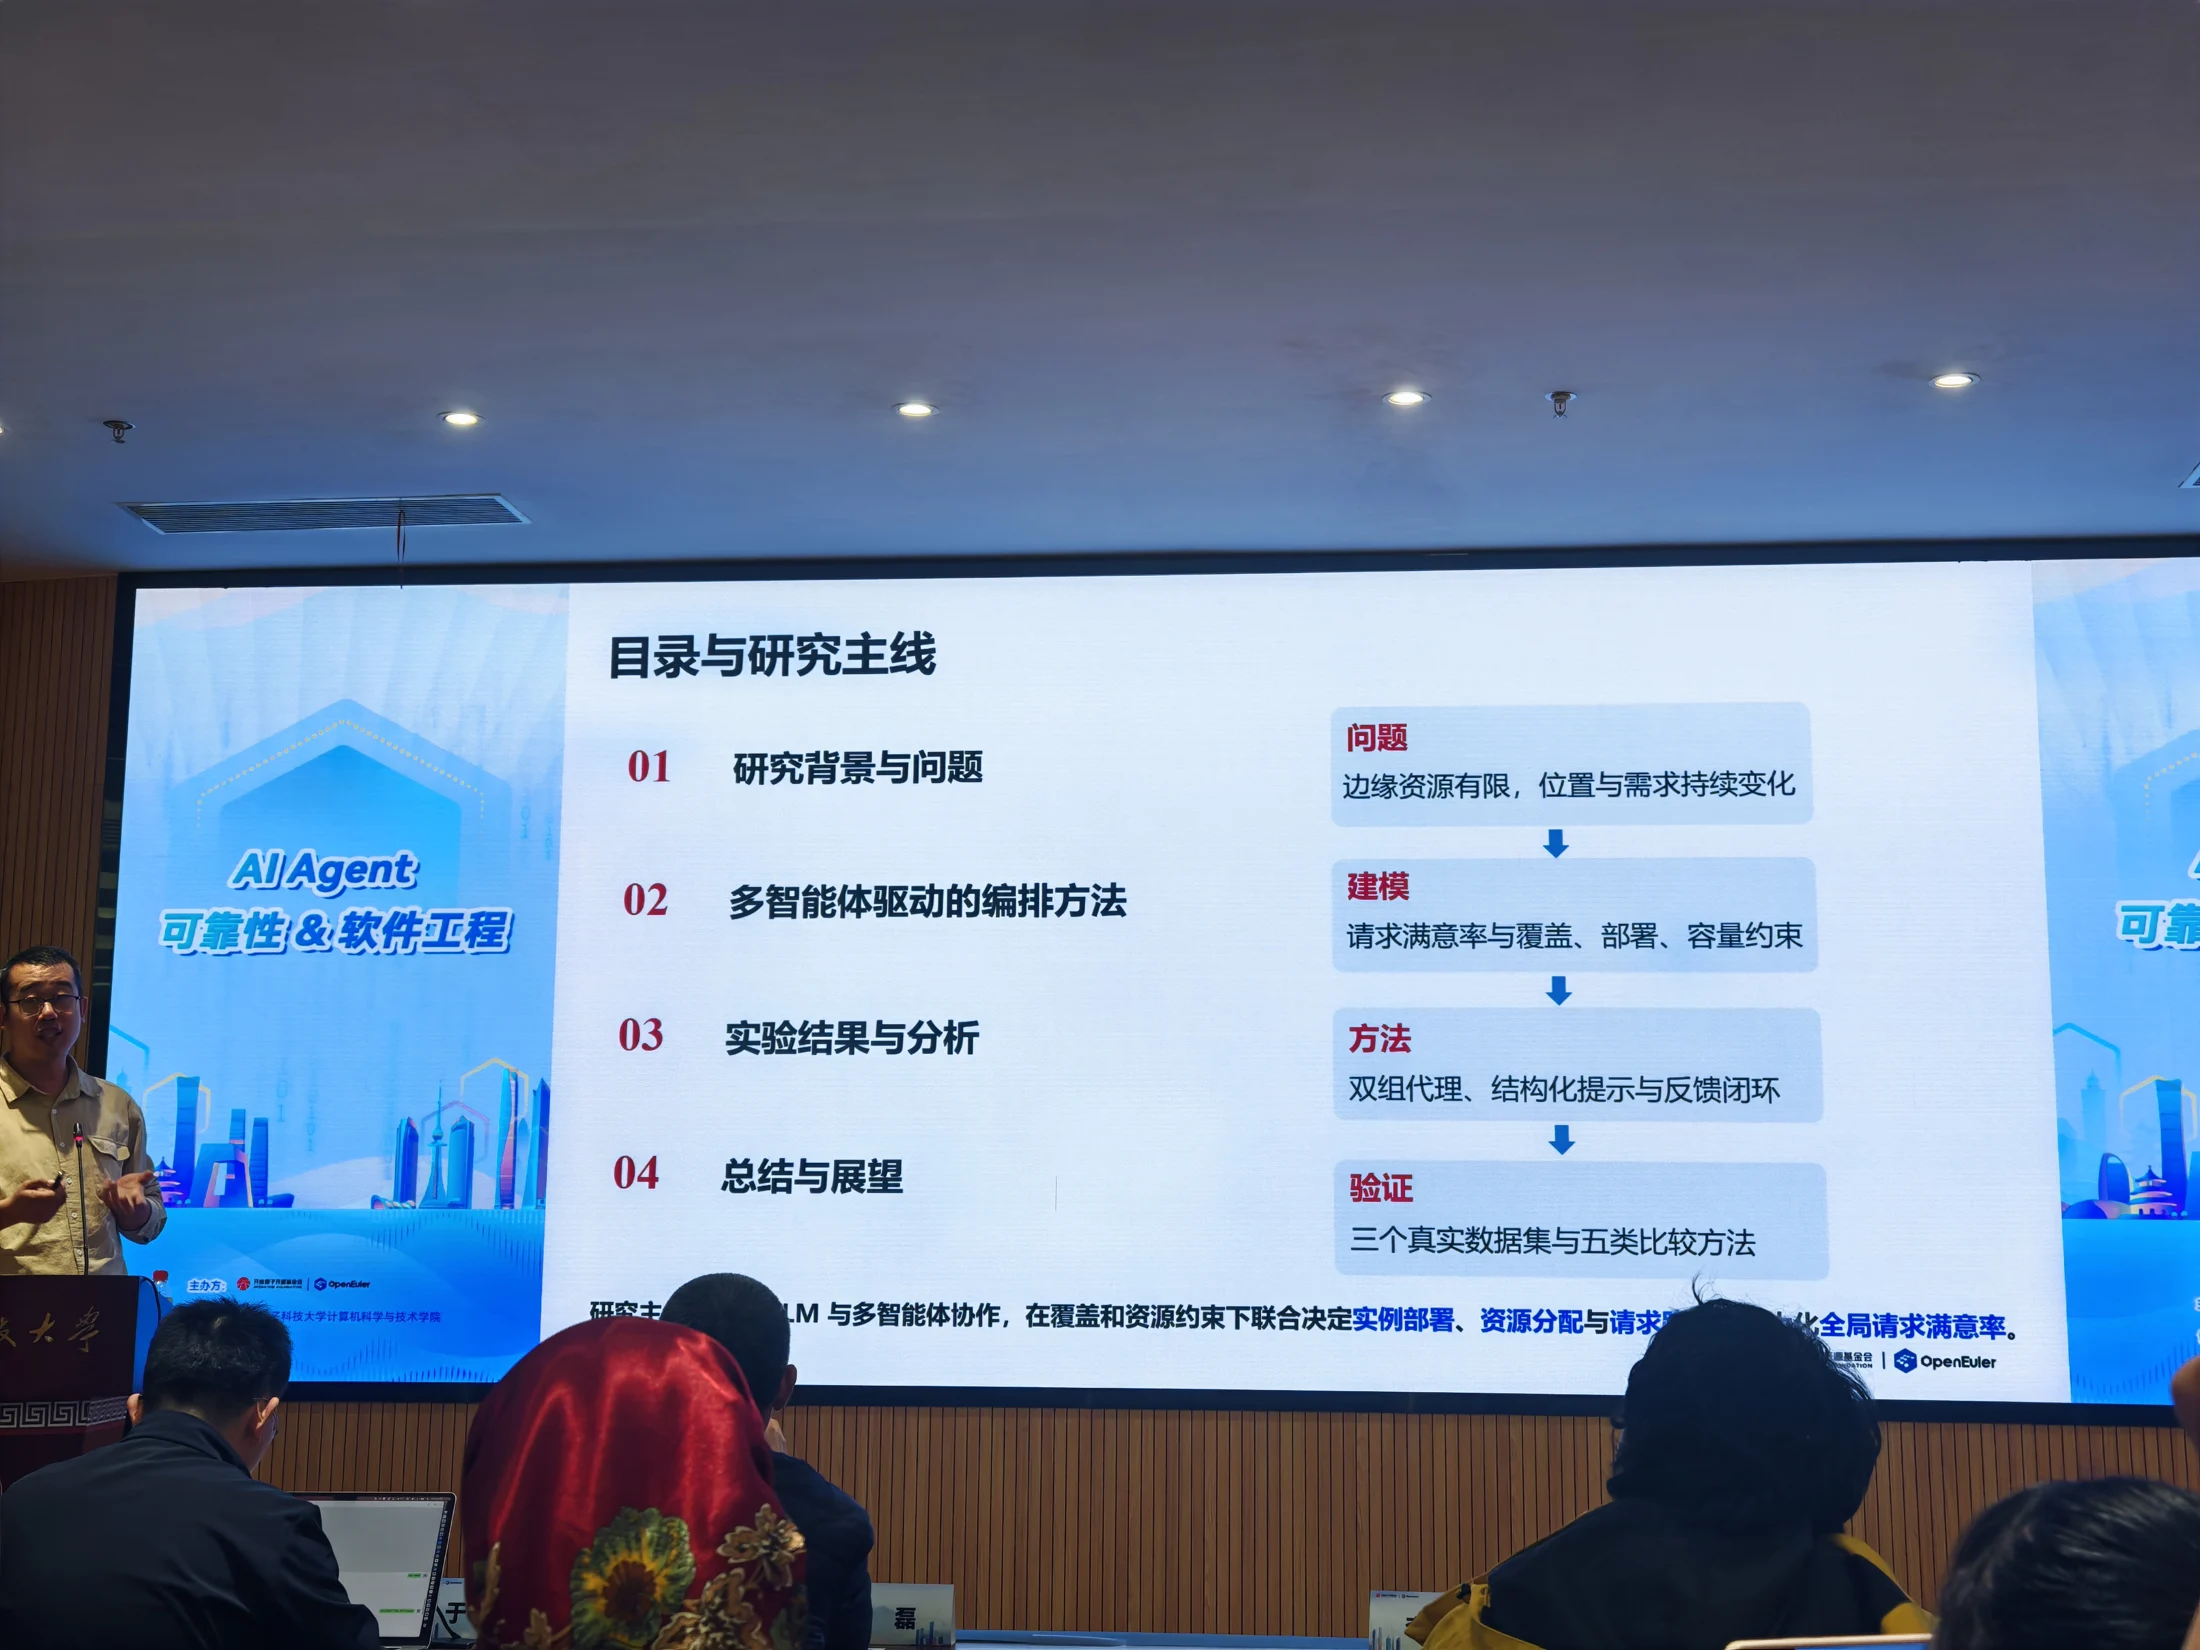
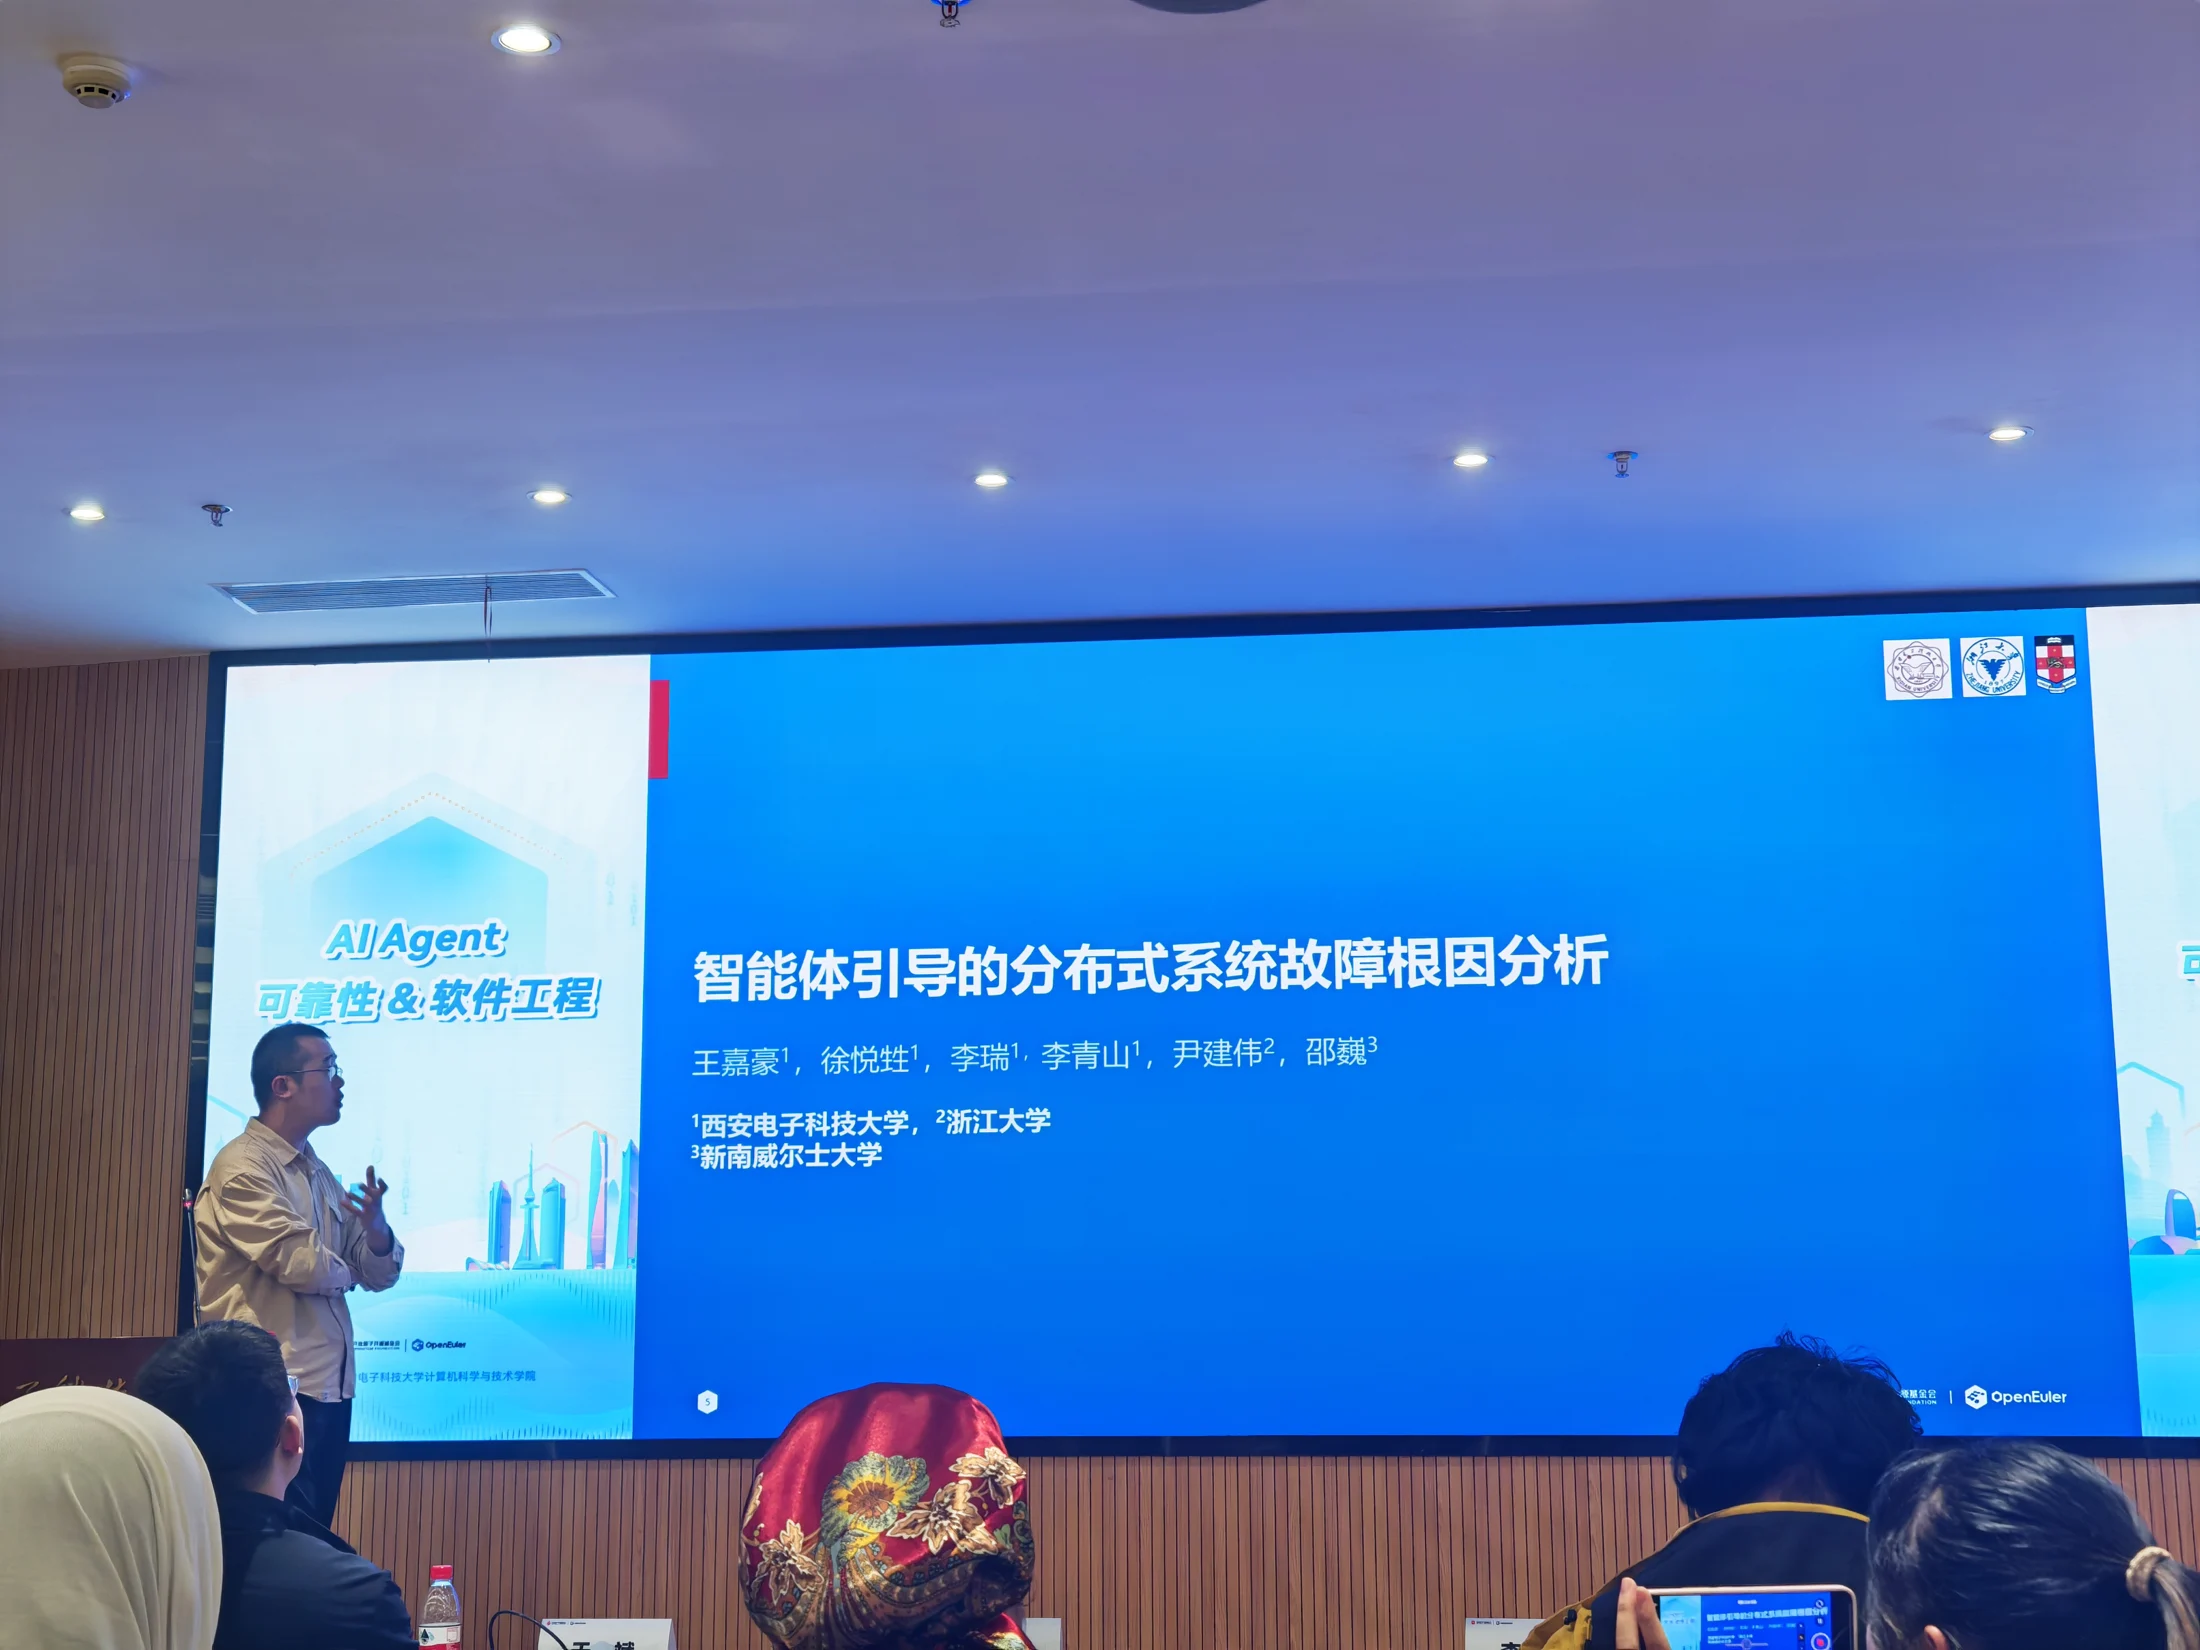
这场报告包含两条研究线:云边协同网络中的微服务编排,以及分布式系统的故障根因分析。共同点是把系统约束、工具和反馈组织成可验证的推理过程。

材料边界:材料拍摄覆盖了建模、框架与实验设置,但不足以复原全部实验结果与消融结论。零样本适应也不等于对任意分布变化都有效。

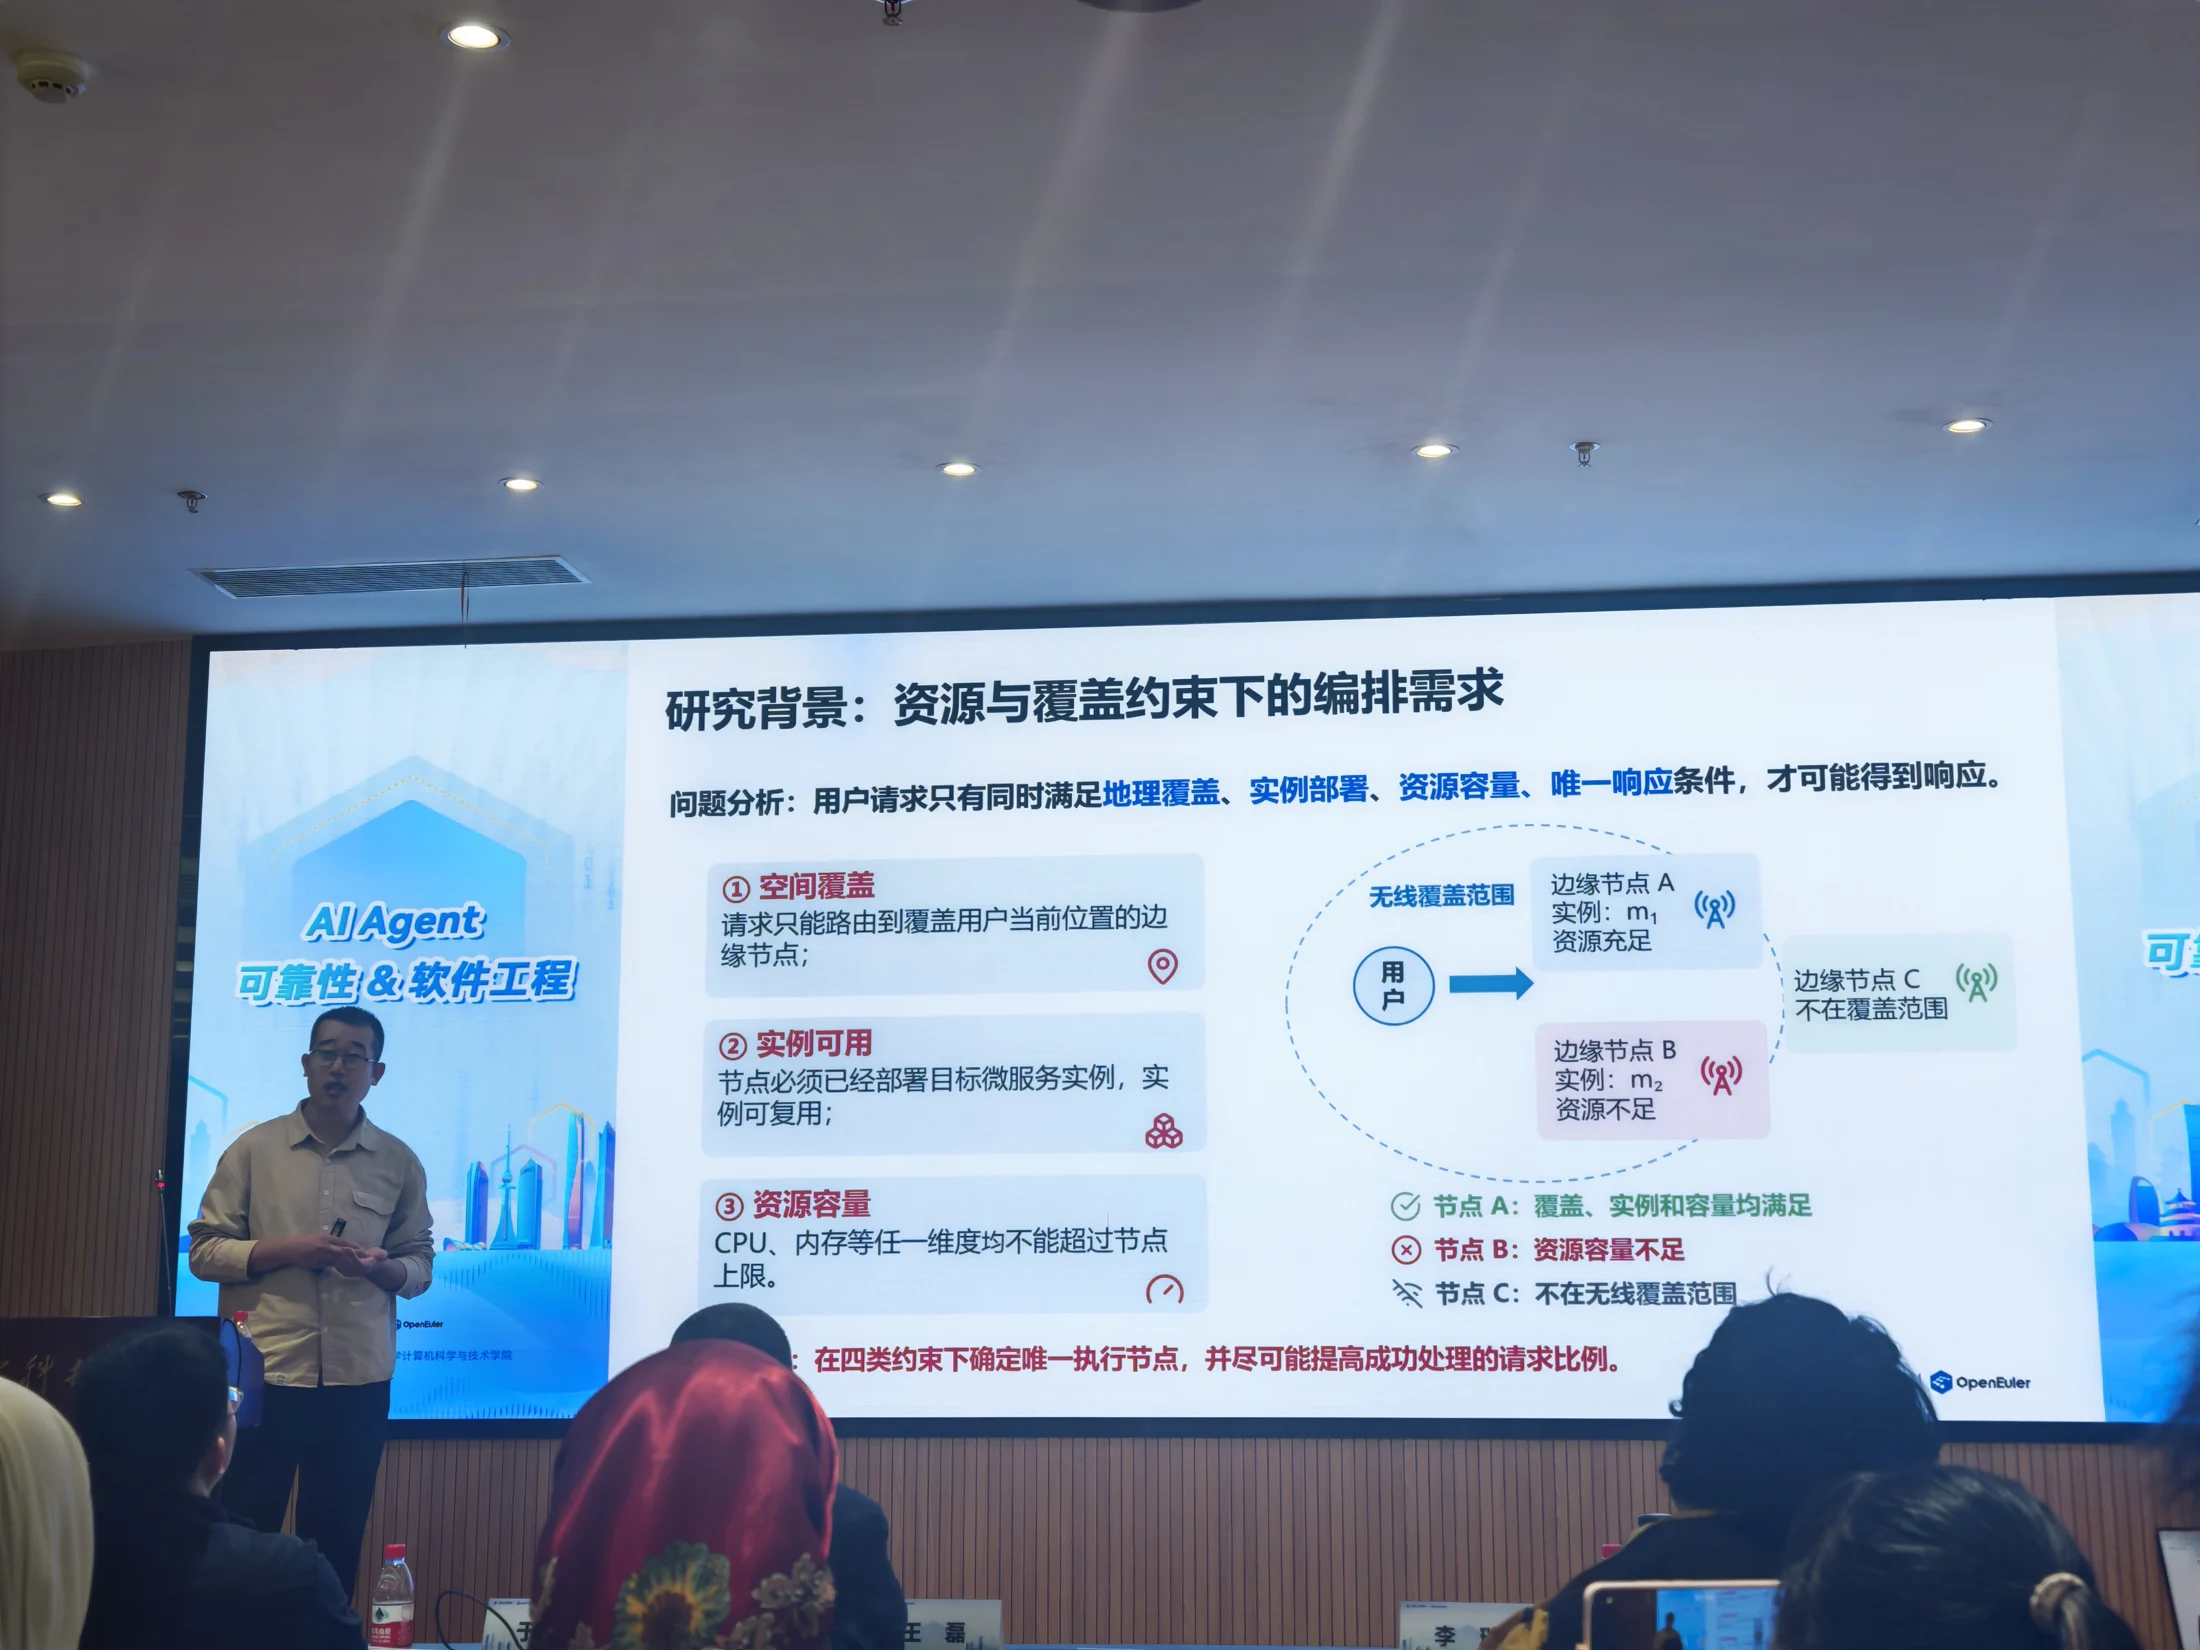
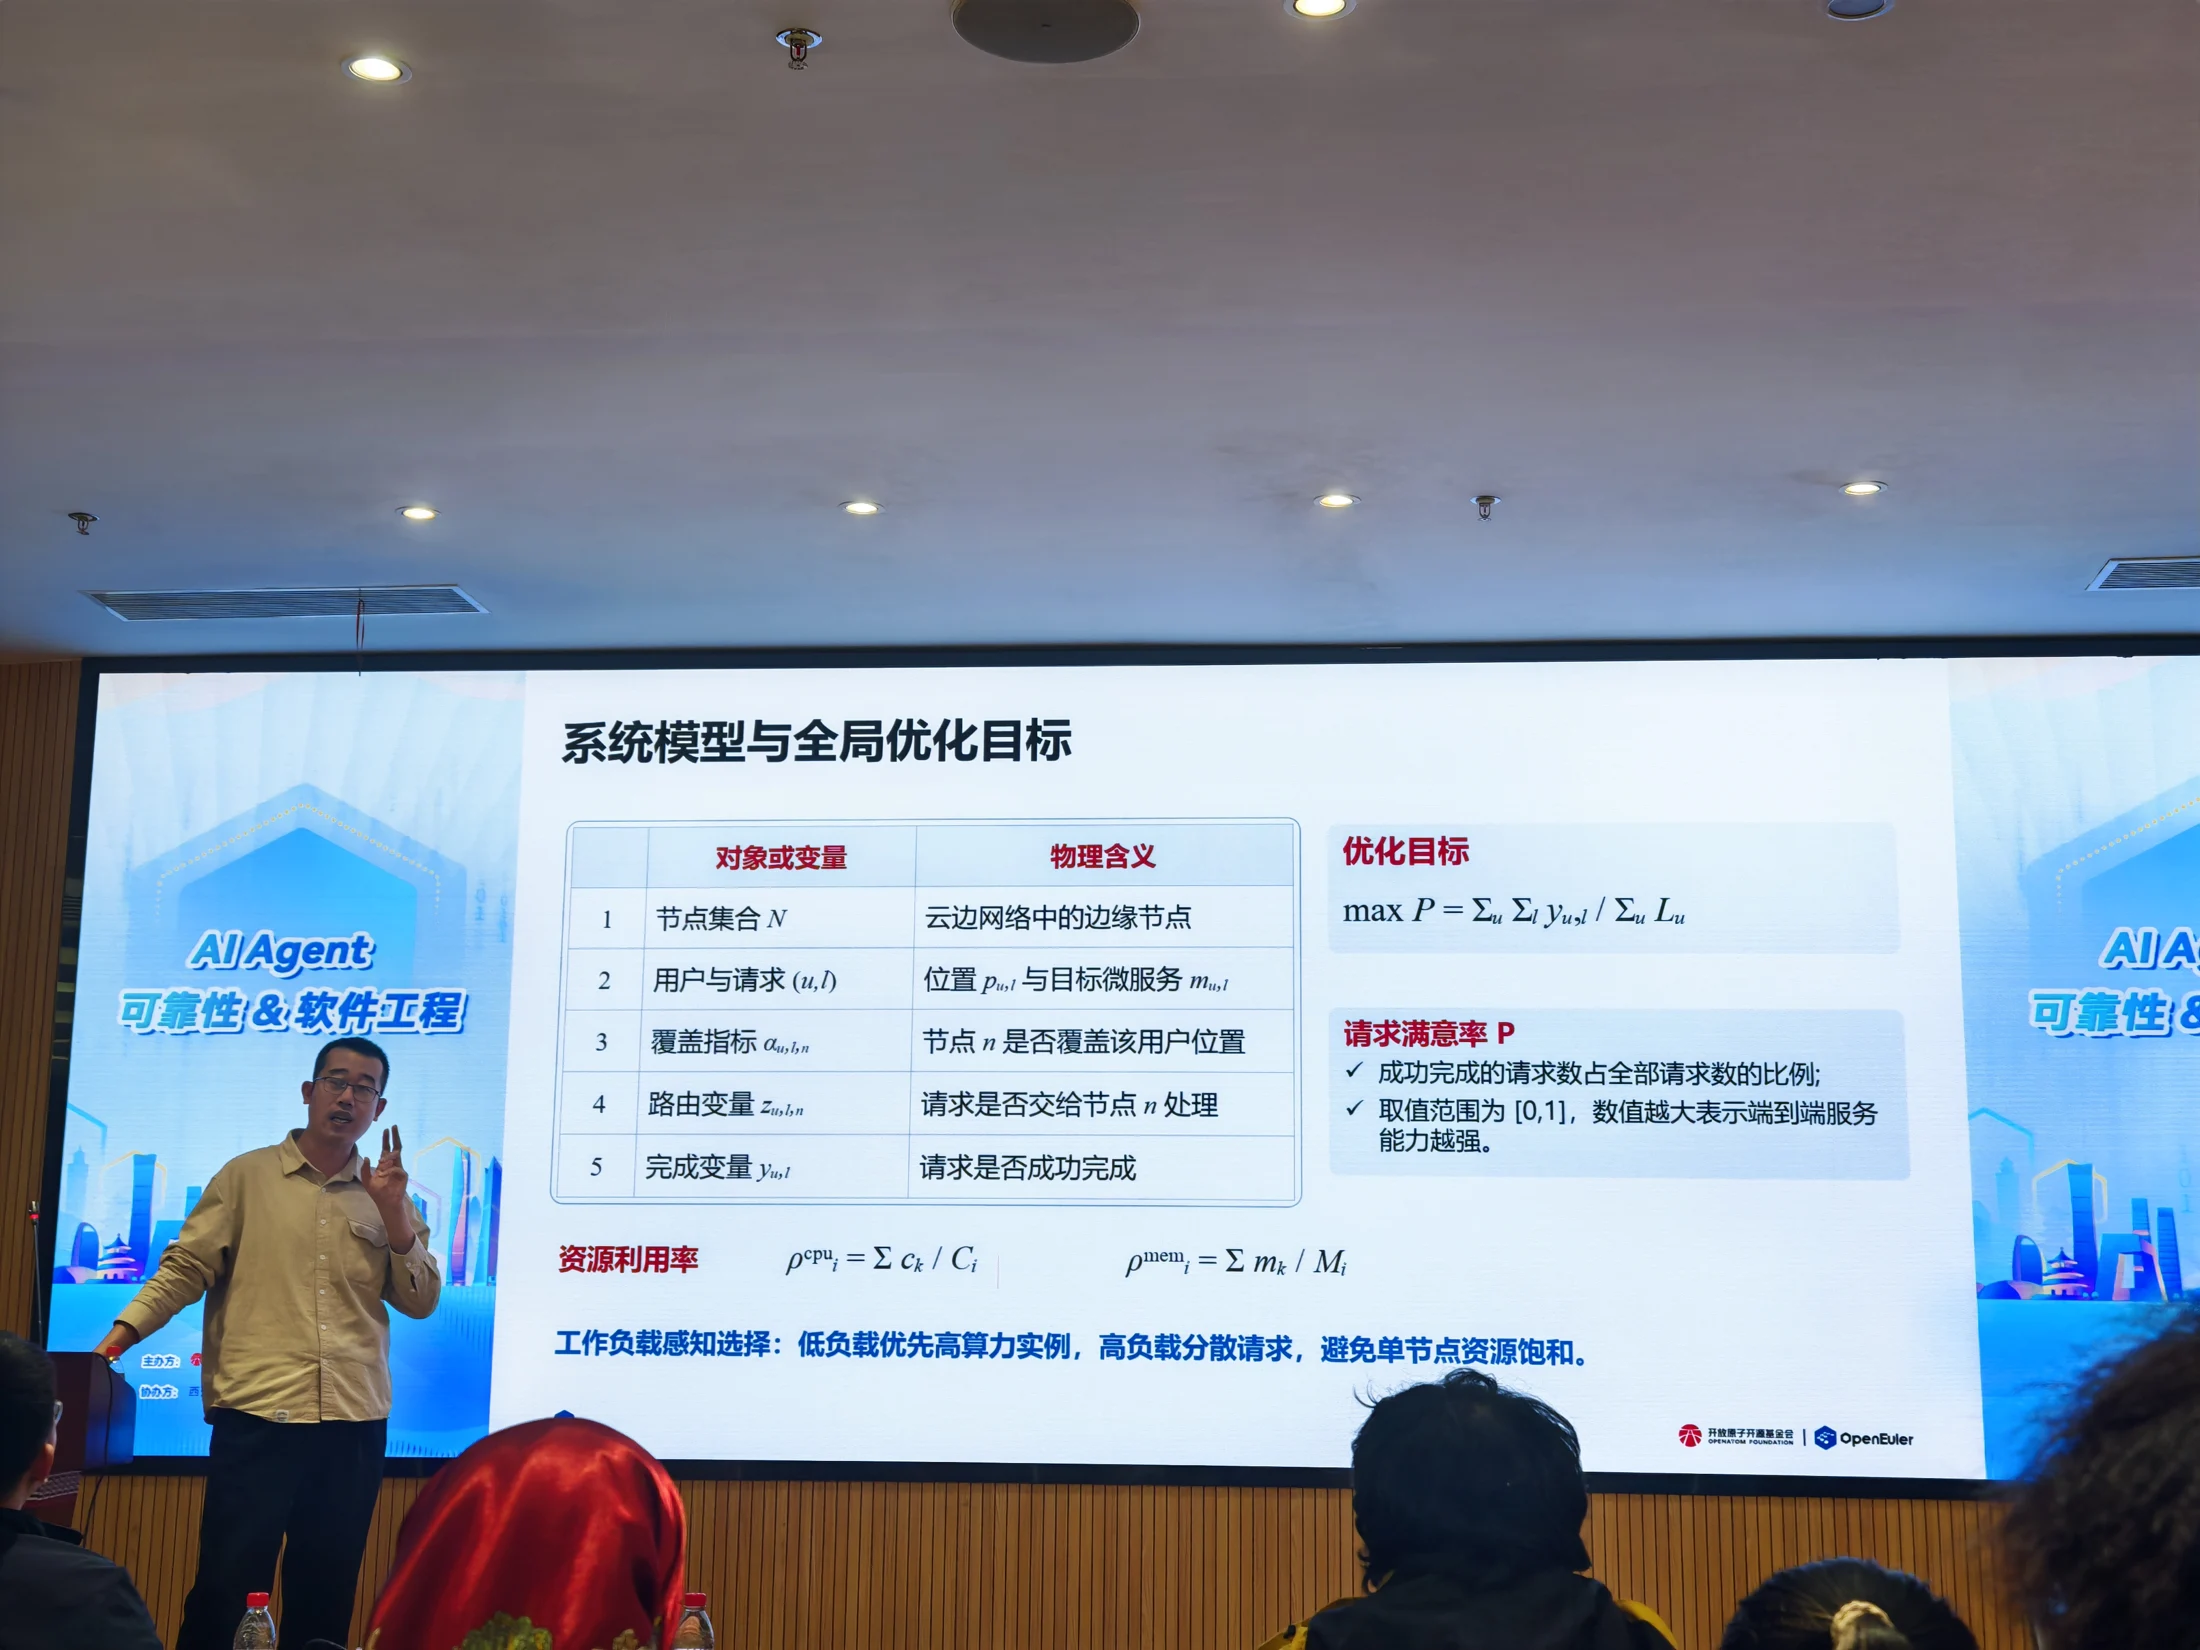
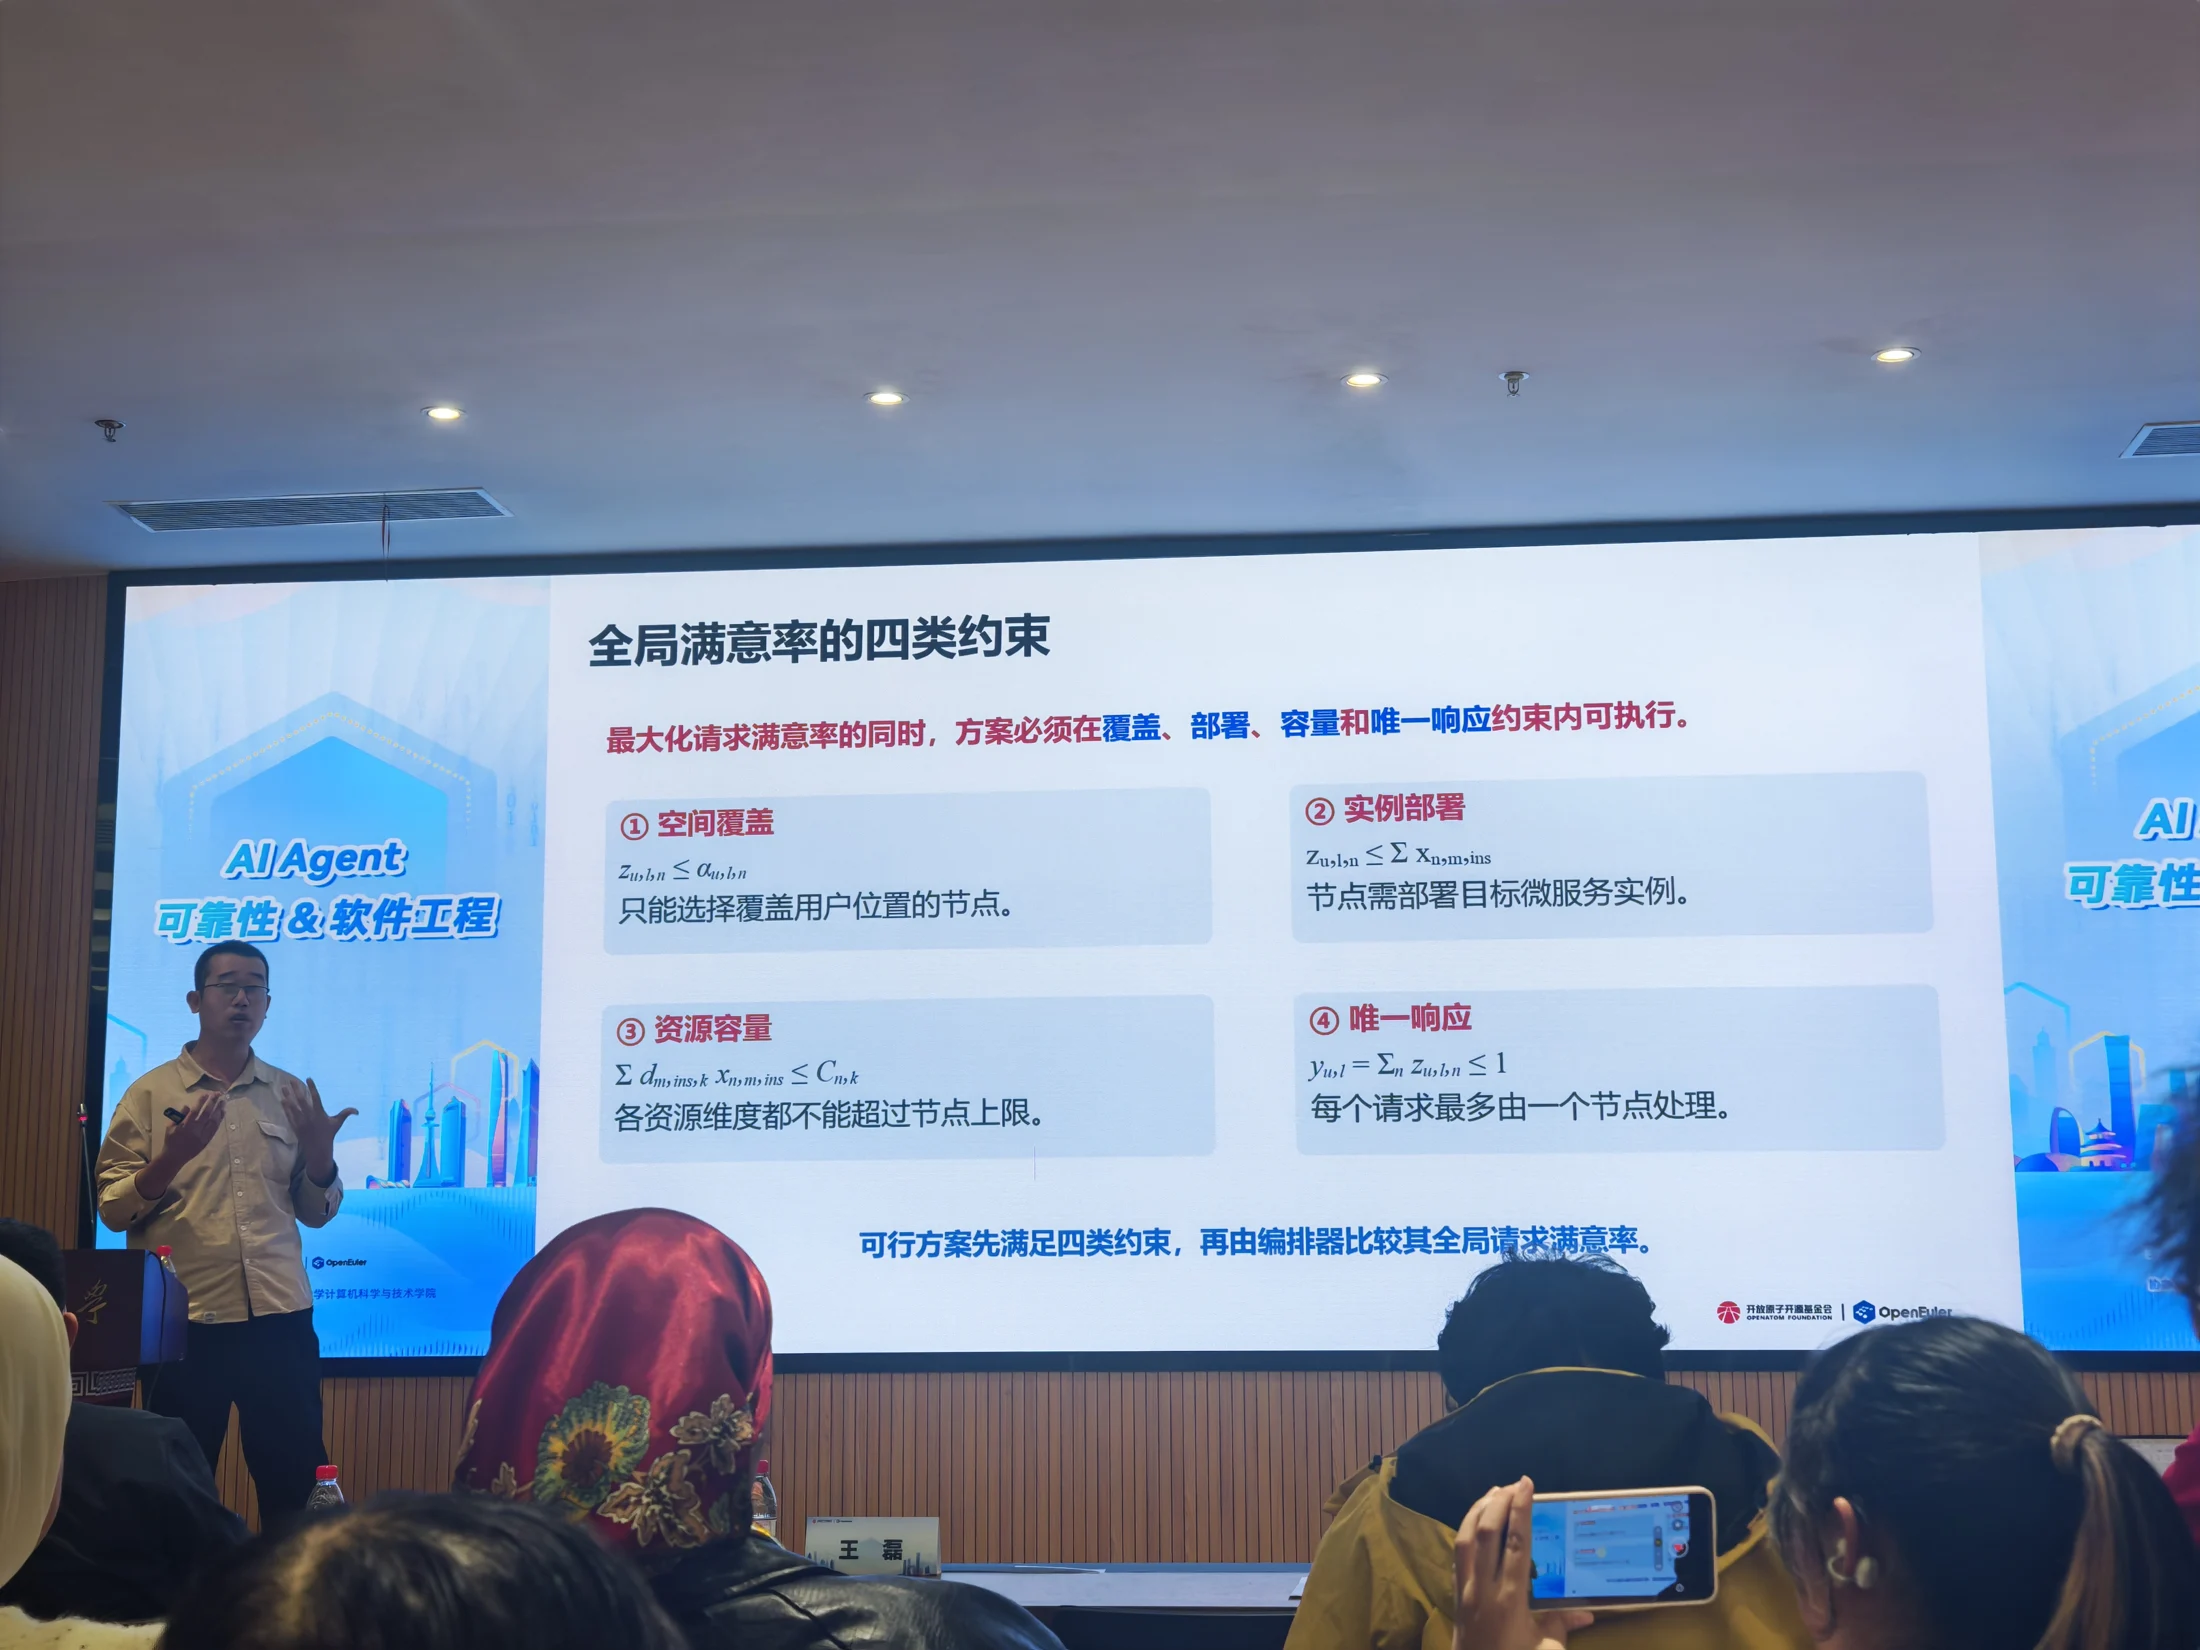
微服务编排有四类硬约束

请求只能路由到覆盖用户位置、已部署目标实例且资源足够的节点;每个请求至多由一个节点处理。在可行方案中,才进一步追求更高的全局请求满足率。

查看照片 IMG_20261031_144155.jpg

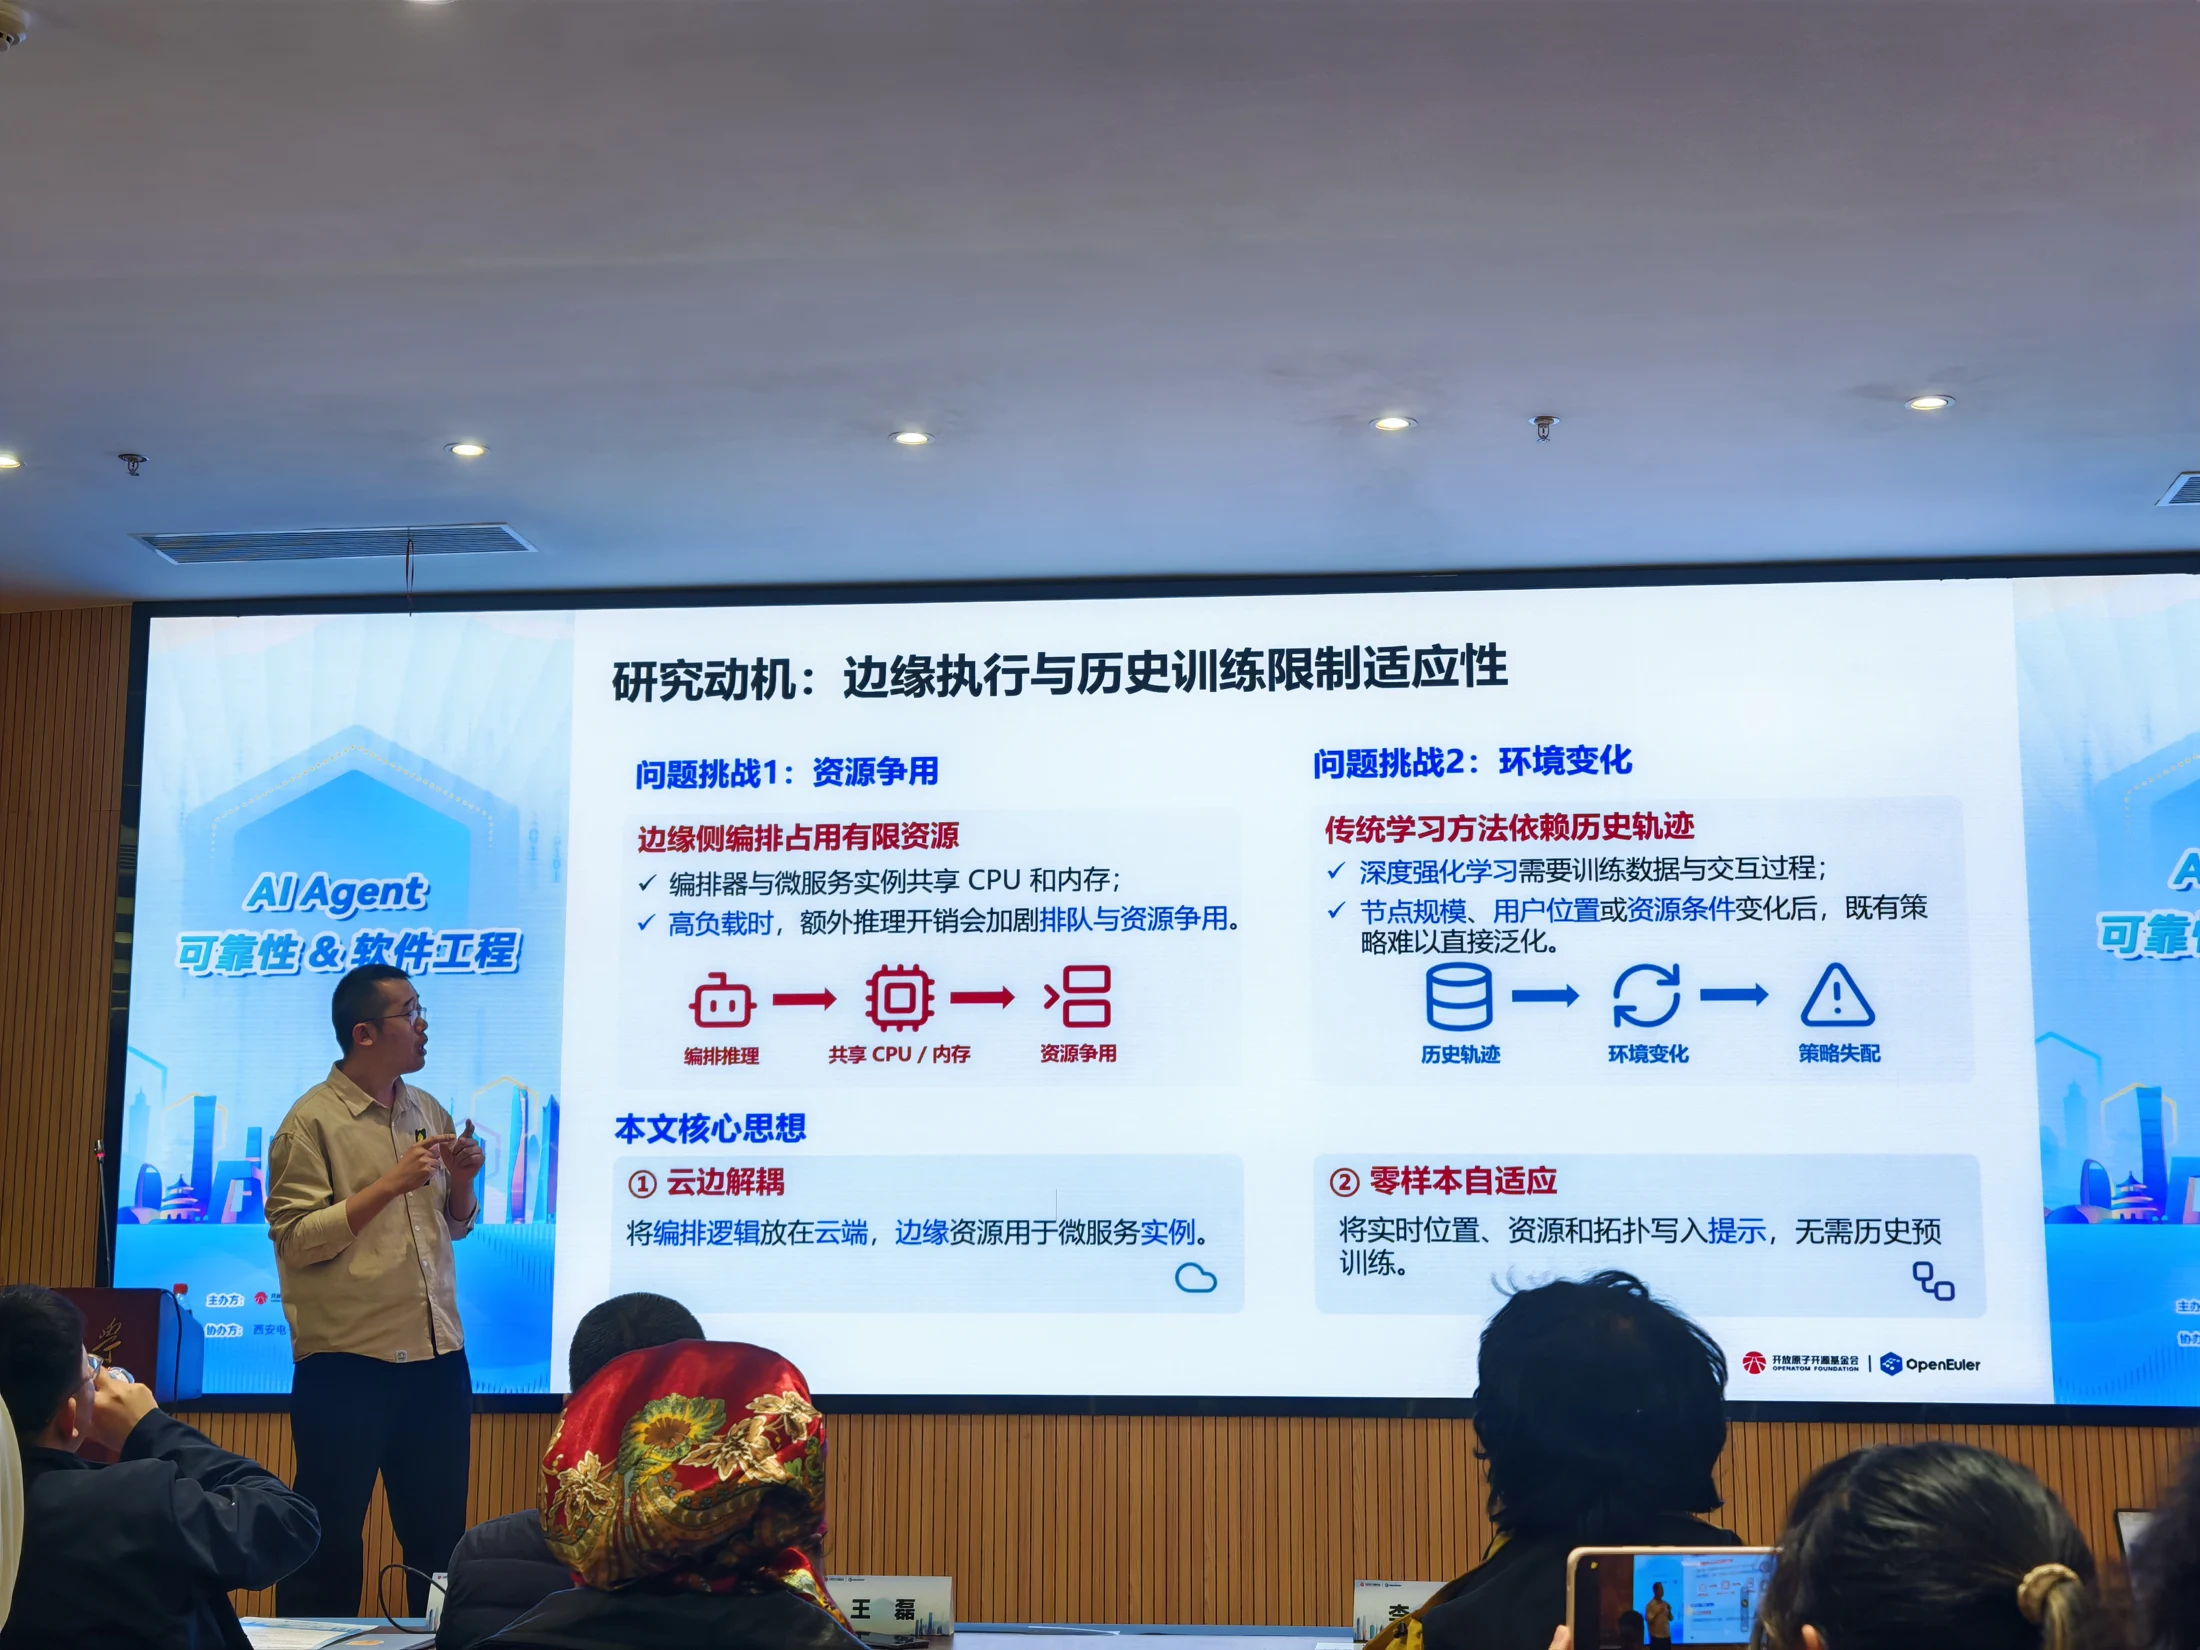
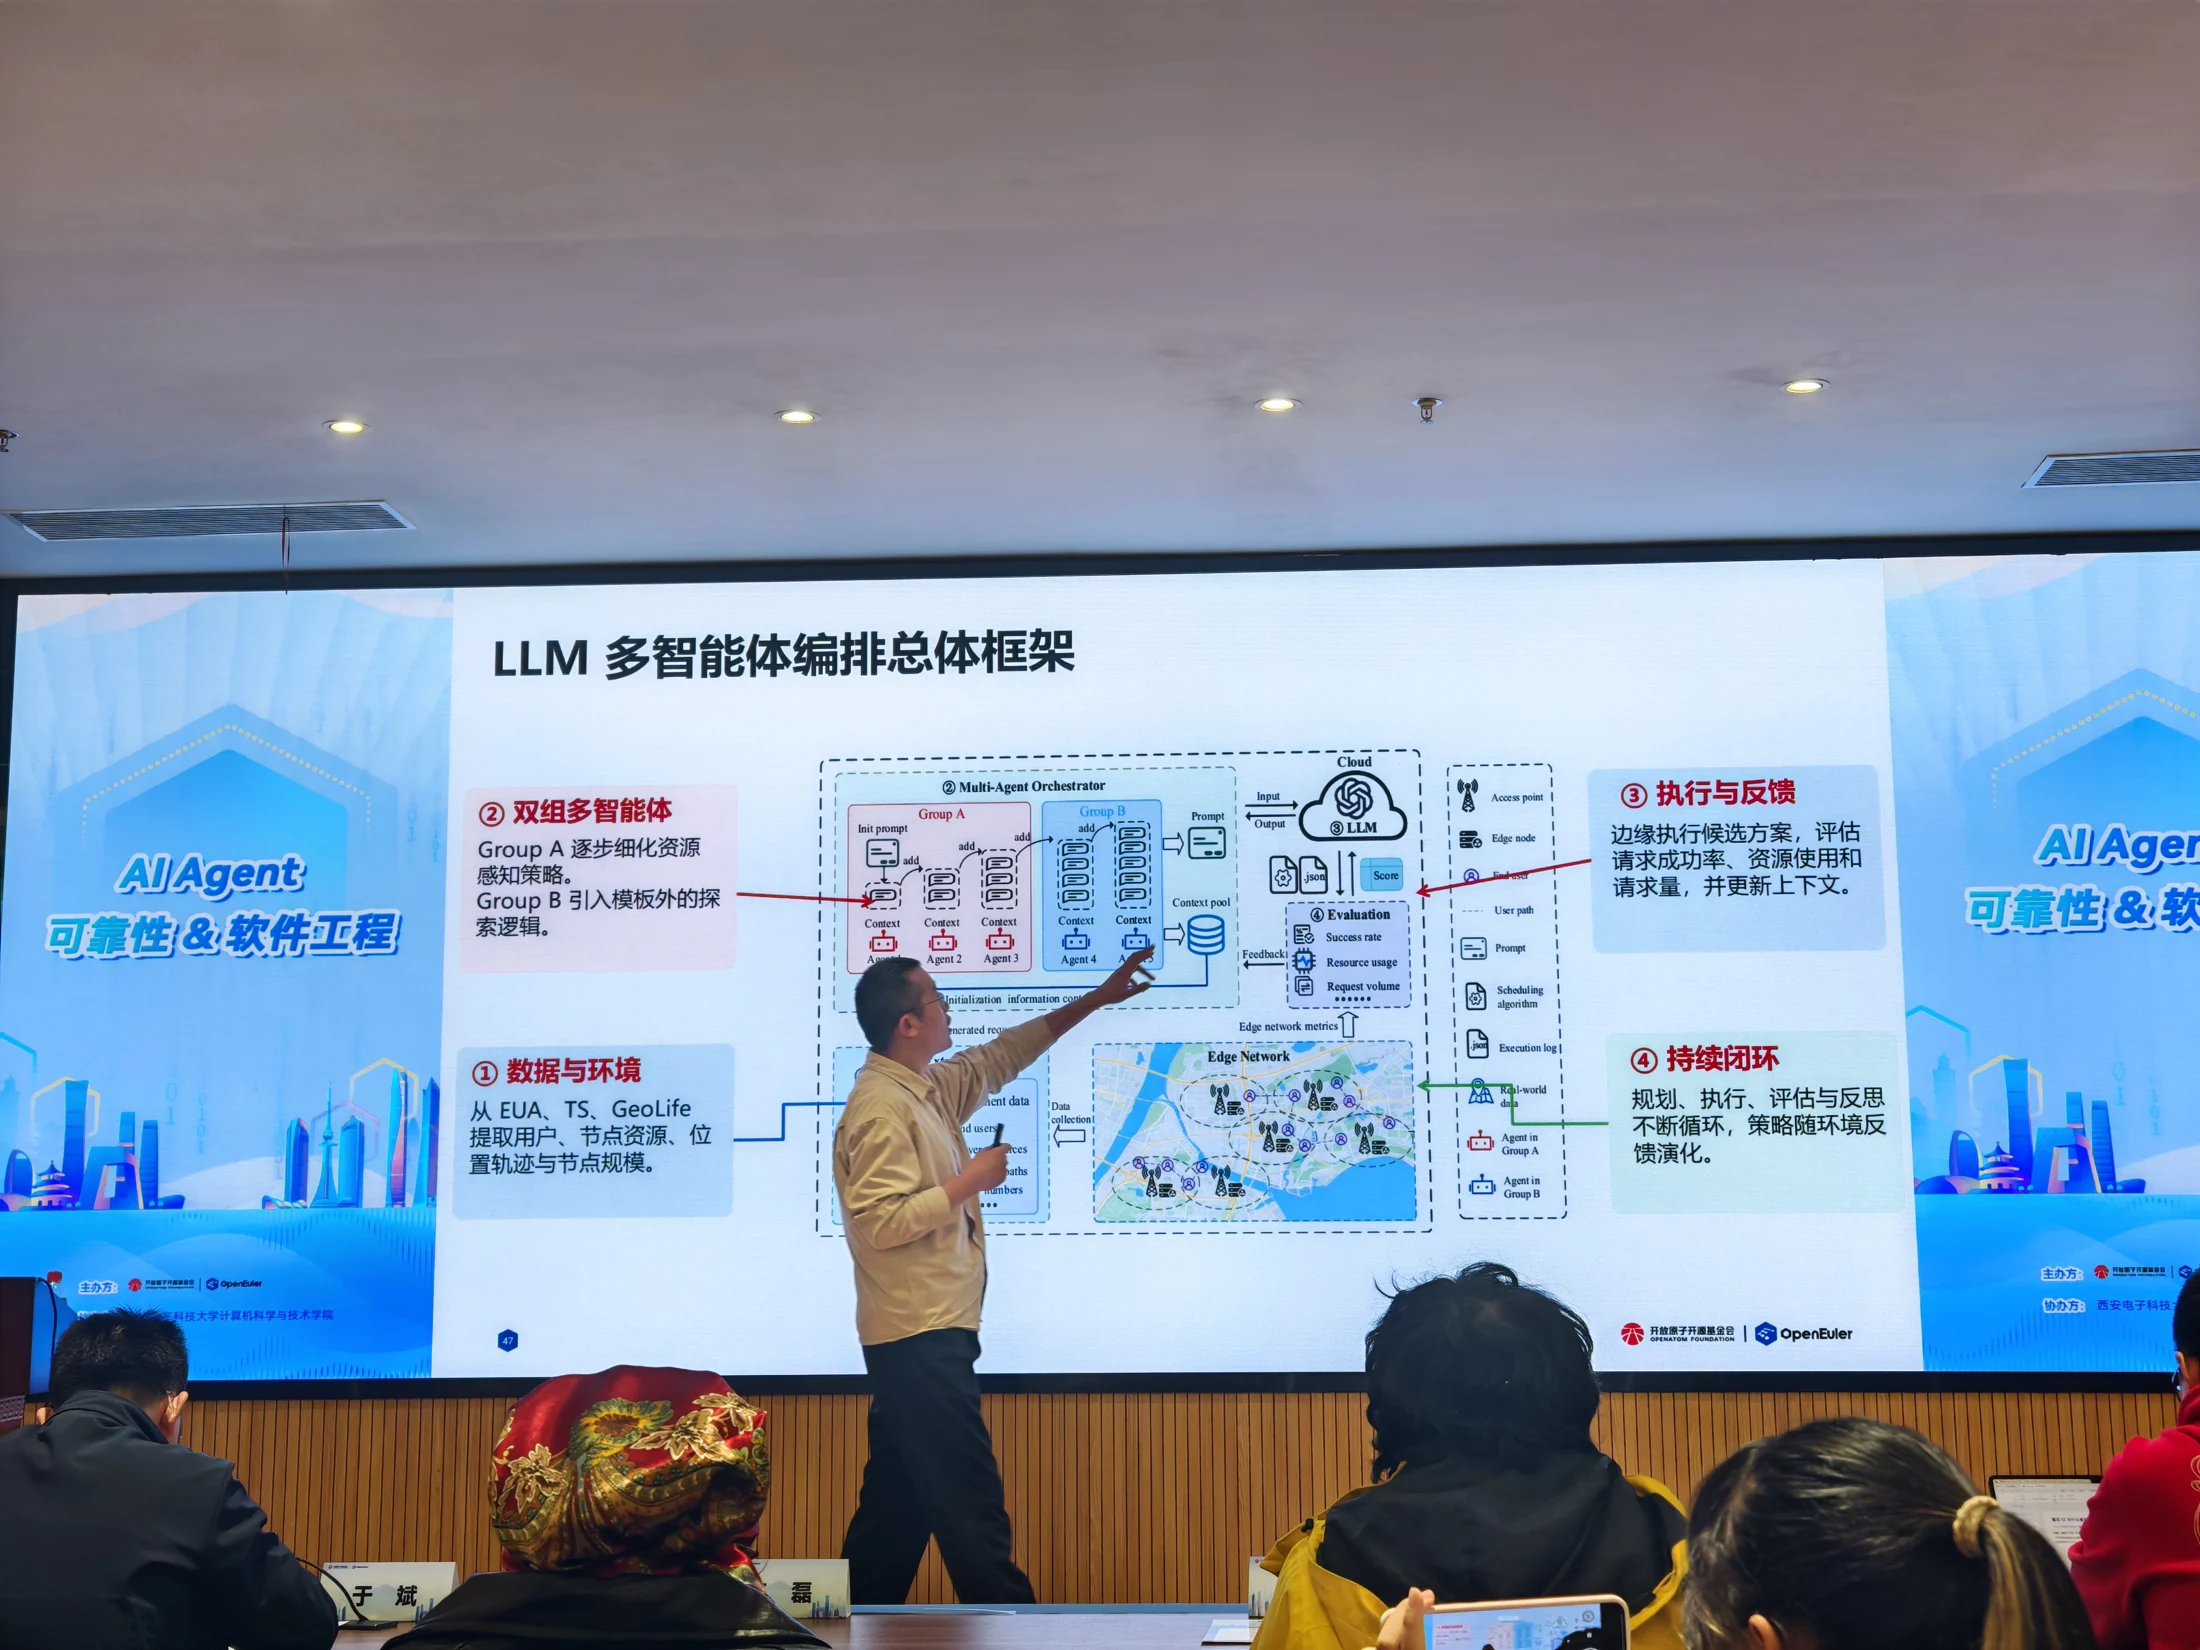
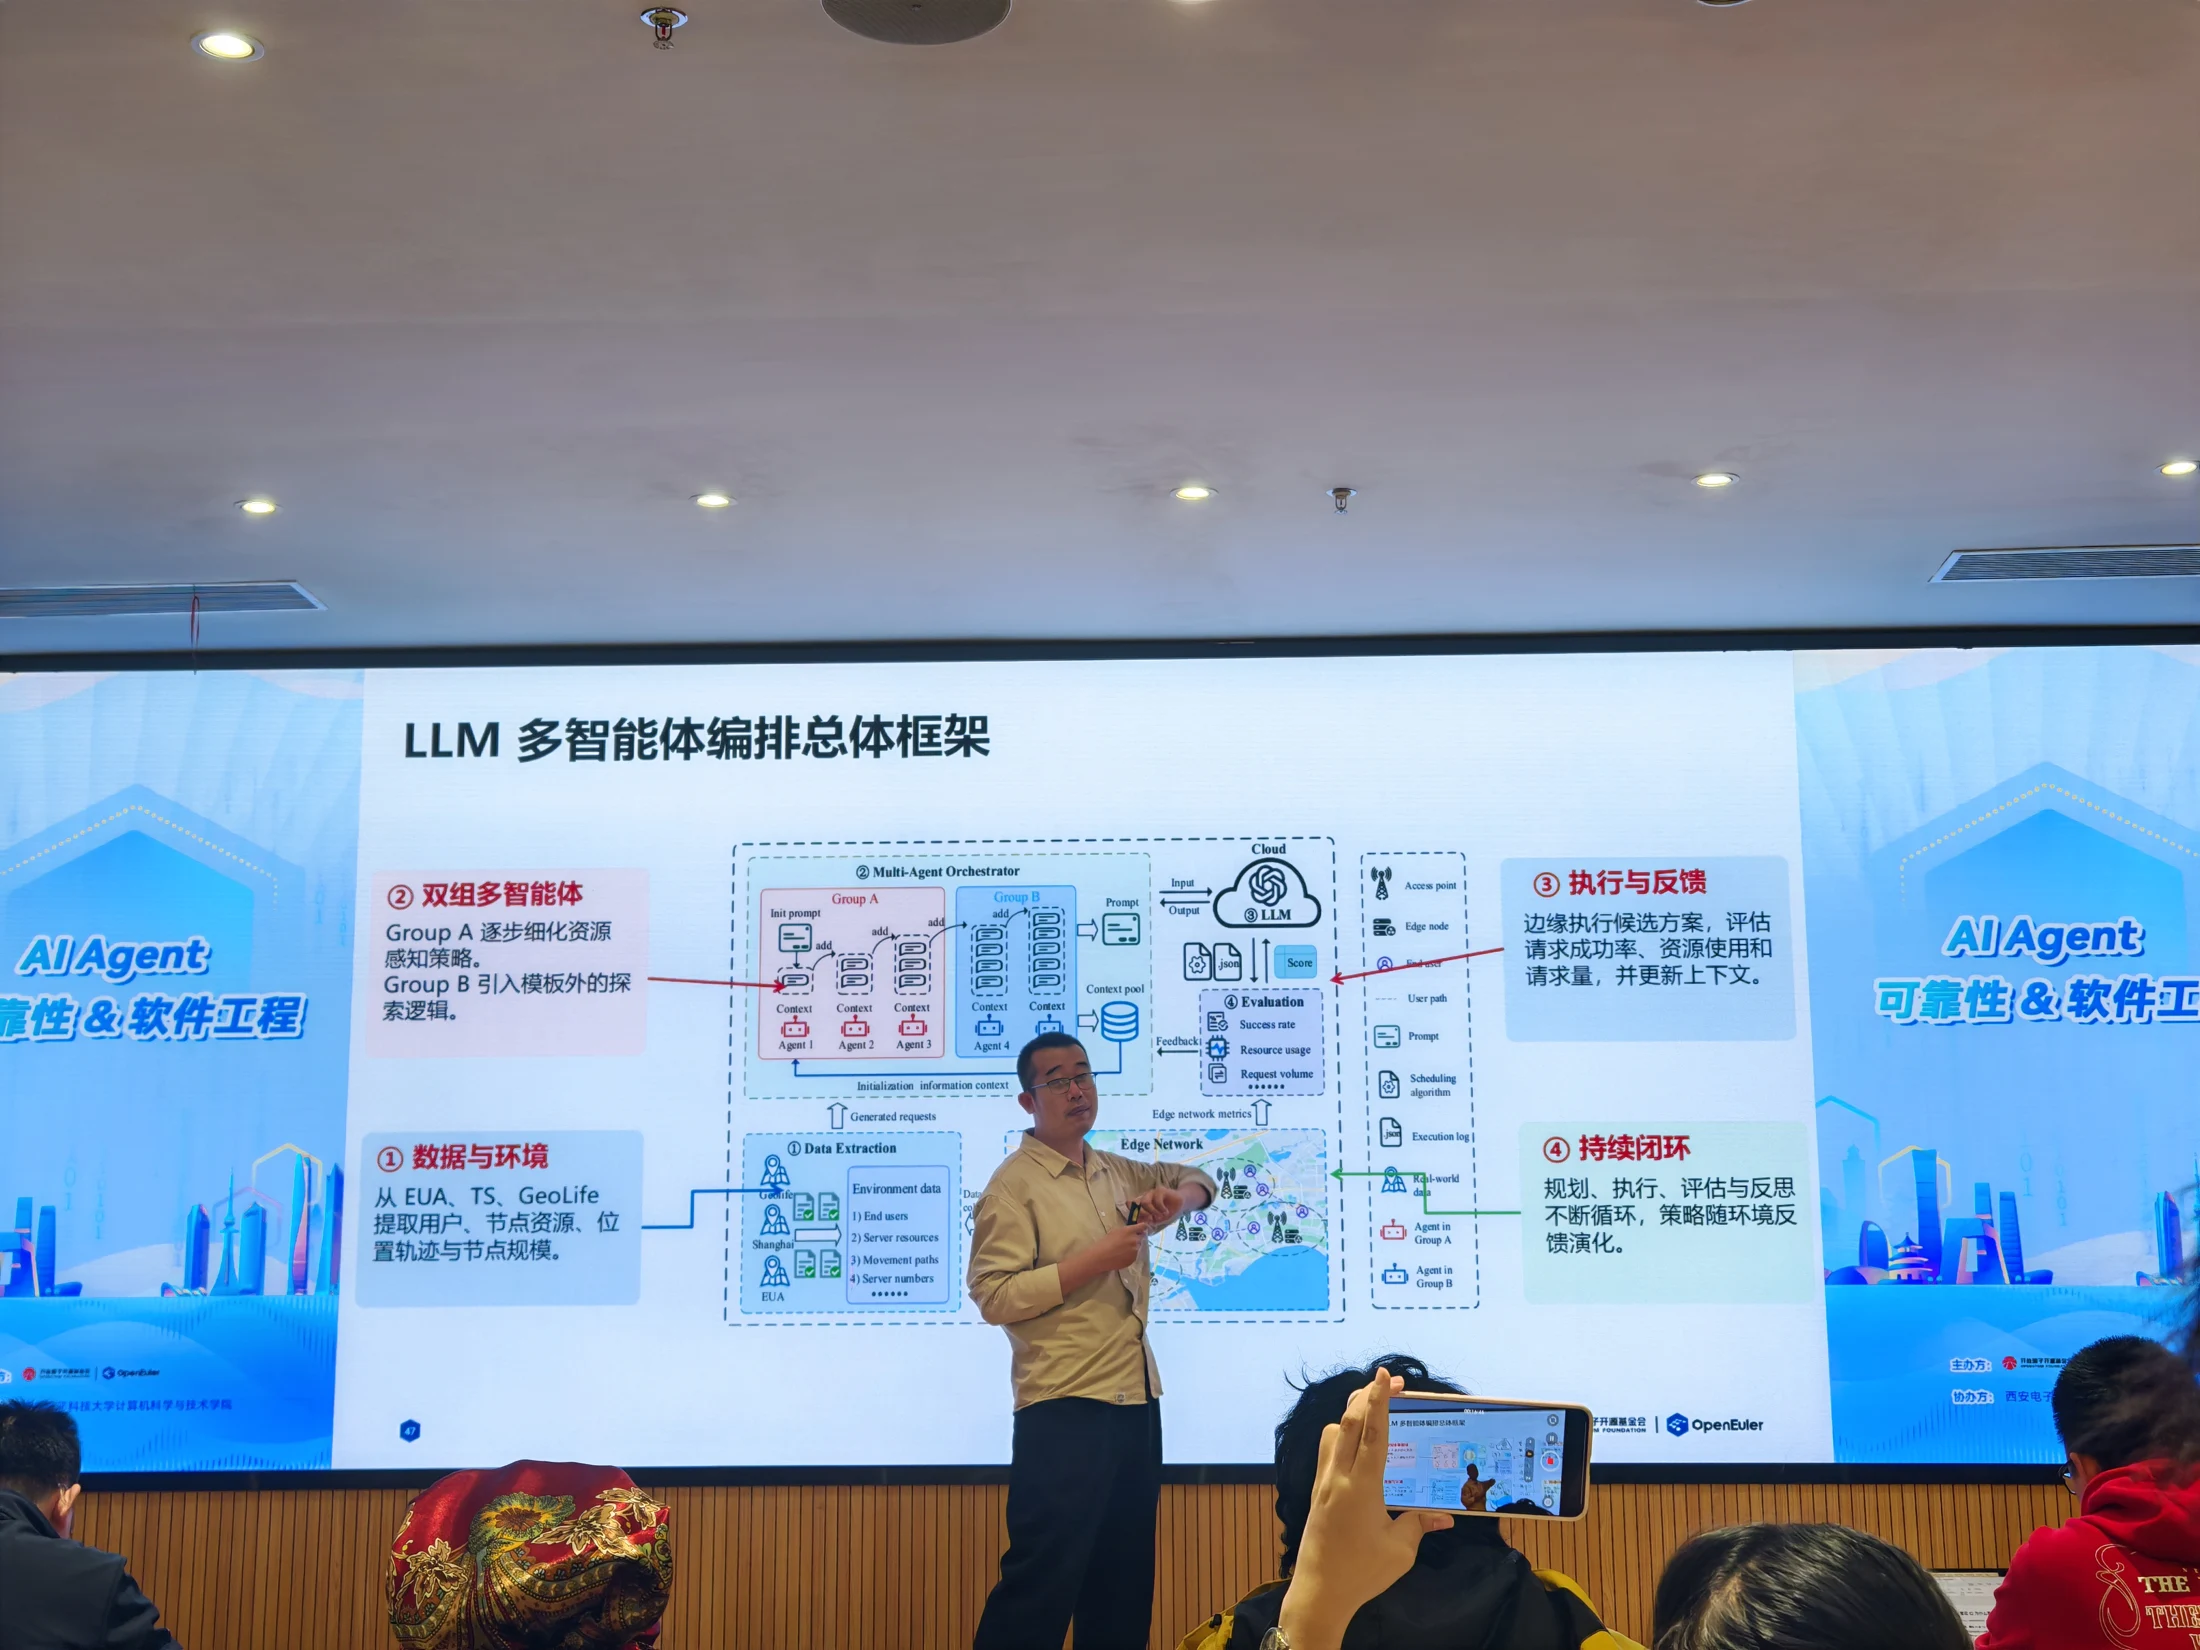
云端编排与边缘执行分离

边缘节点本就受 CPU 和内存限制,额外运行编排推理会争用资源。报告提出把编排逻辑放在云端,把边缘资源留给微服务;通过实时位置和资源进入提示来适应环境变化。

查看照片 IMG_20261031_143545.jpg

双组 Agent 负责不同搜索行为

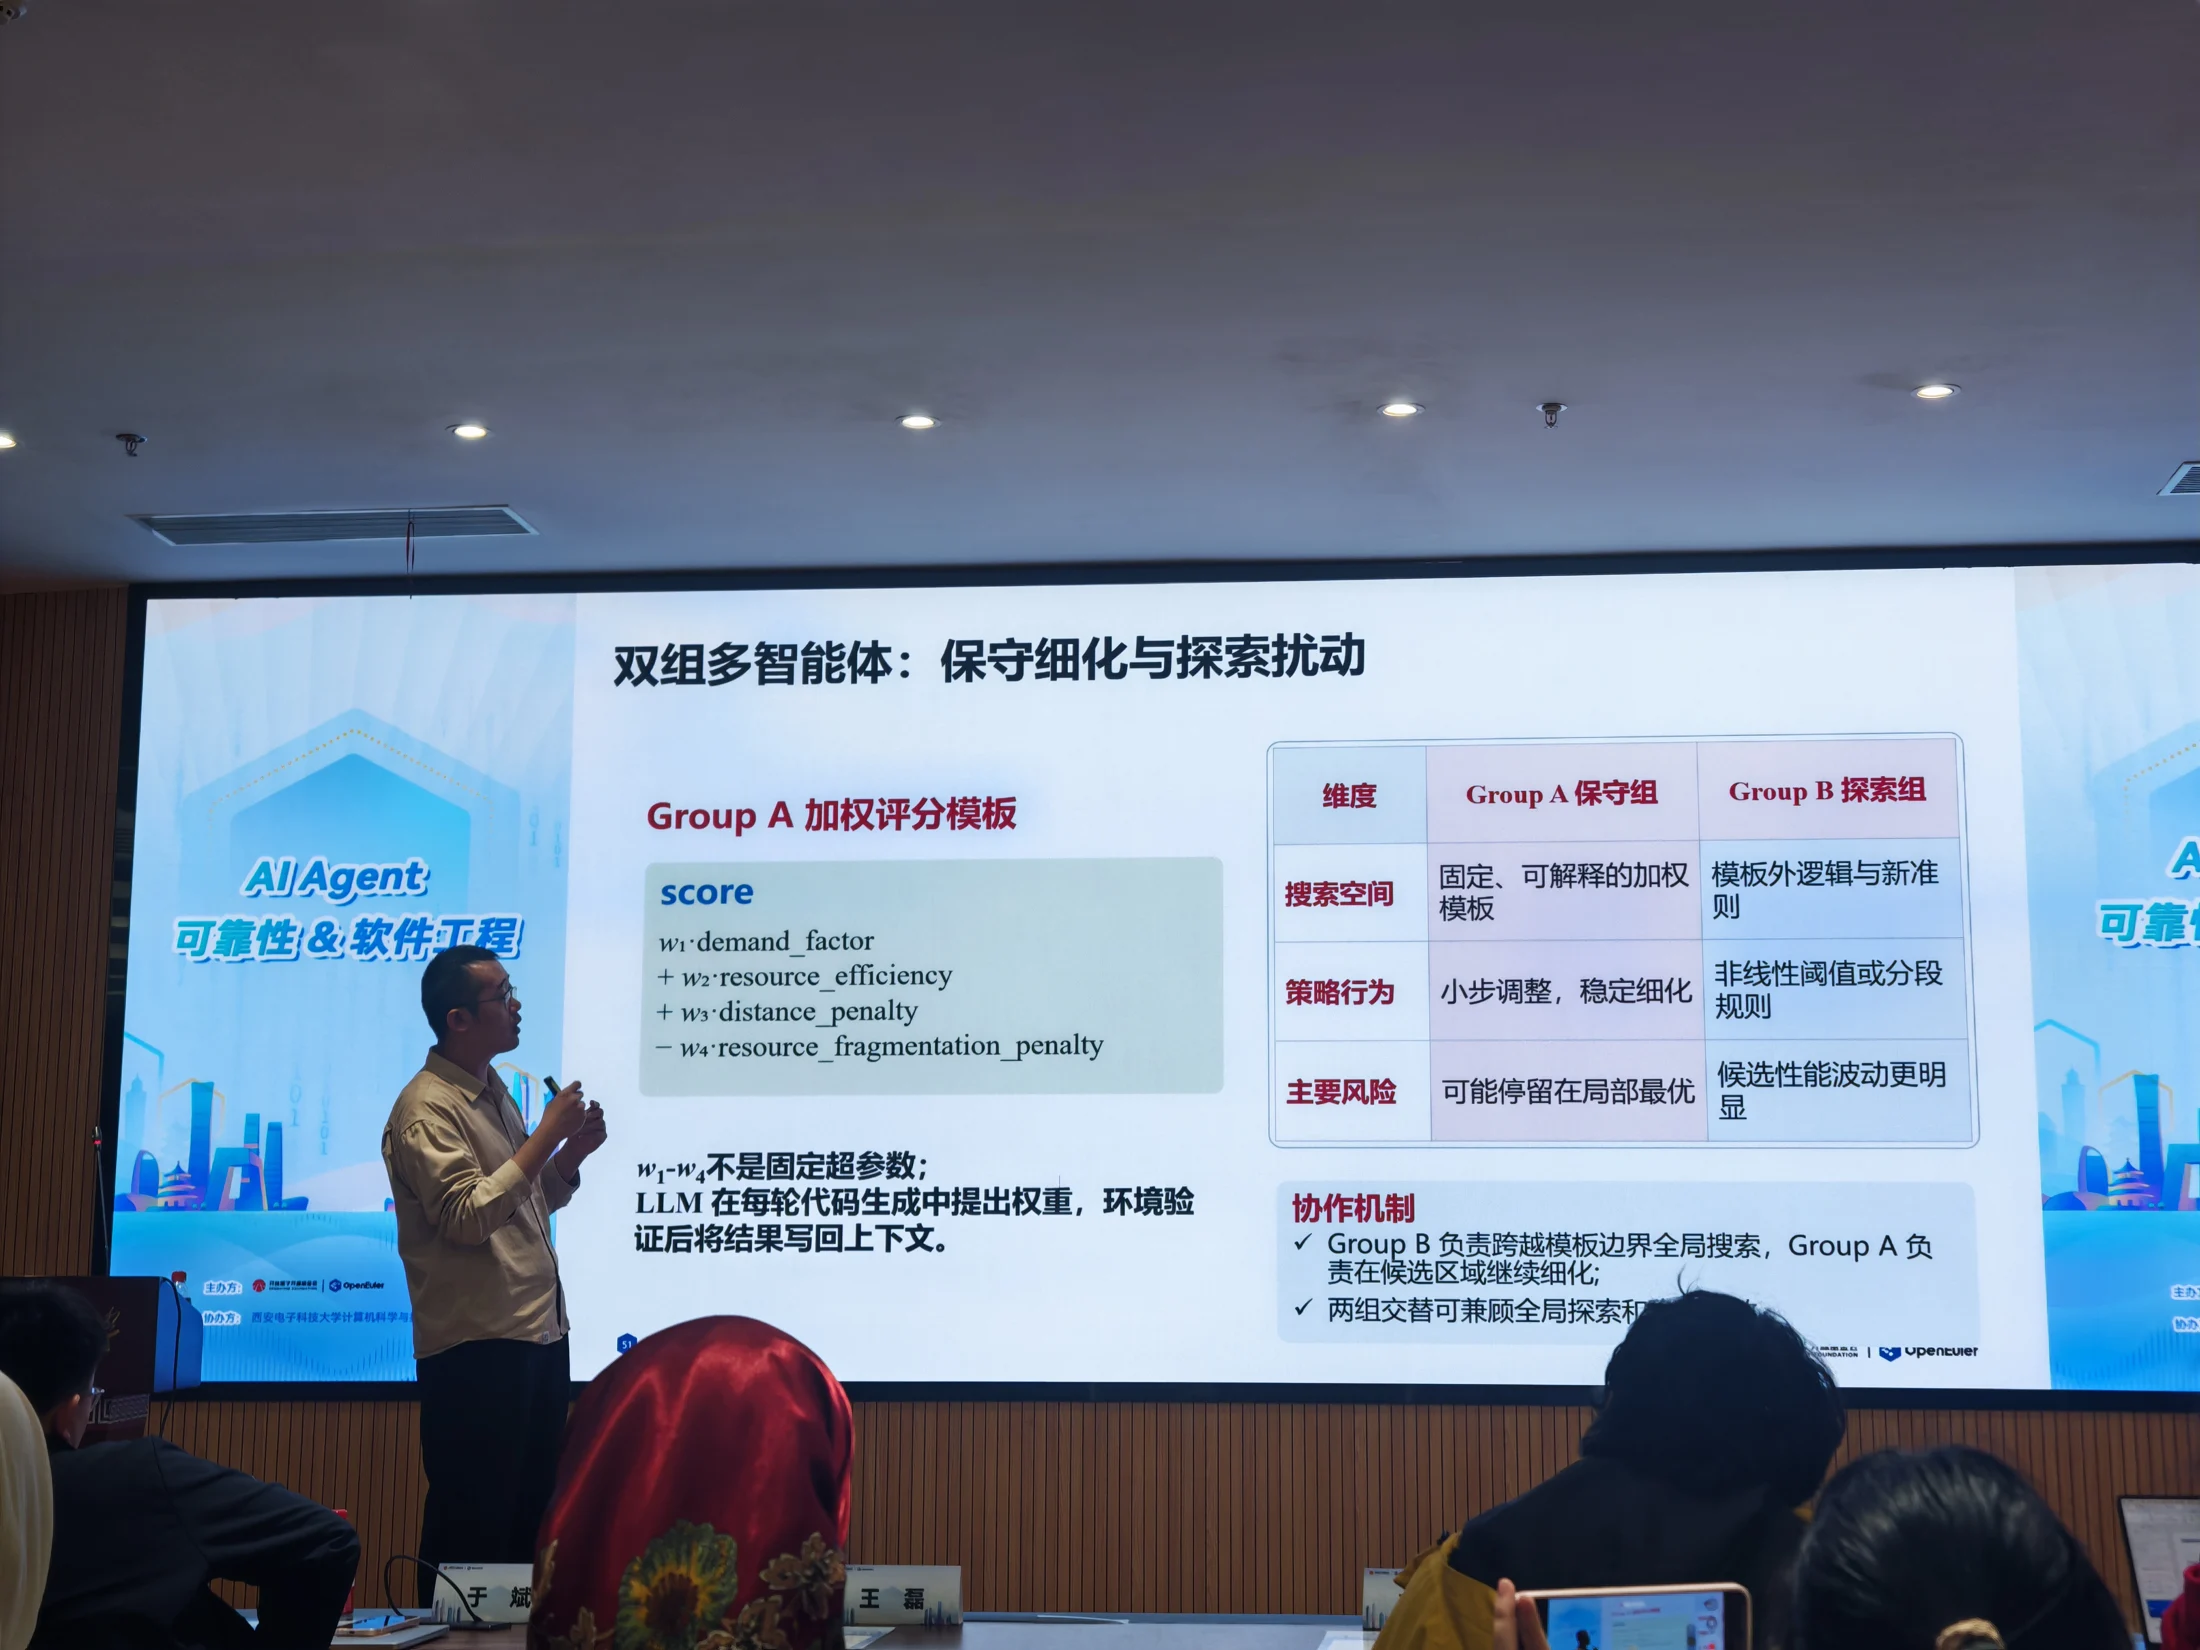
保守组在可解释的加权评分模板内稳定细化;探索组尝试模板之外的规则,以跳出局部最优。候选策略执行后,将请求满足率和资源使用结果写回上下文,形成反馈循环。

查看照片 IMG_20261031_144550.jpg

结构化提示输出可执行策略

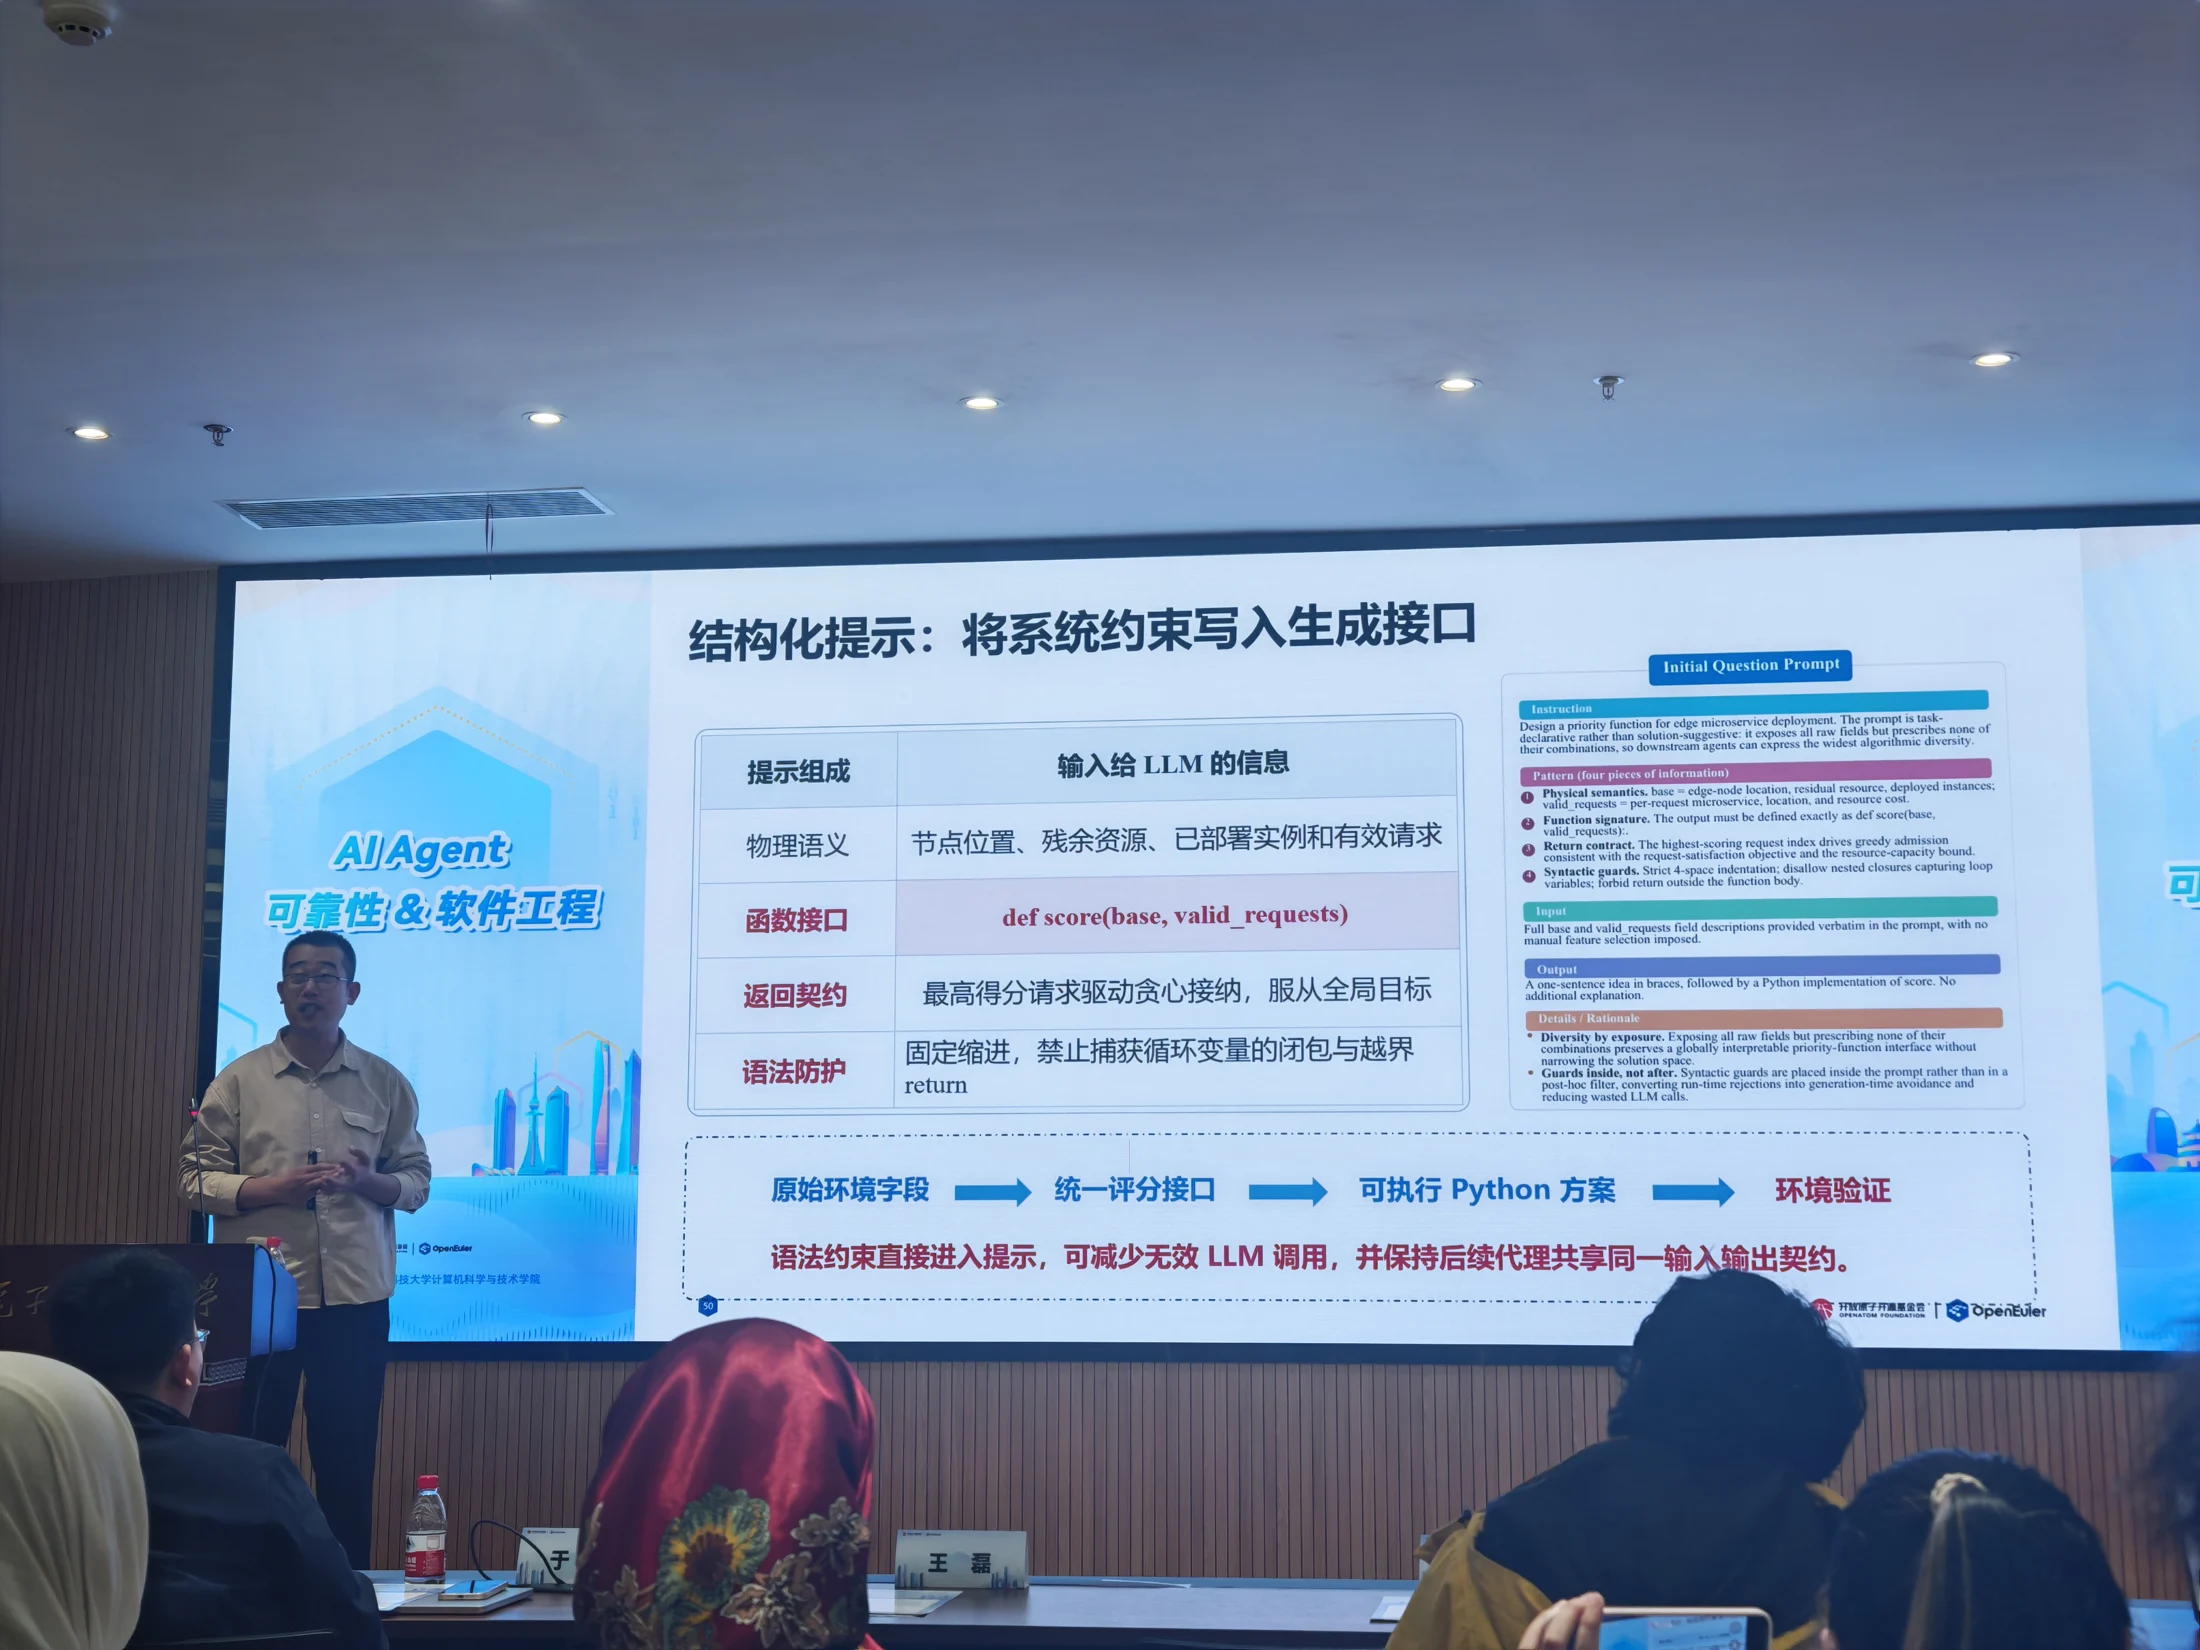
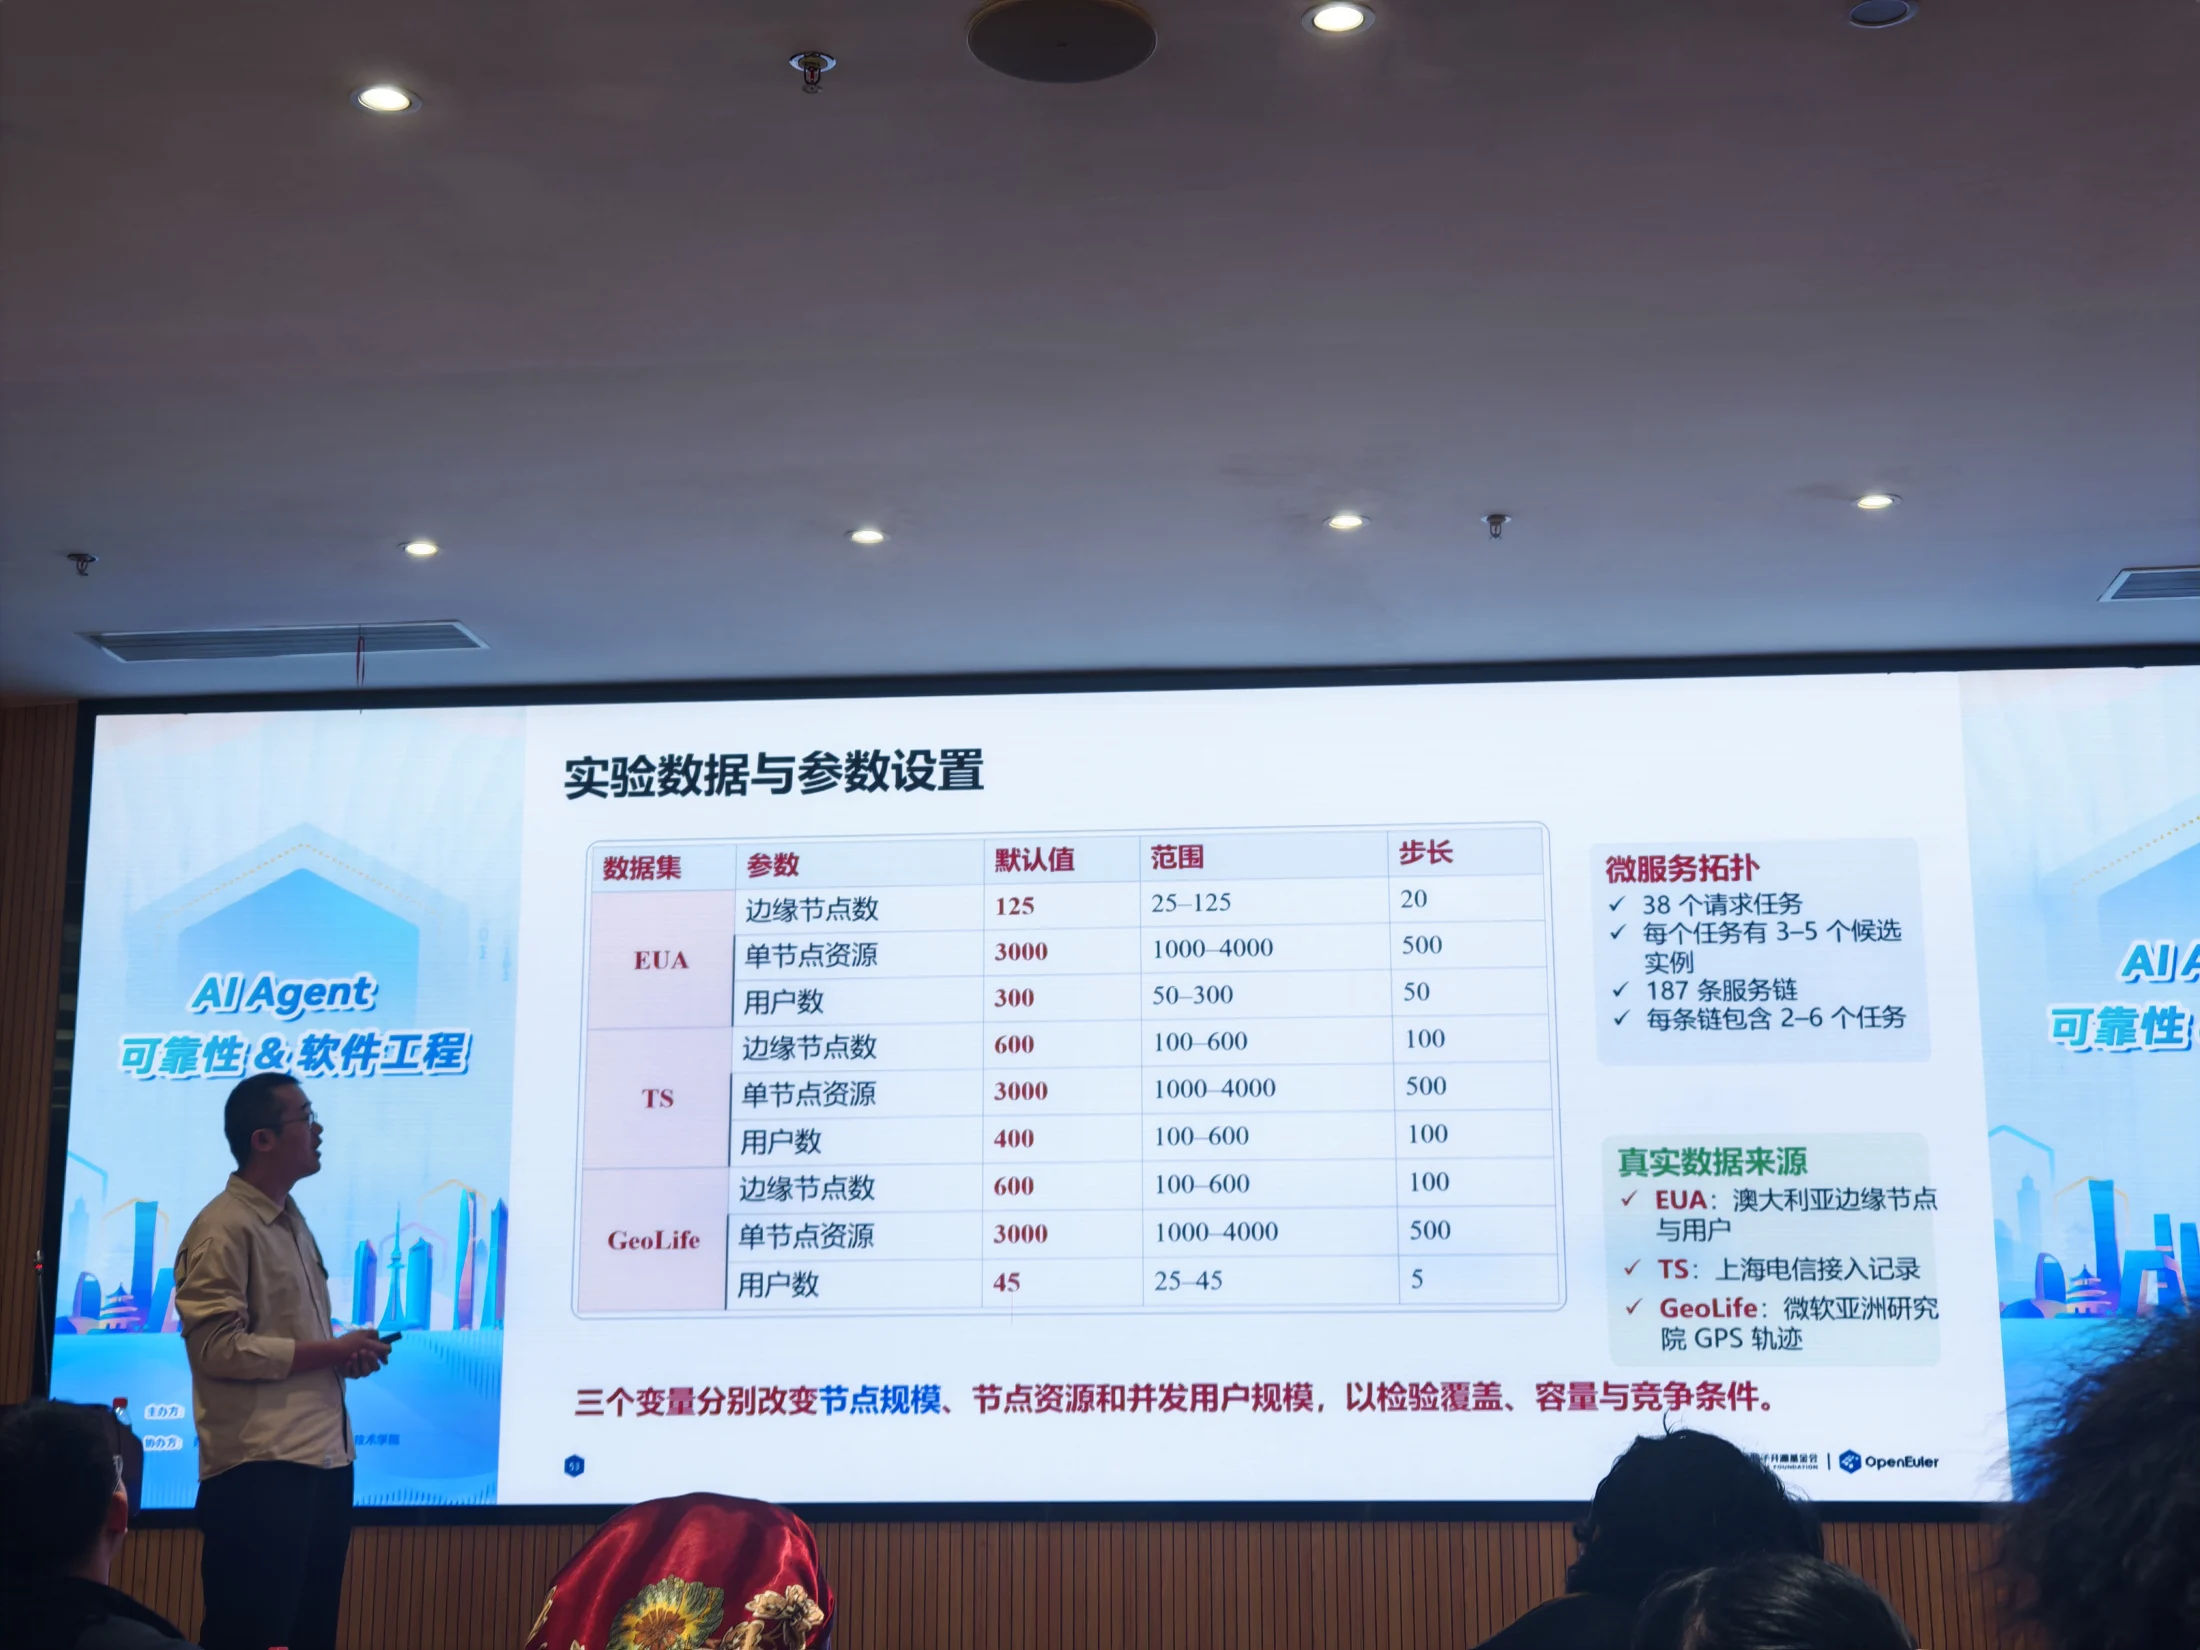
材料给定统一评分接口、返回契约与语法防护,要求生成 Python 方案后交由环境验证。数据设置涉及 EUA、TS、GeoLife,并变化节点规模、资源与用户数量;照片没有提供完整结果页,不能据此宣称性能优于全部基线。

查看照片 IMG_20261031_144247.jpg

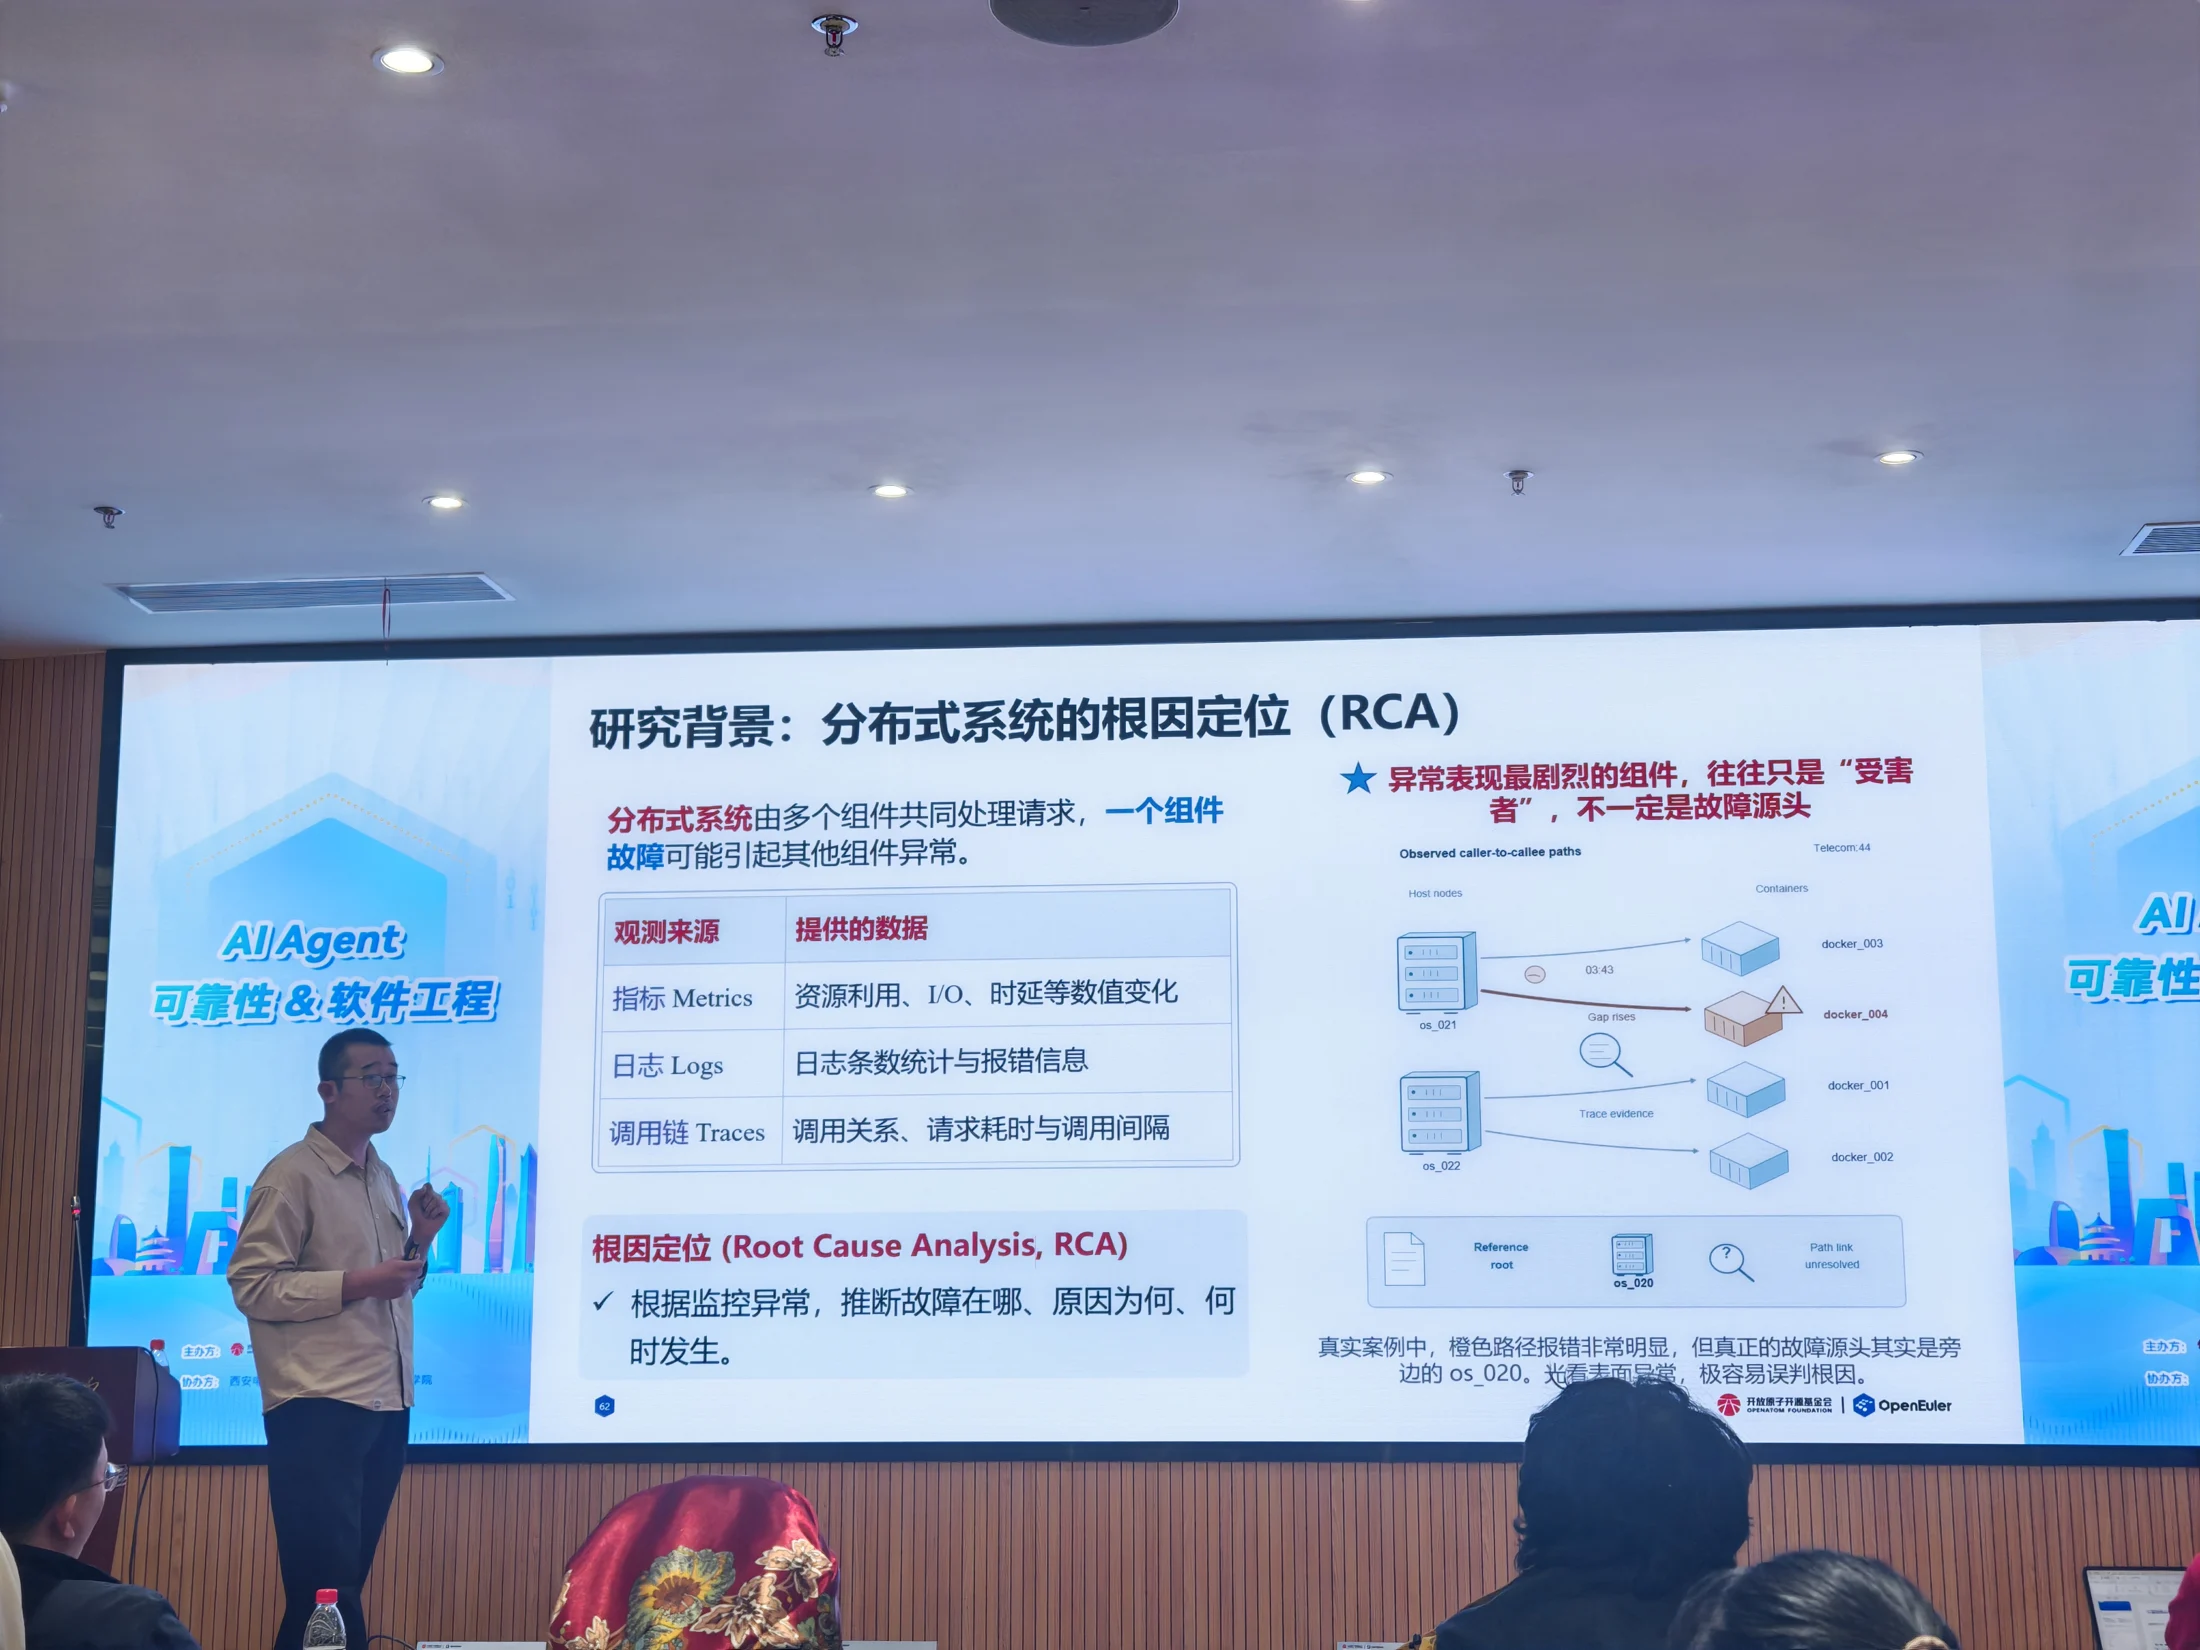
根因分析必须跨观测来源

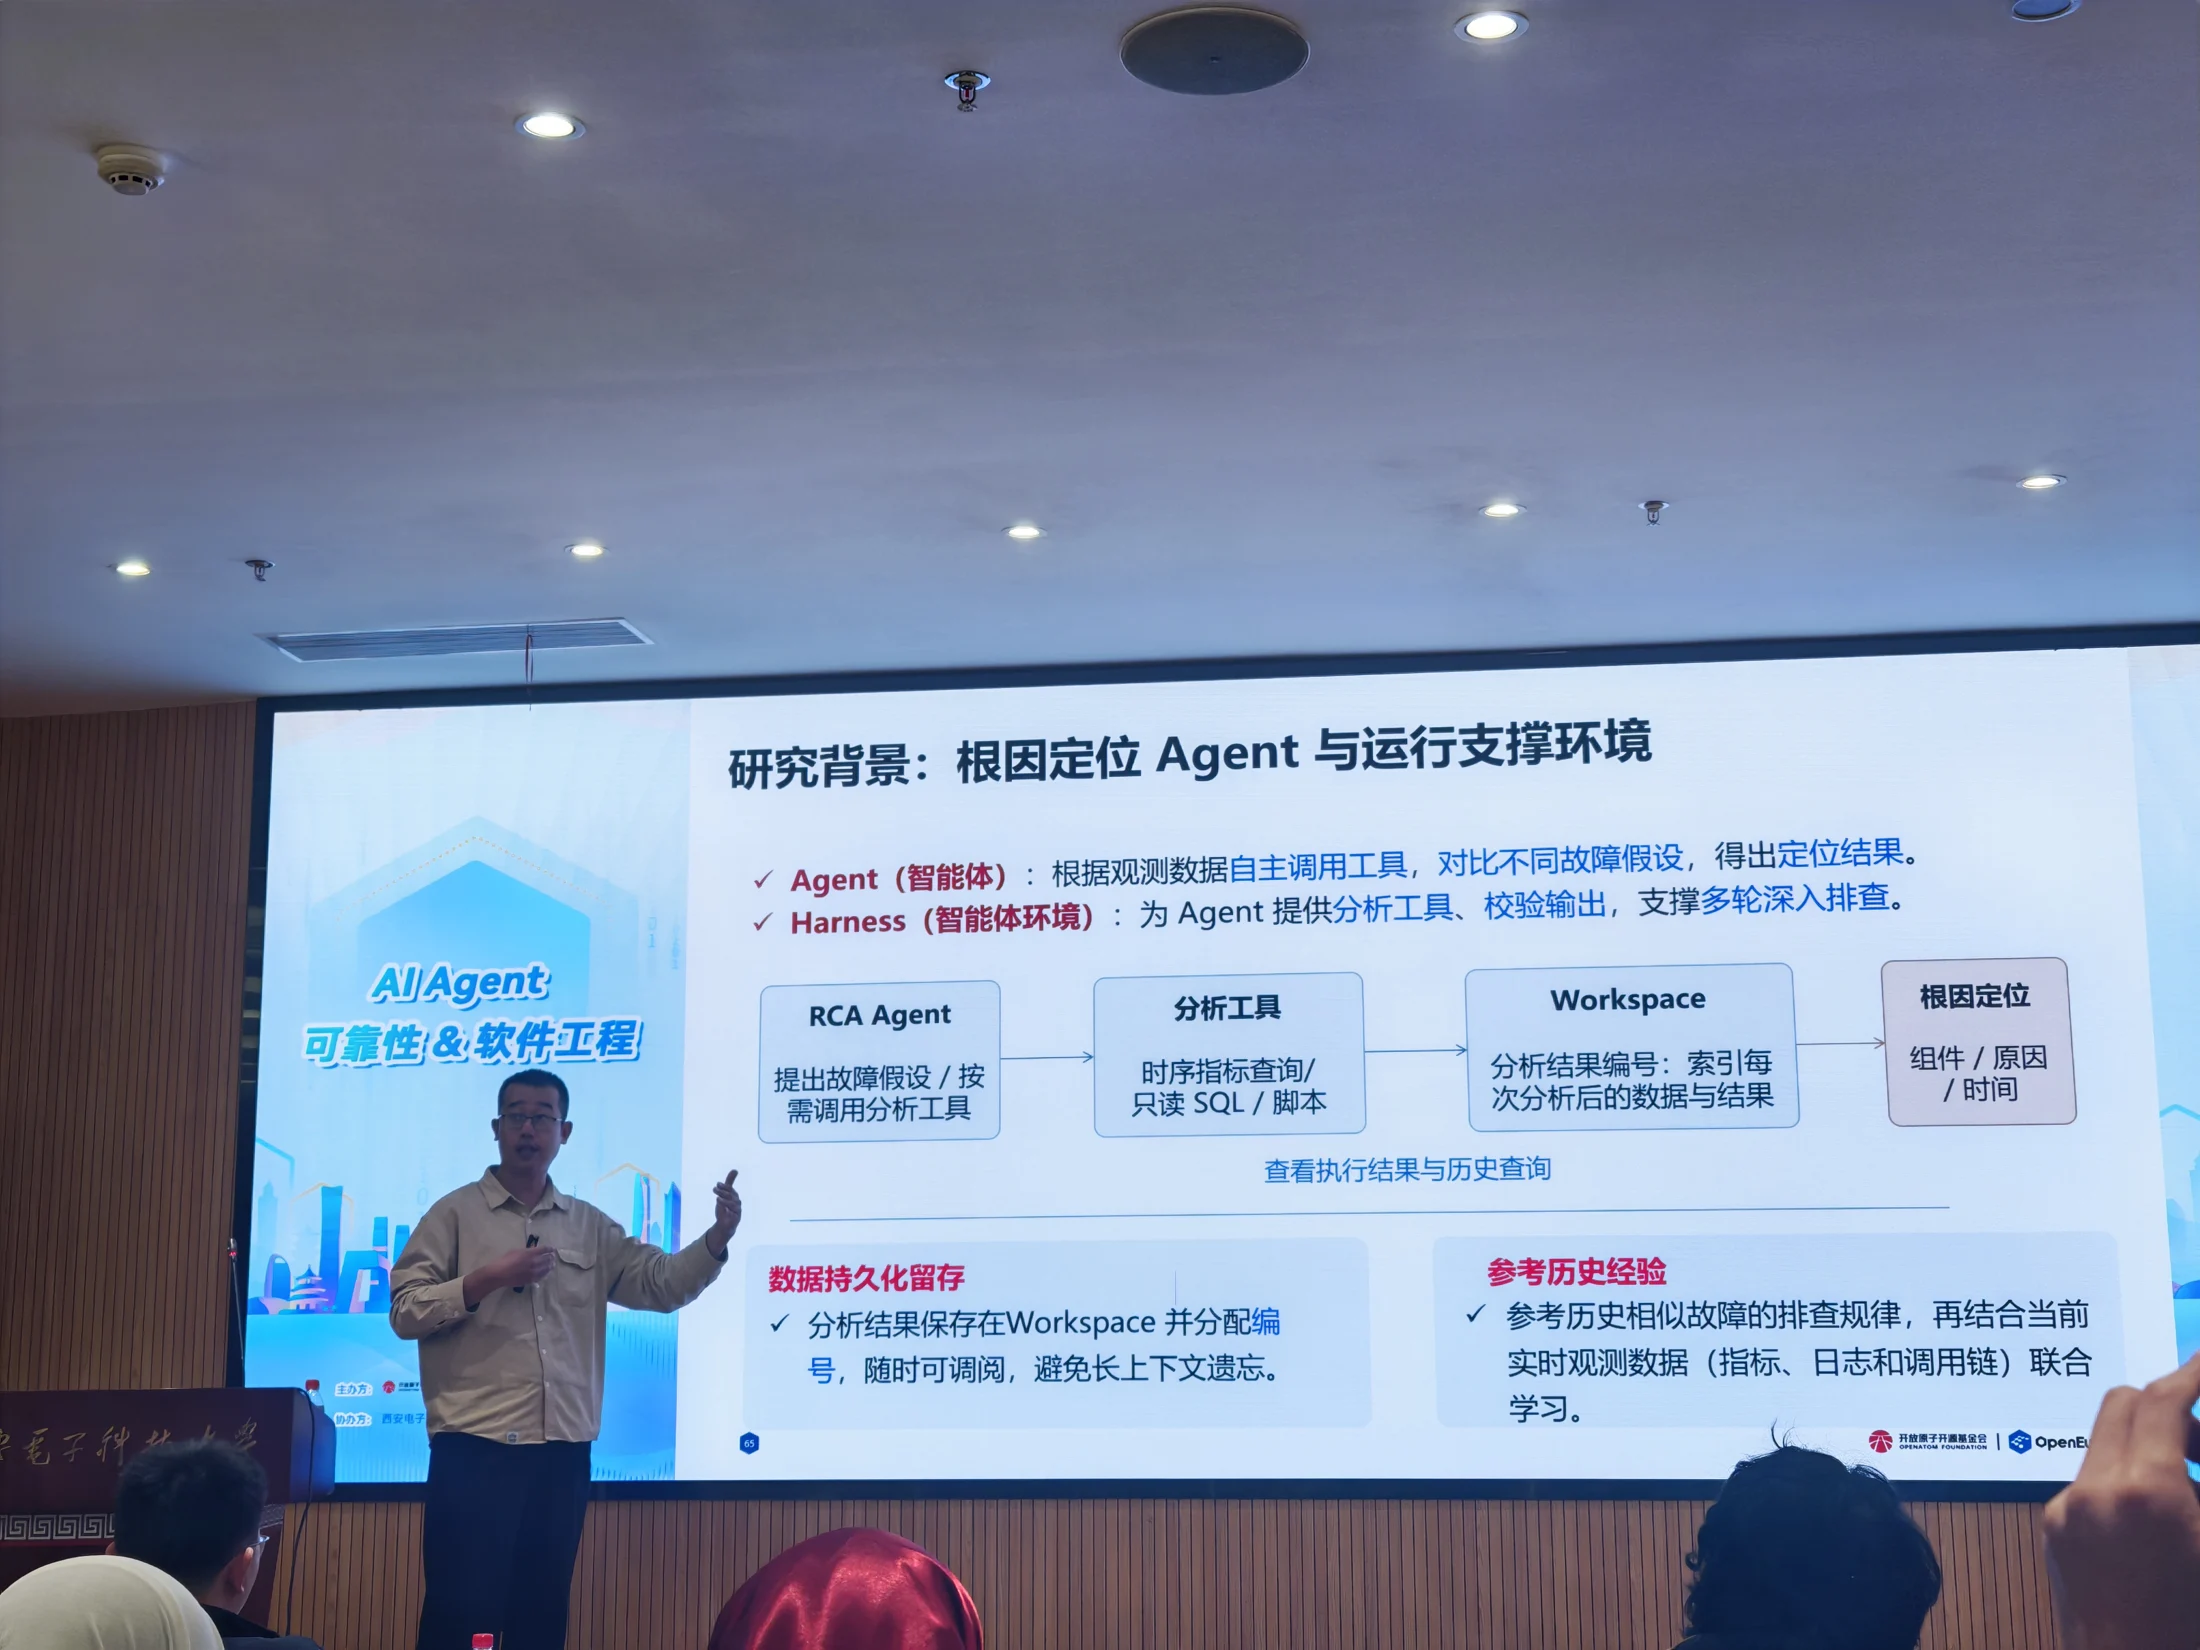
Metrics 提供数值变化,Logs 提供事件与报错,Traces 提供调用关系。异常最明显的组件可能只是受害者。RCA Agent 用工具比较假设,Harness 支持输出校验和多轮排查,Workspace 保存带编号的中间结果,历史案例供检索参考。

查看照片 IMG_20261031_145014.jpg

我不应该把“多个 Agent”理解成让几个聊天窗口讨论。协同真正有价值的地方,是让不同角色面对不同信息和目标,再由同一个可执行环境评价结果。

我在算法和课程项目中学过目标函数与约束,这些知识可以直接迁移到 Agent 工程。先写出什么绝不能违反,再讨论优化;提示词里的承诺不能代替程序校验。

排错时我容易先盯住报错最多的服务。这场报告提醒我先建立调用链和时间线,区分故障传播与真正起点;历史案例是排查线索,仍需当前数据验证。

Agent 给出的部署方案,是否通过了每一项硬约束?

  1. 写一个小型编排模拟器

    模拟少量节点、用户和微服务,把覆盖、部署、容量、唯一响应写成独立的可行性检查函数。

  2. 先比较简单基线

    先实现随机可行策略与贪心策略,再加入 Agent。记录满足率、不可行比例、时延与调用成本。

  3. 做一次故障定位实验

    用本地容器服务注入延迟或资源限制,保存指标、日志与调用链,输出根因假设、支持证据和反证。

展开这场的 18 张现场照片

照片保持原始画面比例;点击放大,放大后可在新标签打开图片继续缩放。原始文件保留在原文件夹。
SaaS 双线 Agent 化概念示意图

冯智超
金数据技术负责人

14:55–15:30
议程时间,以会议海报为准

从工具到智能体:一家 SaaS 公司的产品与研发双线 Agent 化工程实践

人设计循环,Agent 在循环里执行。

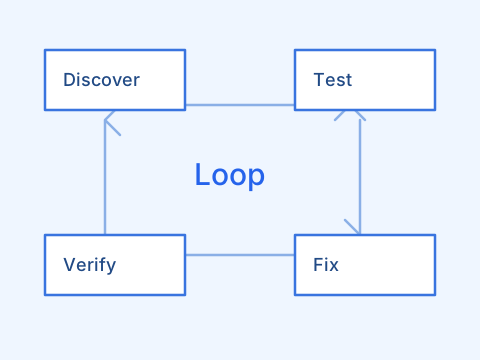
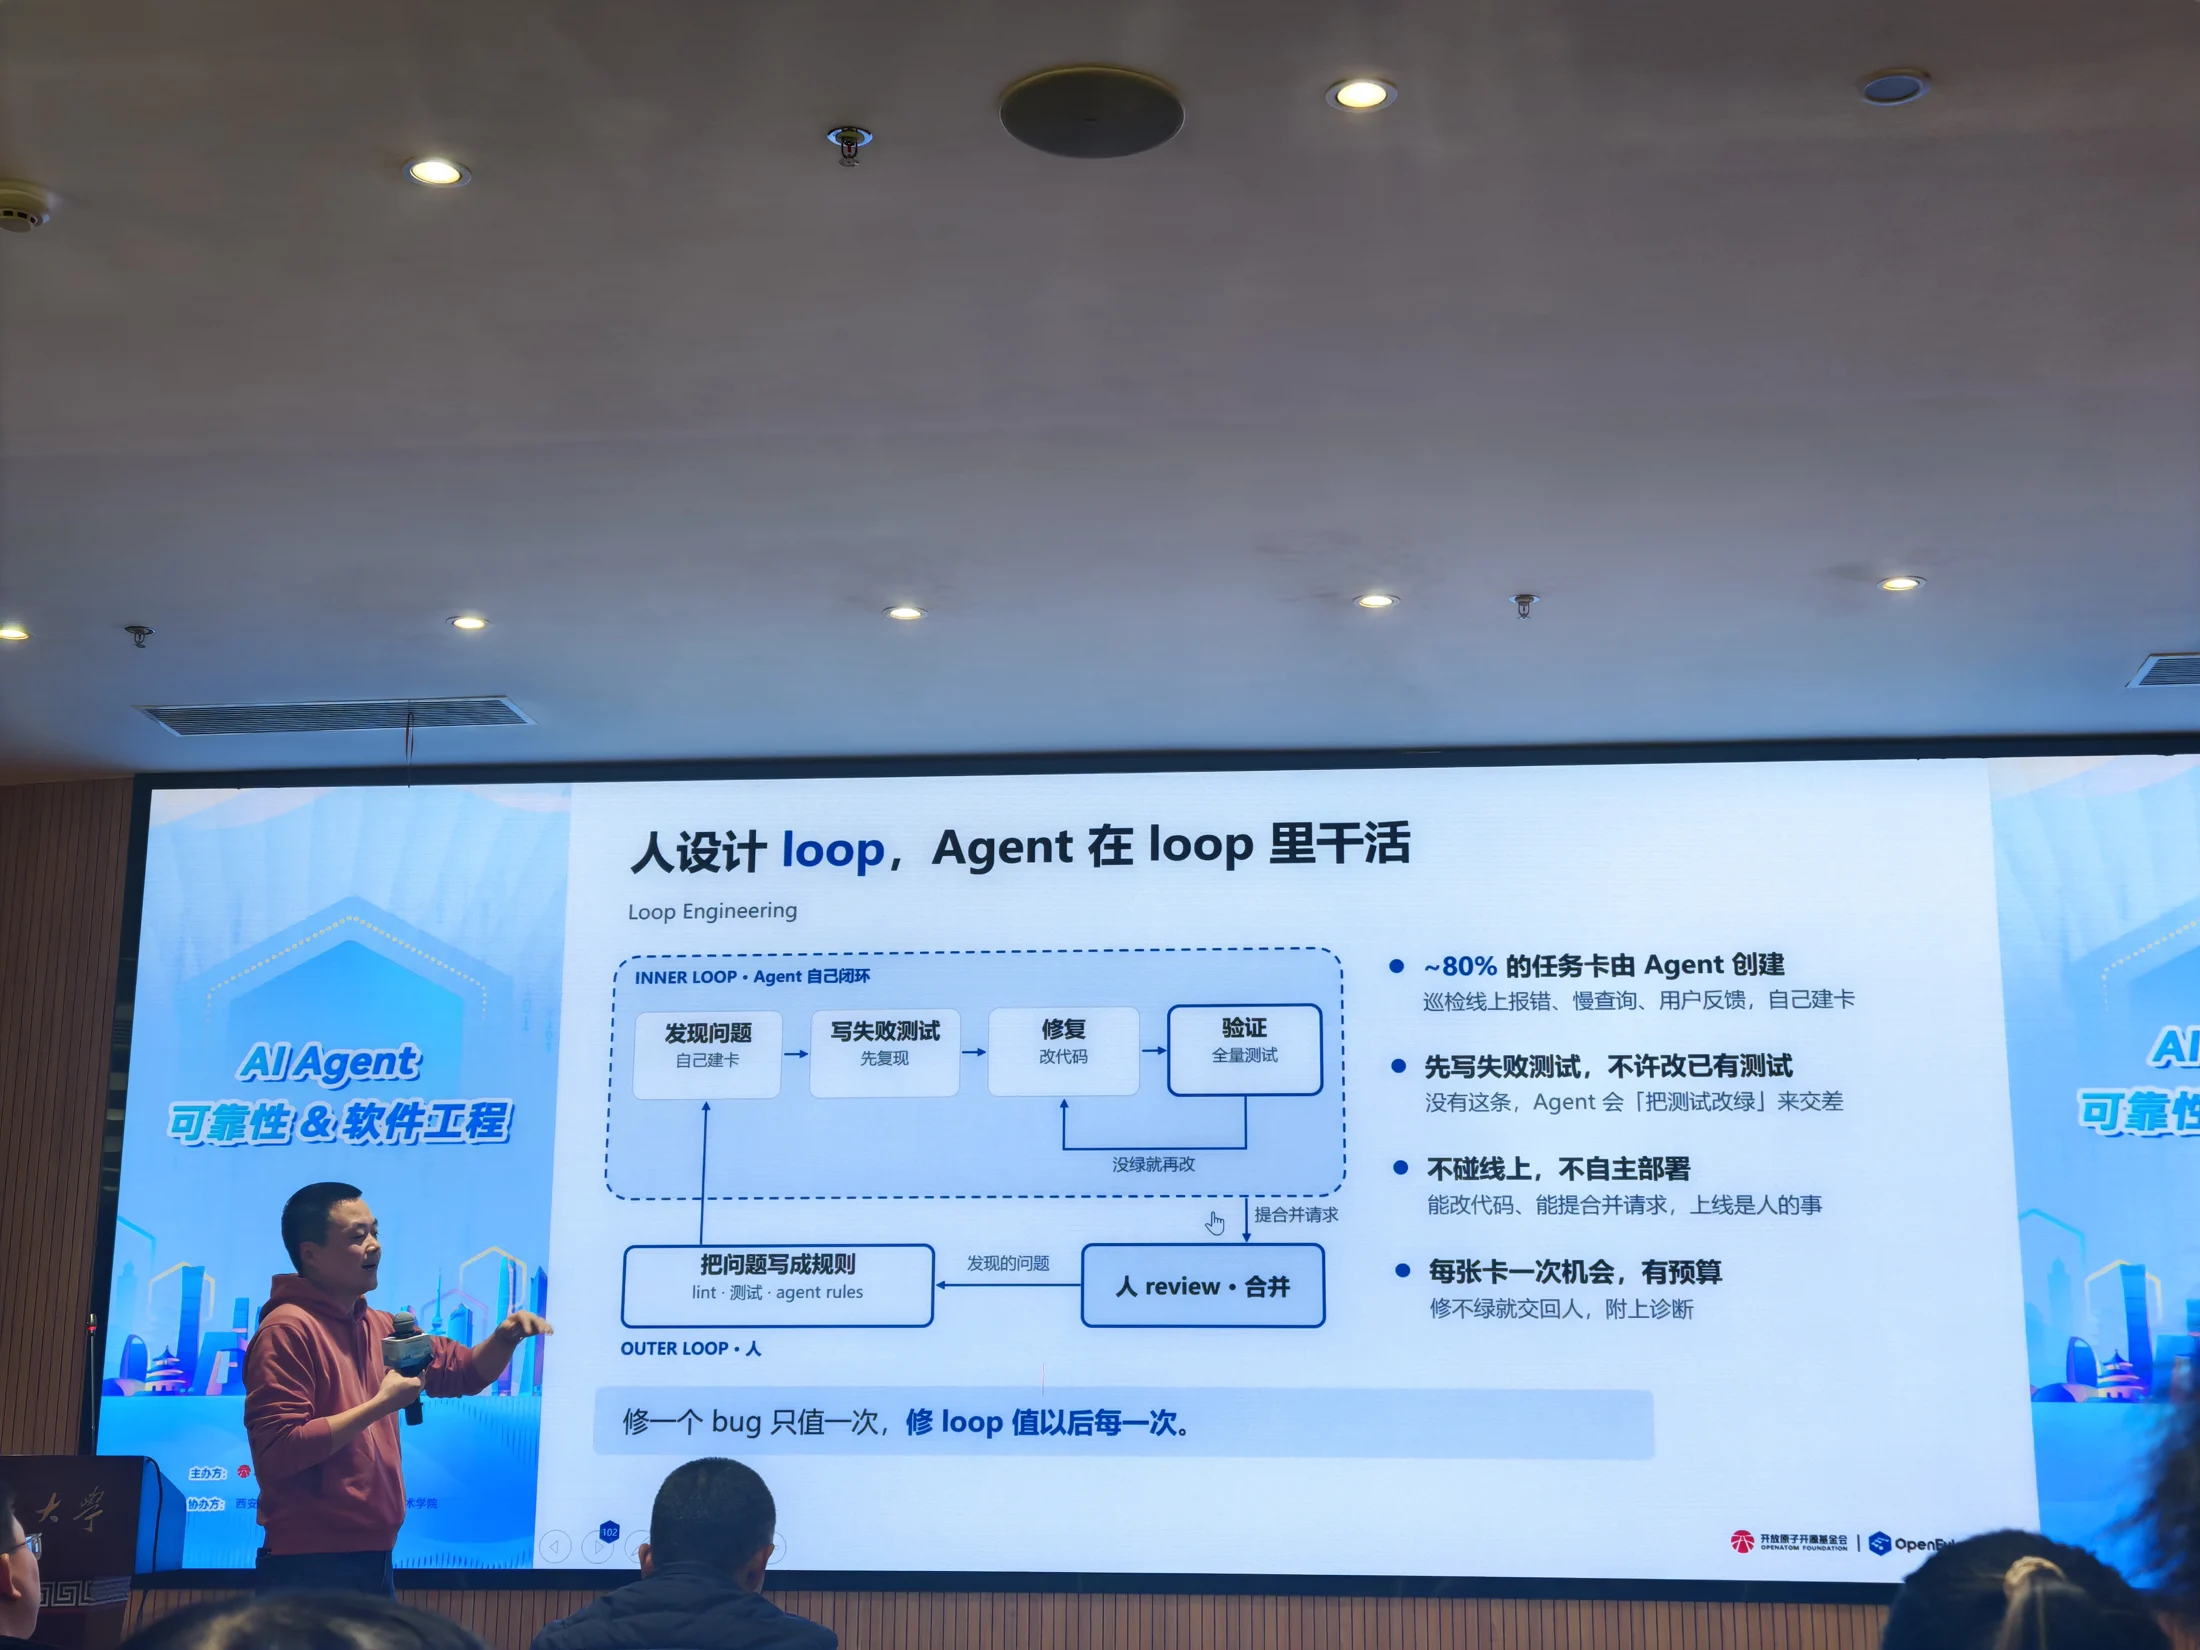
这场只有一张现场照片,能确认的核心是 Loop Engineering:Agent 内循环处理问题,人负责外循环审查、合并,并把反复出现的问题沉淀为规则。标题说明产品与研发双线,但现有照片主要支撑研发实践。

材料边界:只有 IMG_20261031_151940.jpg 一张材料;产品线细节、Agent 创建任务比例的统计口径和最终经营效果均无法确认。

内循环:发现、复现、修复、验证

图中 Agent 可以自己发现问题、先写失败测试、进行修复,再运行验证;验证失败则继续修复,通过后提交合并请求。该循环把“修好了”的主张变成可检查的结果。

查看照片 IMG_20261031_151940.jpg

外循环:人审查并改进规则

人 review 和合并,把发现的问题写成 lint、测试或 Agent 规则,再反馈到执行过程。单次补丁解决一次问题,改进流程可以降低后续同类错误的发生机会。

查看照片 IMG_20261031_151940.jpg

测试与部署边界清晰

照片写明先写失败测试、不许改已有测试,以及不碰线上、不自主部署;没有约束时 Agent 可能为了交差改变测试。这是案例中的工程边界,不是对所有场景的统一部署政策。

查看照片 IMG_20261031_151940.jpg

循环有预算与停止条件

照片强调“再长一次机会,有预算”,仍不行就交回人处理并附诊断。约 80% 任务由 Agent 创建也是讲者在该场景中的经验描述,照片没有给出统计周期或计算口径。

查看照片 IMG_20261031_151940.jpg

我以前可能把一次又一次追问当作迭代,但如果没有失败测试、预算和退出条件,迭代很容易变成无止境试错。我应该设计每一轮怎样判断进步。

对自己的学习项目,最有价值的做法是先把一个真实 bug 稳定复现,再让 Agent 修复,最后把这个用例保留下来。这样留下的是项目能力,而不仅是一段对话。

我可以从标题思考产品工作流如何 Agent 化,但不能据这一张照片推断金数据的产品功能、客户效果或公司内部完整架构。下面的行动建议是我的延伸方案。

下一次同类问题出现时,流程能否自动发现它?

  1. 给现有 bug 建立失败测试

    保留原有测试,先确认新增用例确实失败,再让 Agent 修复到通过,保存前后两份运行结果。

  2. 明确一次执行的预算

    在任务里规定最多尝试轮数或最长时间,失败时输出原因、已尝试方案和下一步建议。

  3. 建立外循环复盘

    每次合并写下遗漏原因,选择能转为检查的一项加入测试或 lint;人工审查后再发布。

展开这场的 1 张现场照片

照片保持原始画面比例;点击放大,放大后可在新标签打开图片继续缩放。原始文件保留在原文件夹。
Linux 设备建模与测试概念示意图

于斌
西安电子科技大学计算机科学与技术学院副教授、硕导

15:50–16:25
议程时间,以会议海报为准

LLM 辅助的 Linux 驱动虚拟设备建模与模糊测试

先让驱动走进去,才能测试更深的路径。

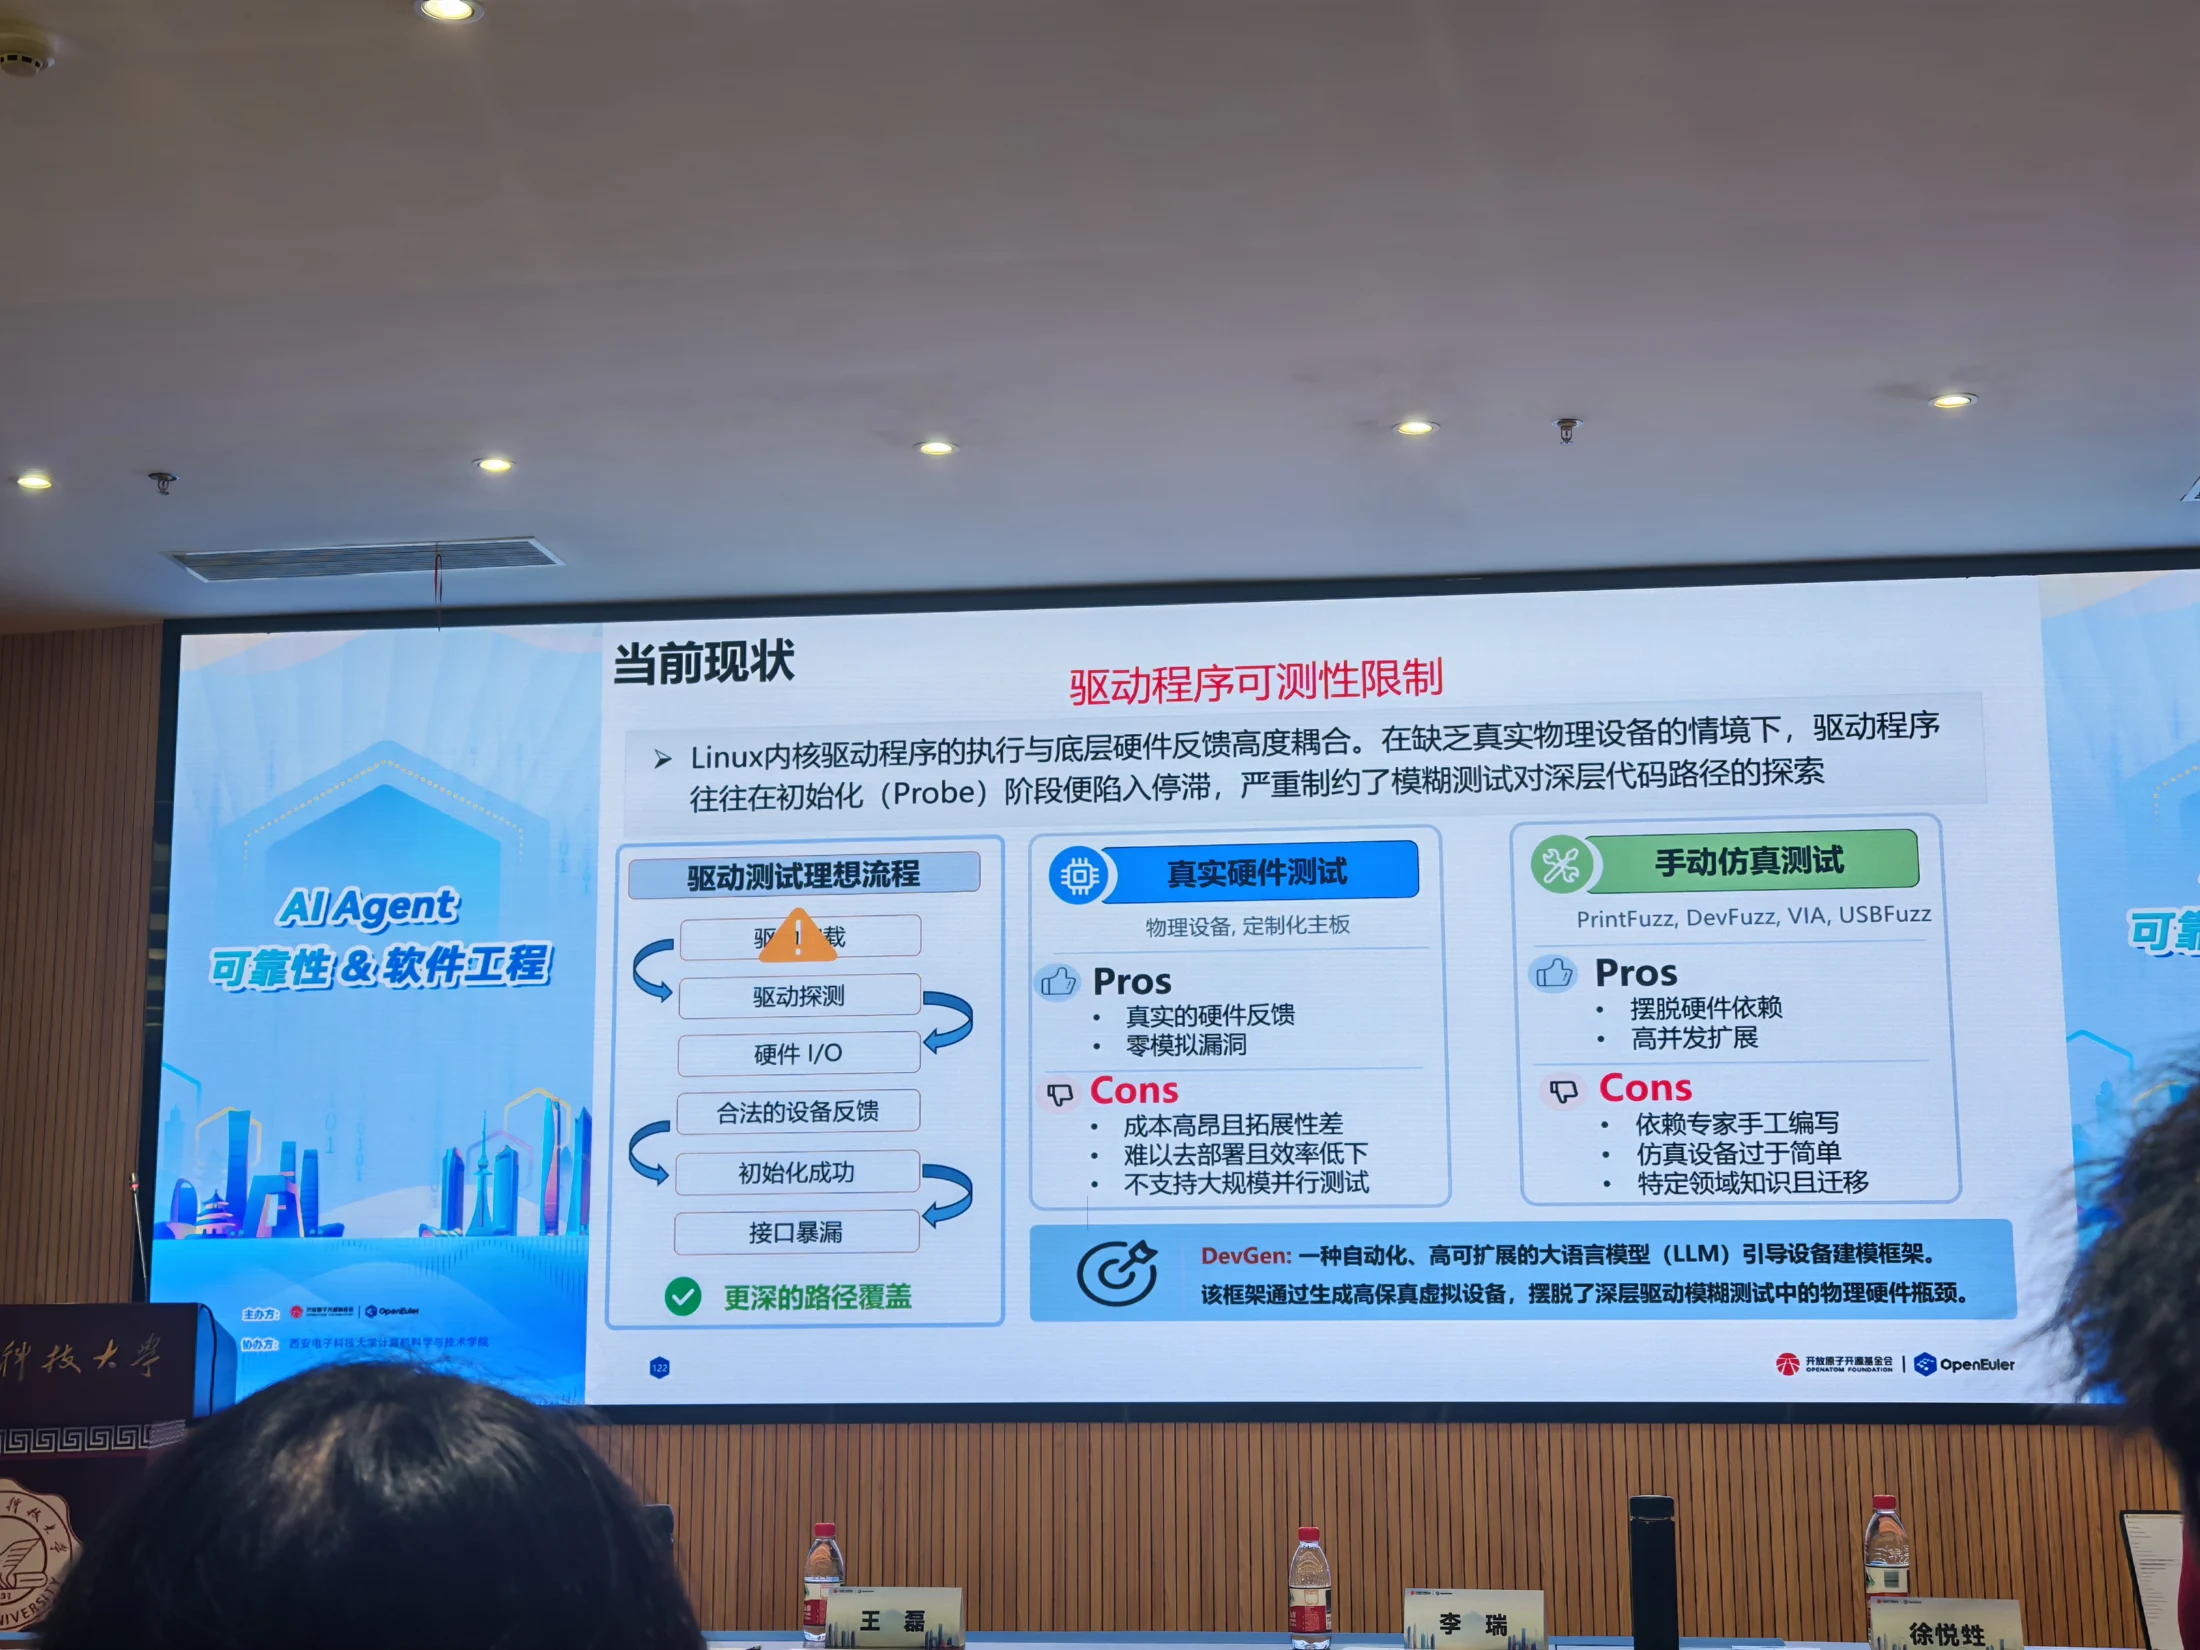
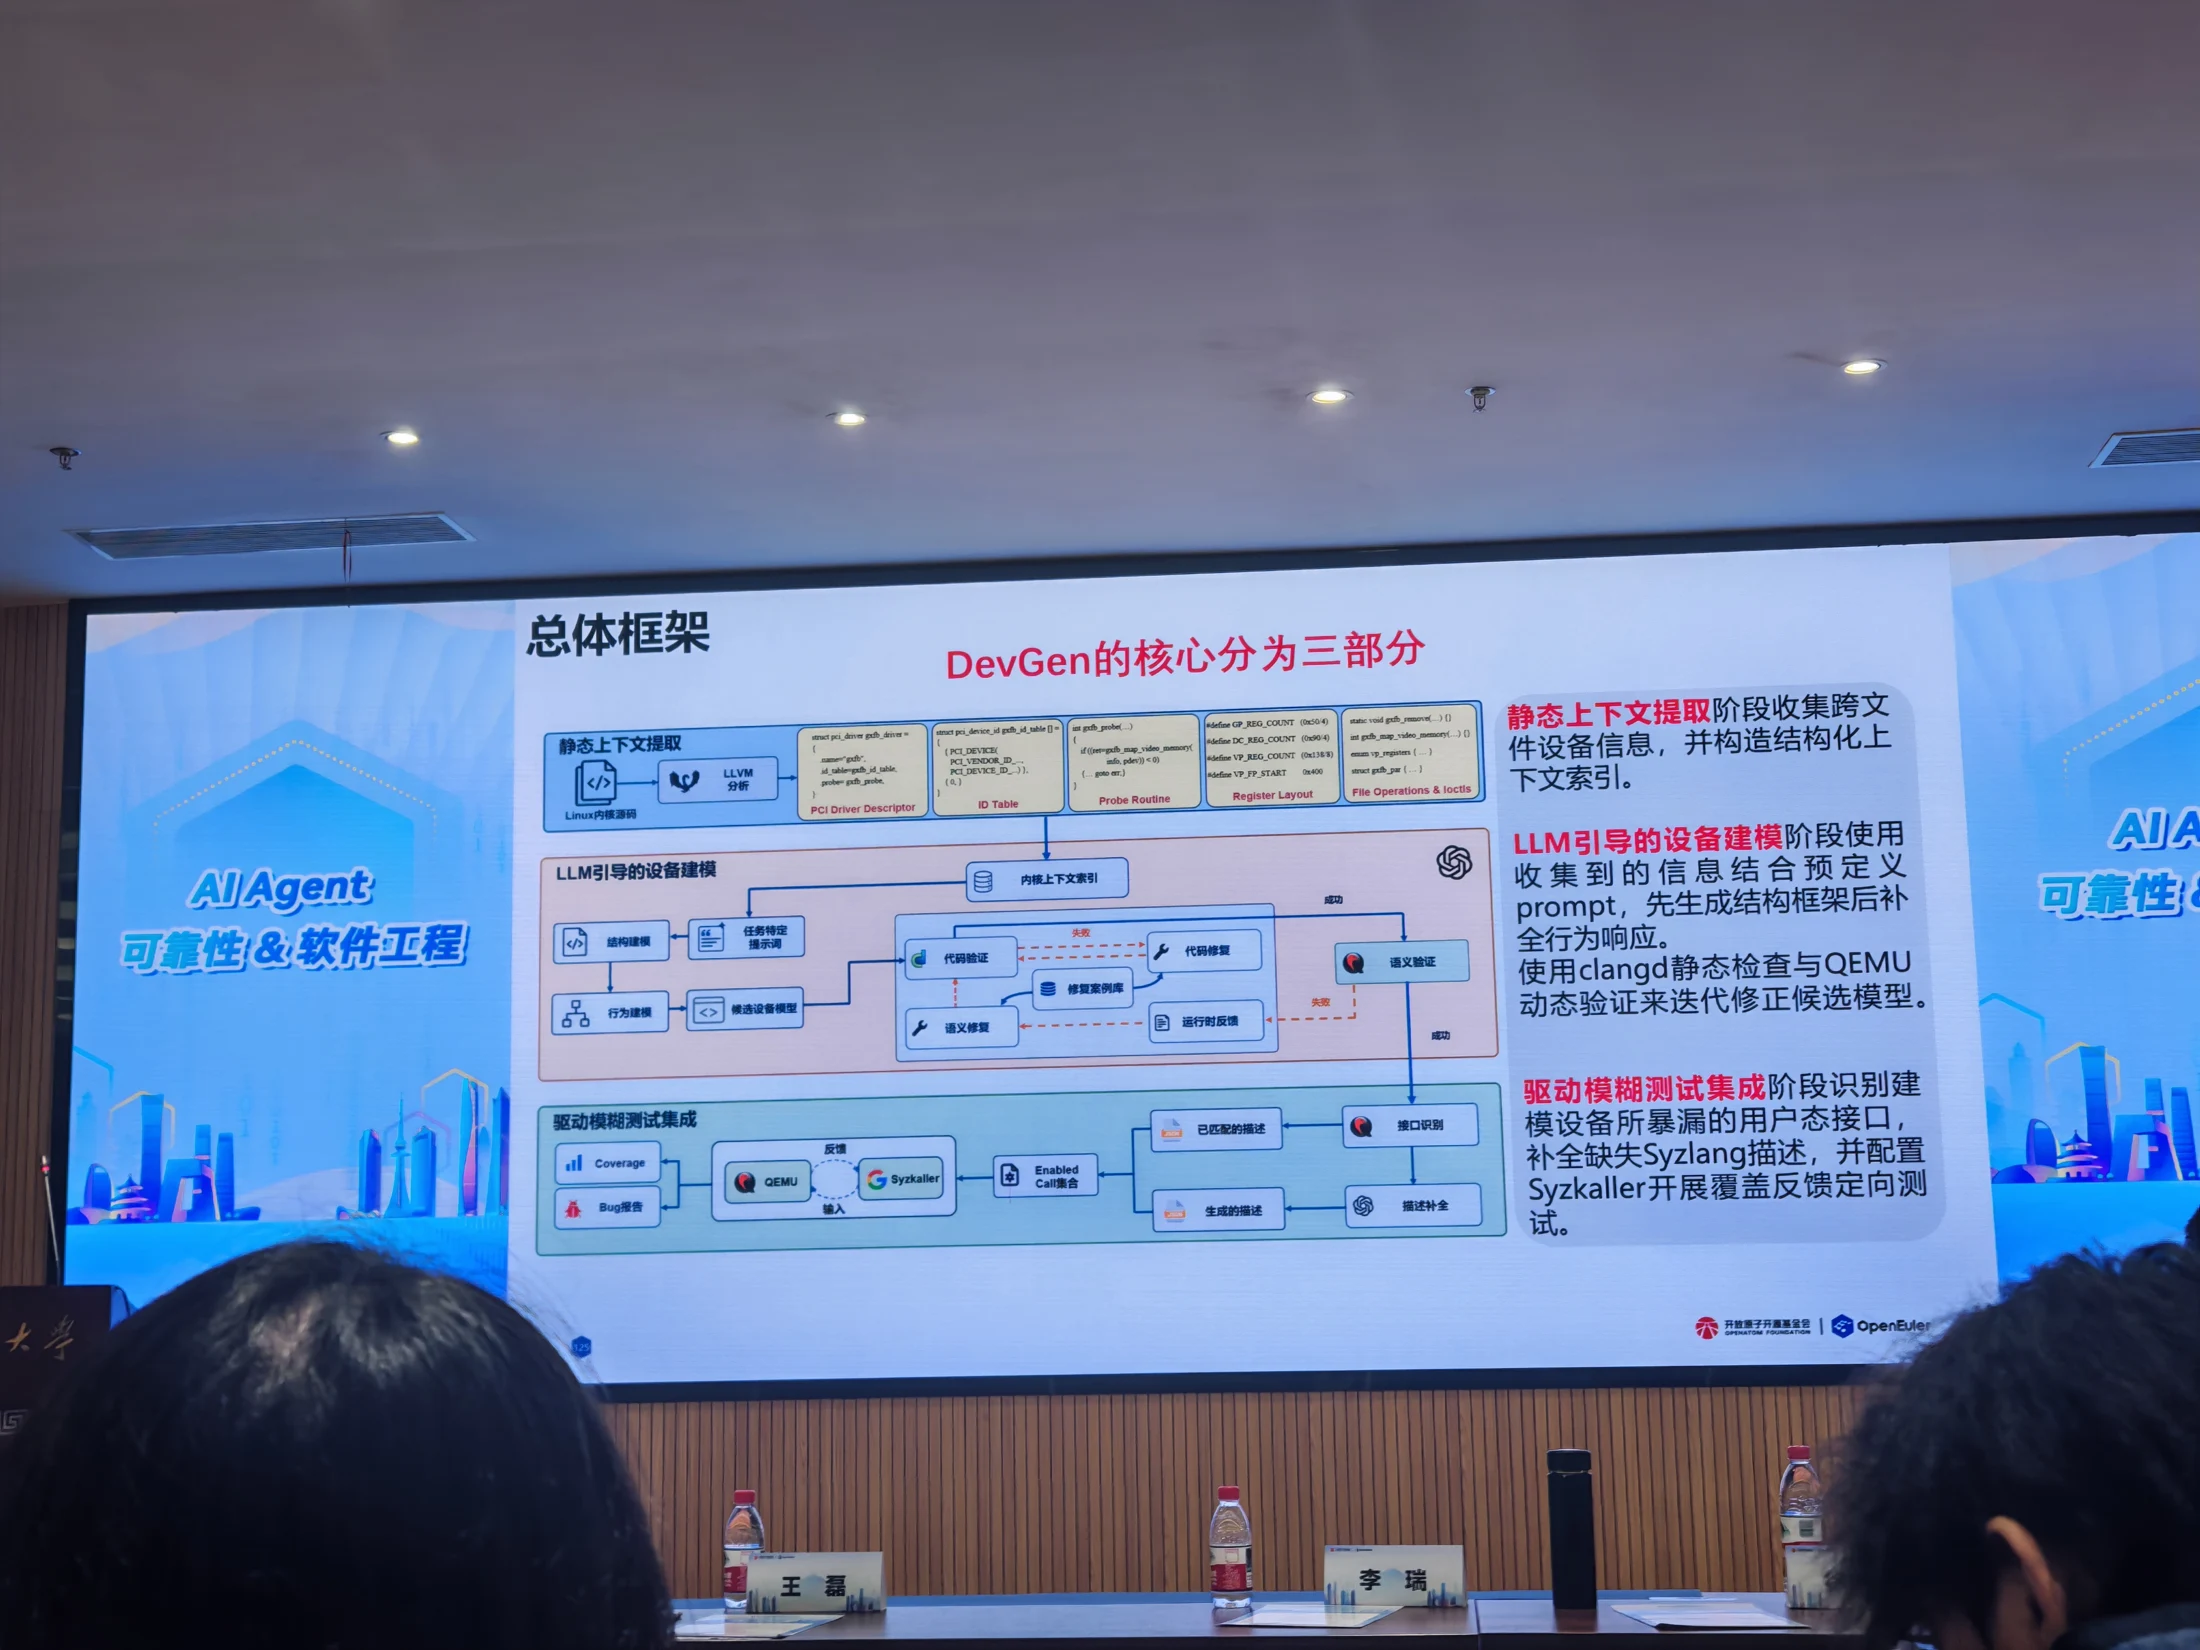
报告中的 DevGen 以 LLM 辅助生成虚拟设备模型,结合静态分析、编译诊断、QEMU 运行反馈与 Syzkaller,将驱动可测性与有效测试输入一起纳入闭环。

材料边界:照片展示的是方法框架及进行中的方向,没有完整性能结果。不能据此声称已发现多少新漏洞,也不能把虚拟模型等同真实硬件。

驱动加载不等于设备已就绪

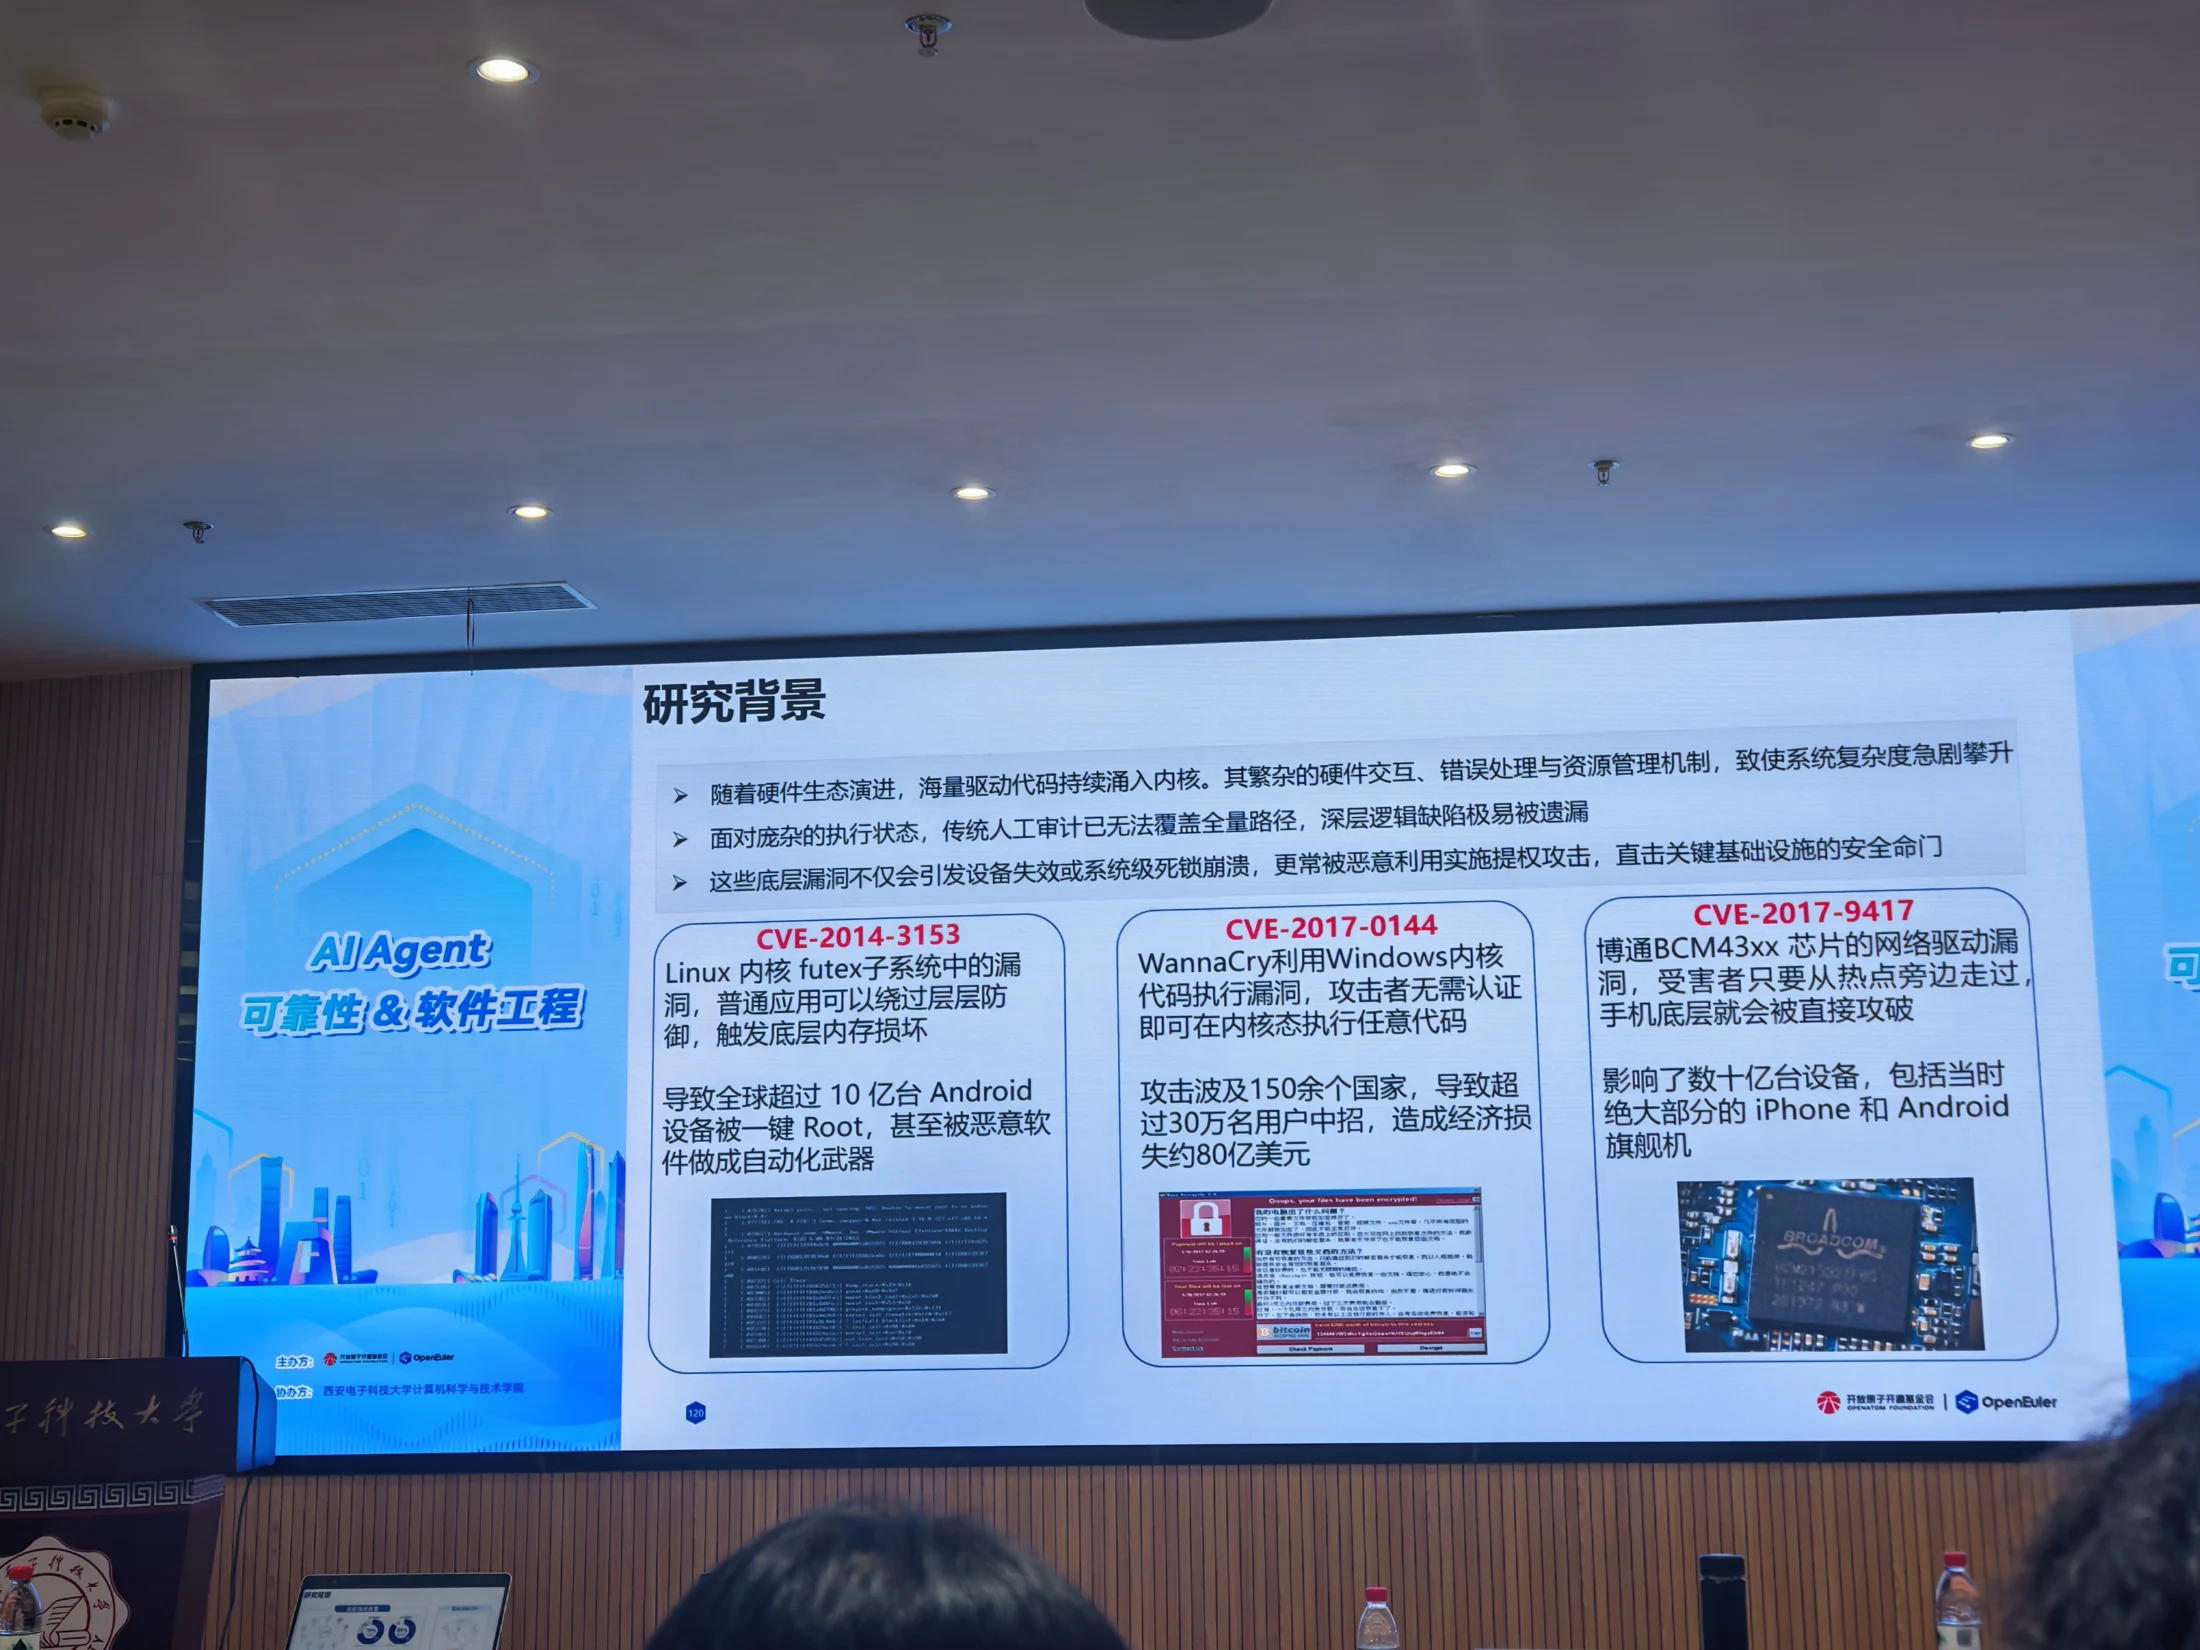
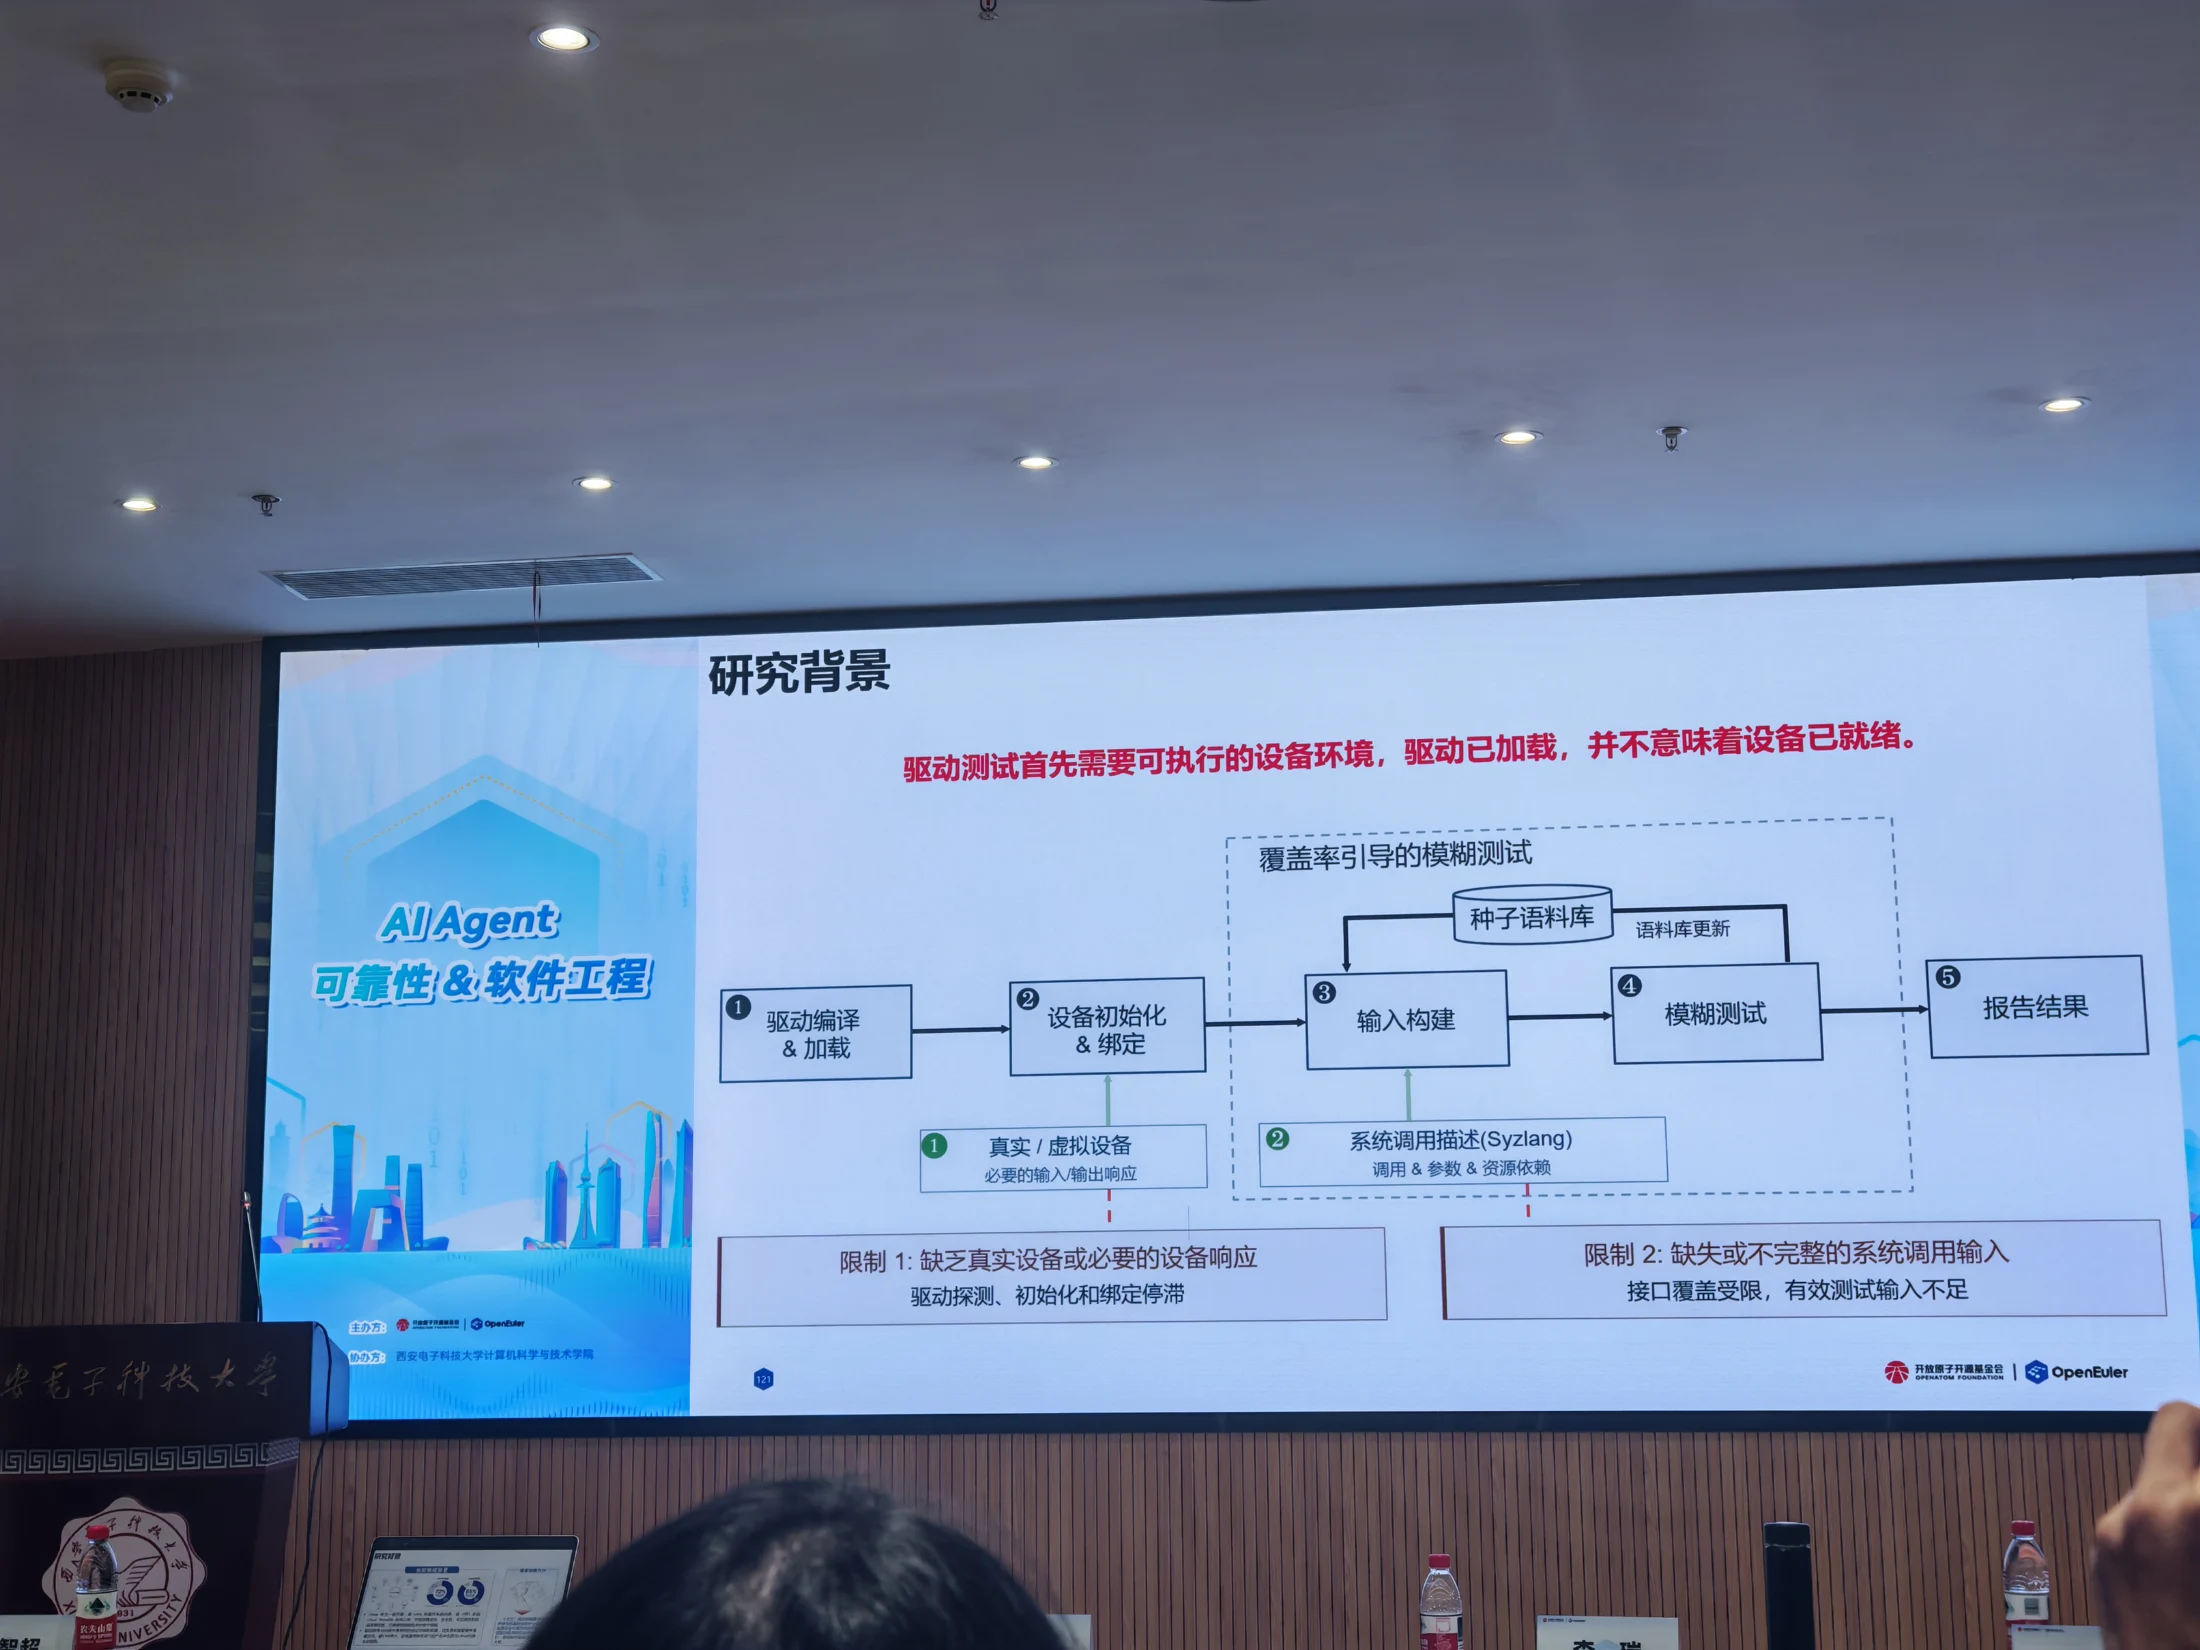
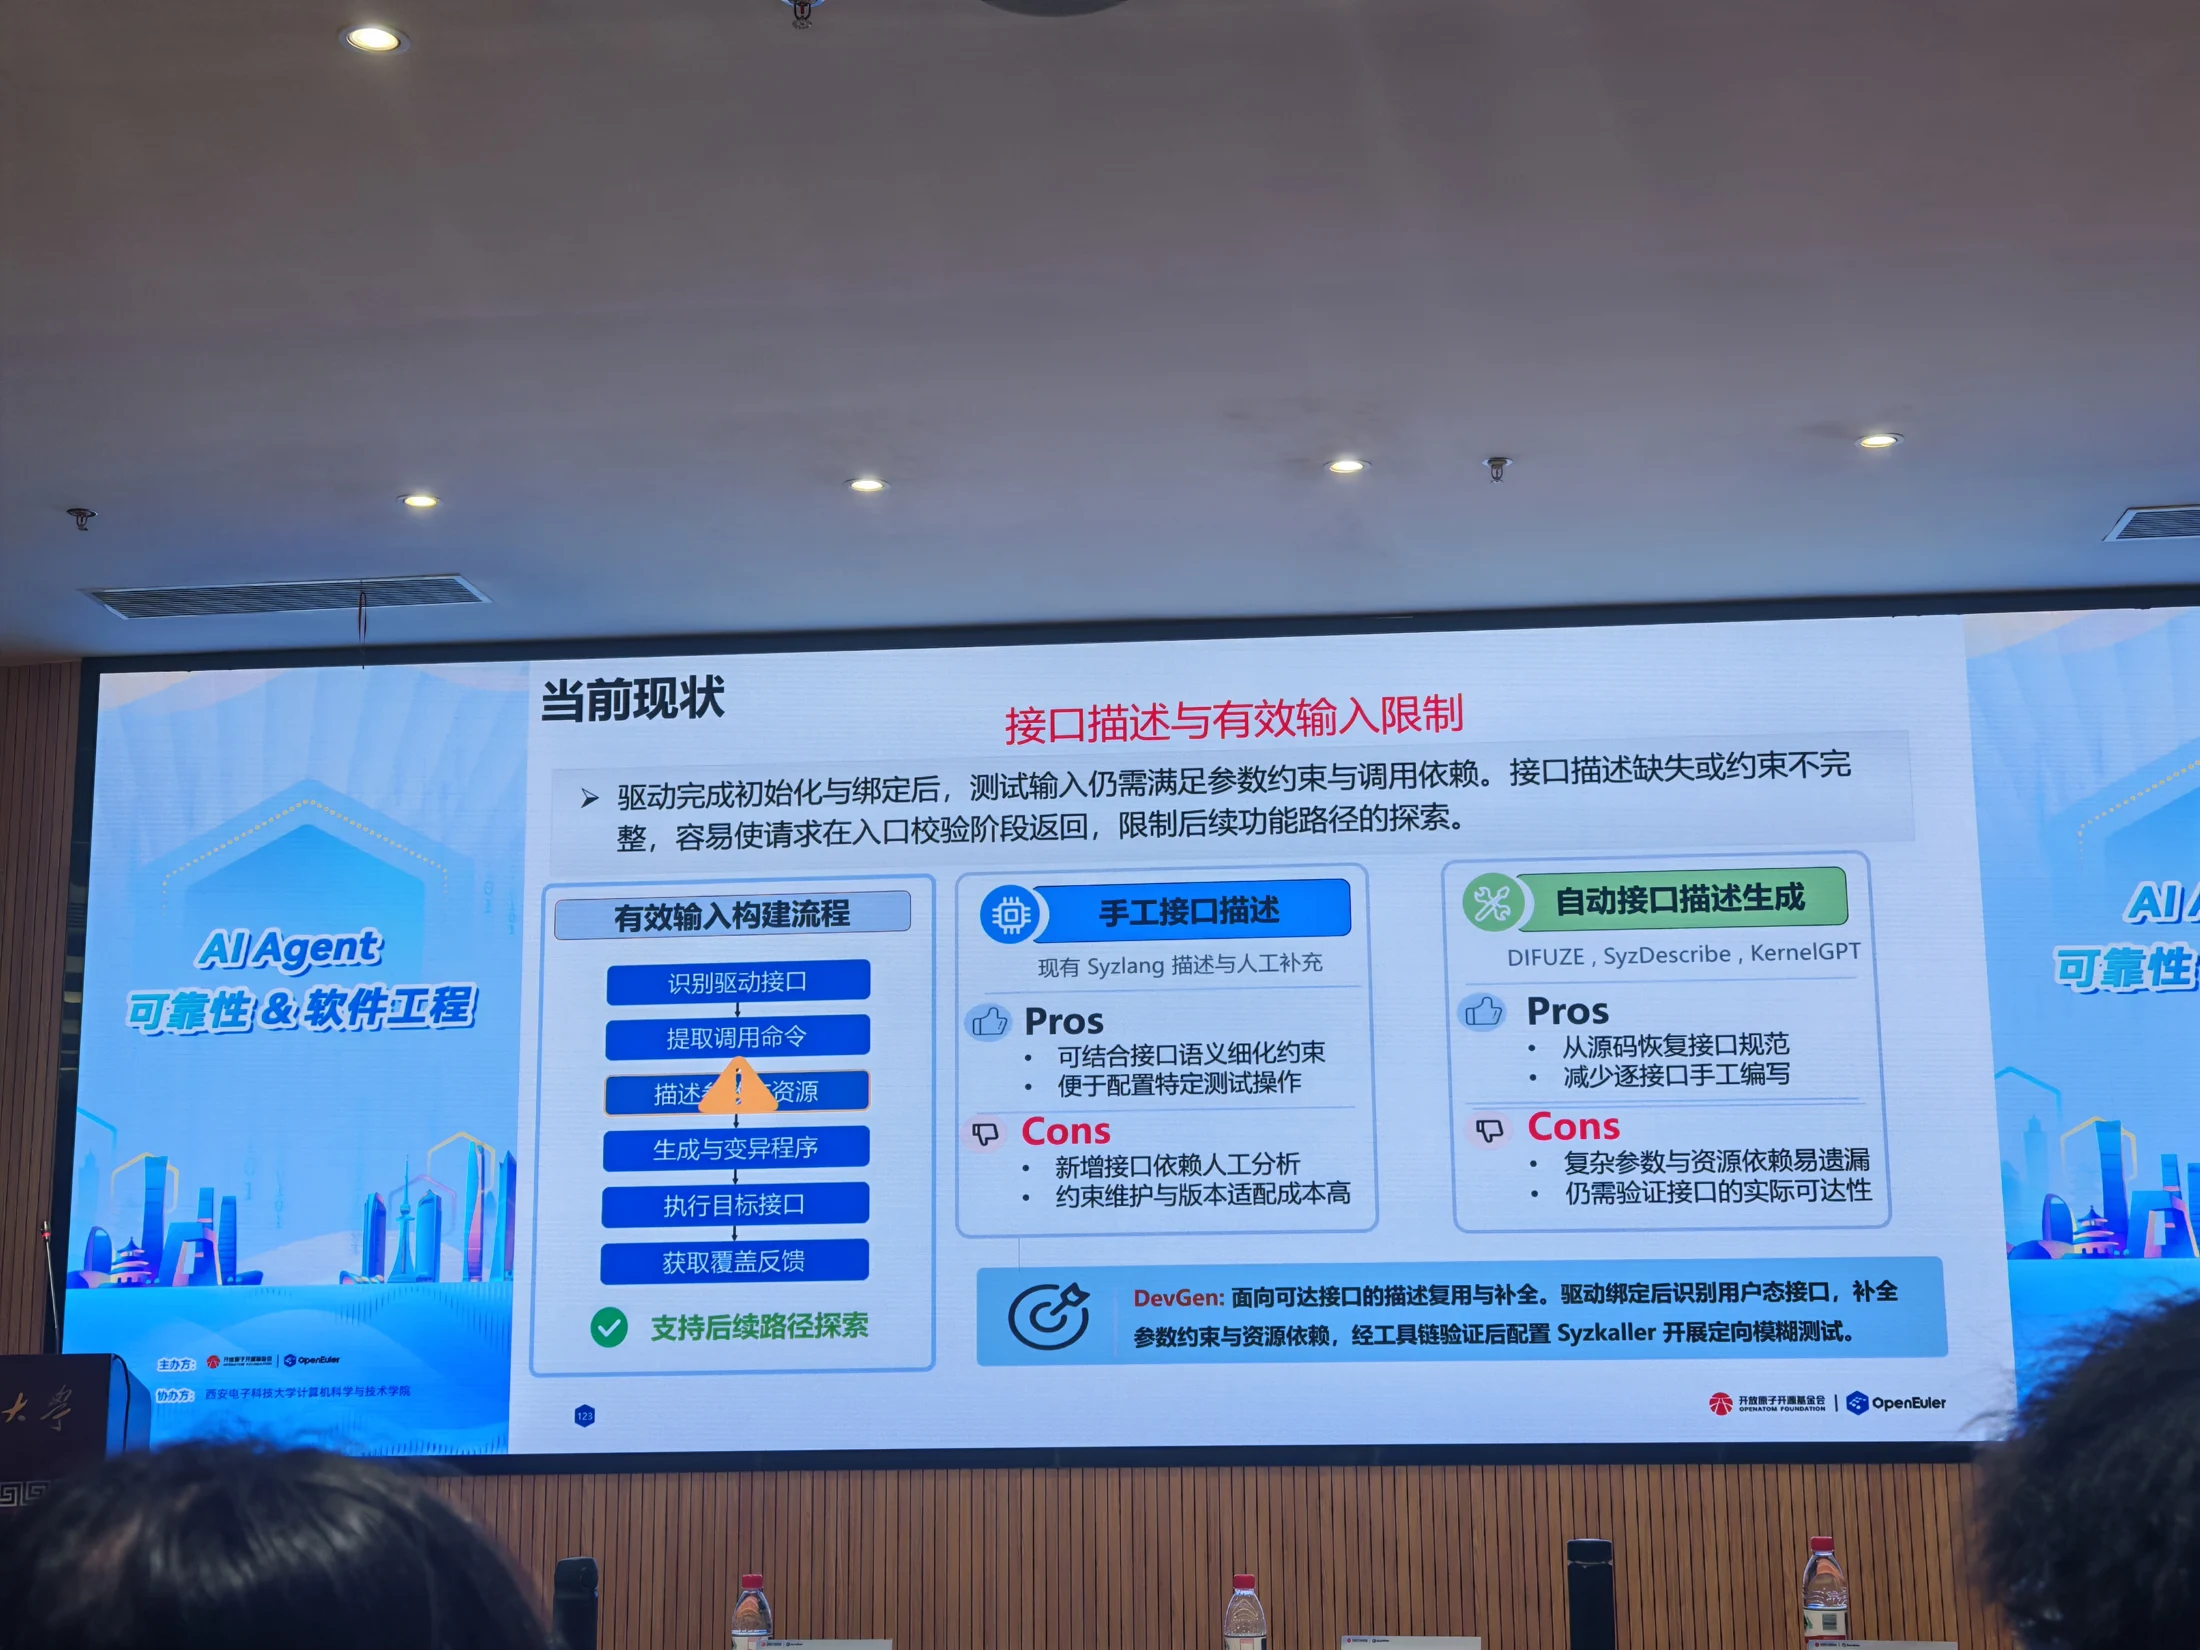
驱动与硬件交互紧密,缺少设备响应时可能卡在初始化或 probe,深层路径无法执行。另一侧,即便初始化成功,接口描述缺失和参数依赖错误也会让测试输入在入口被拒绝。

查看照片 IMG_20261031_160235.jpg

静态上下文提取减少猜测

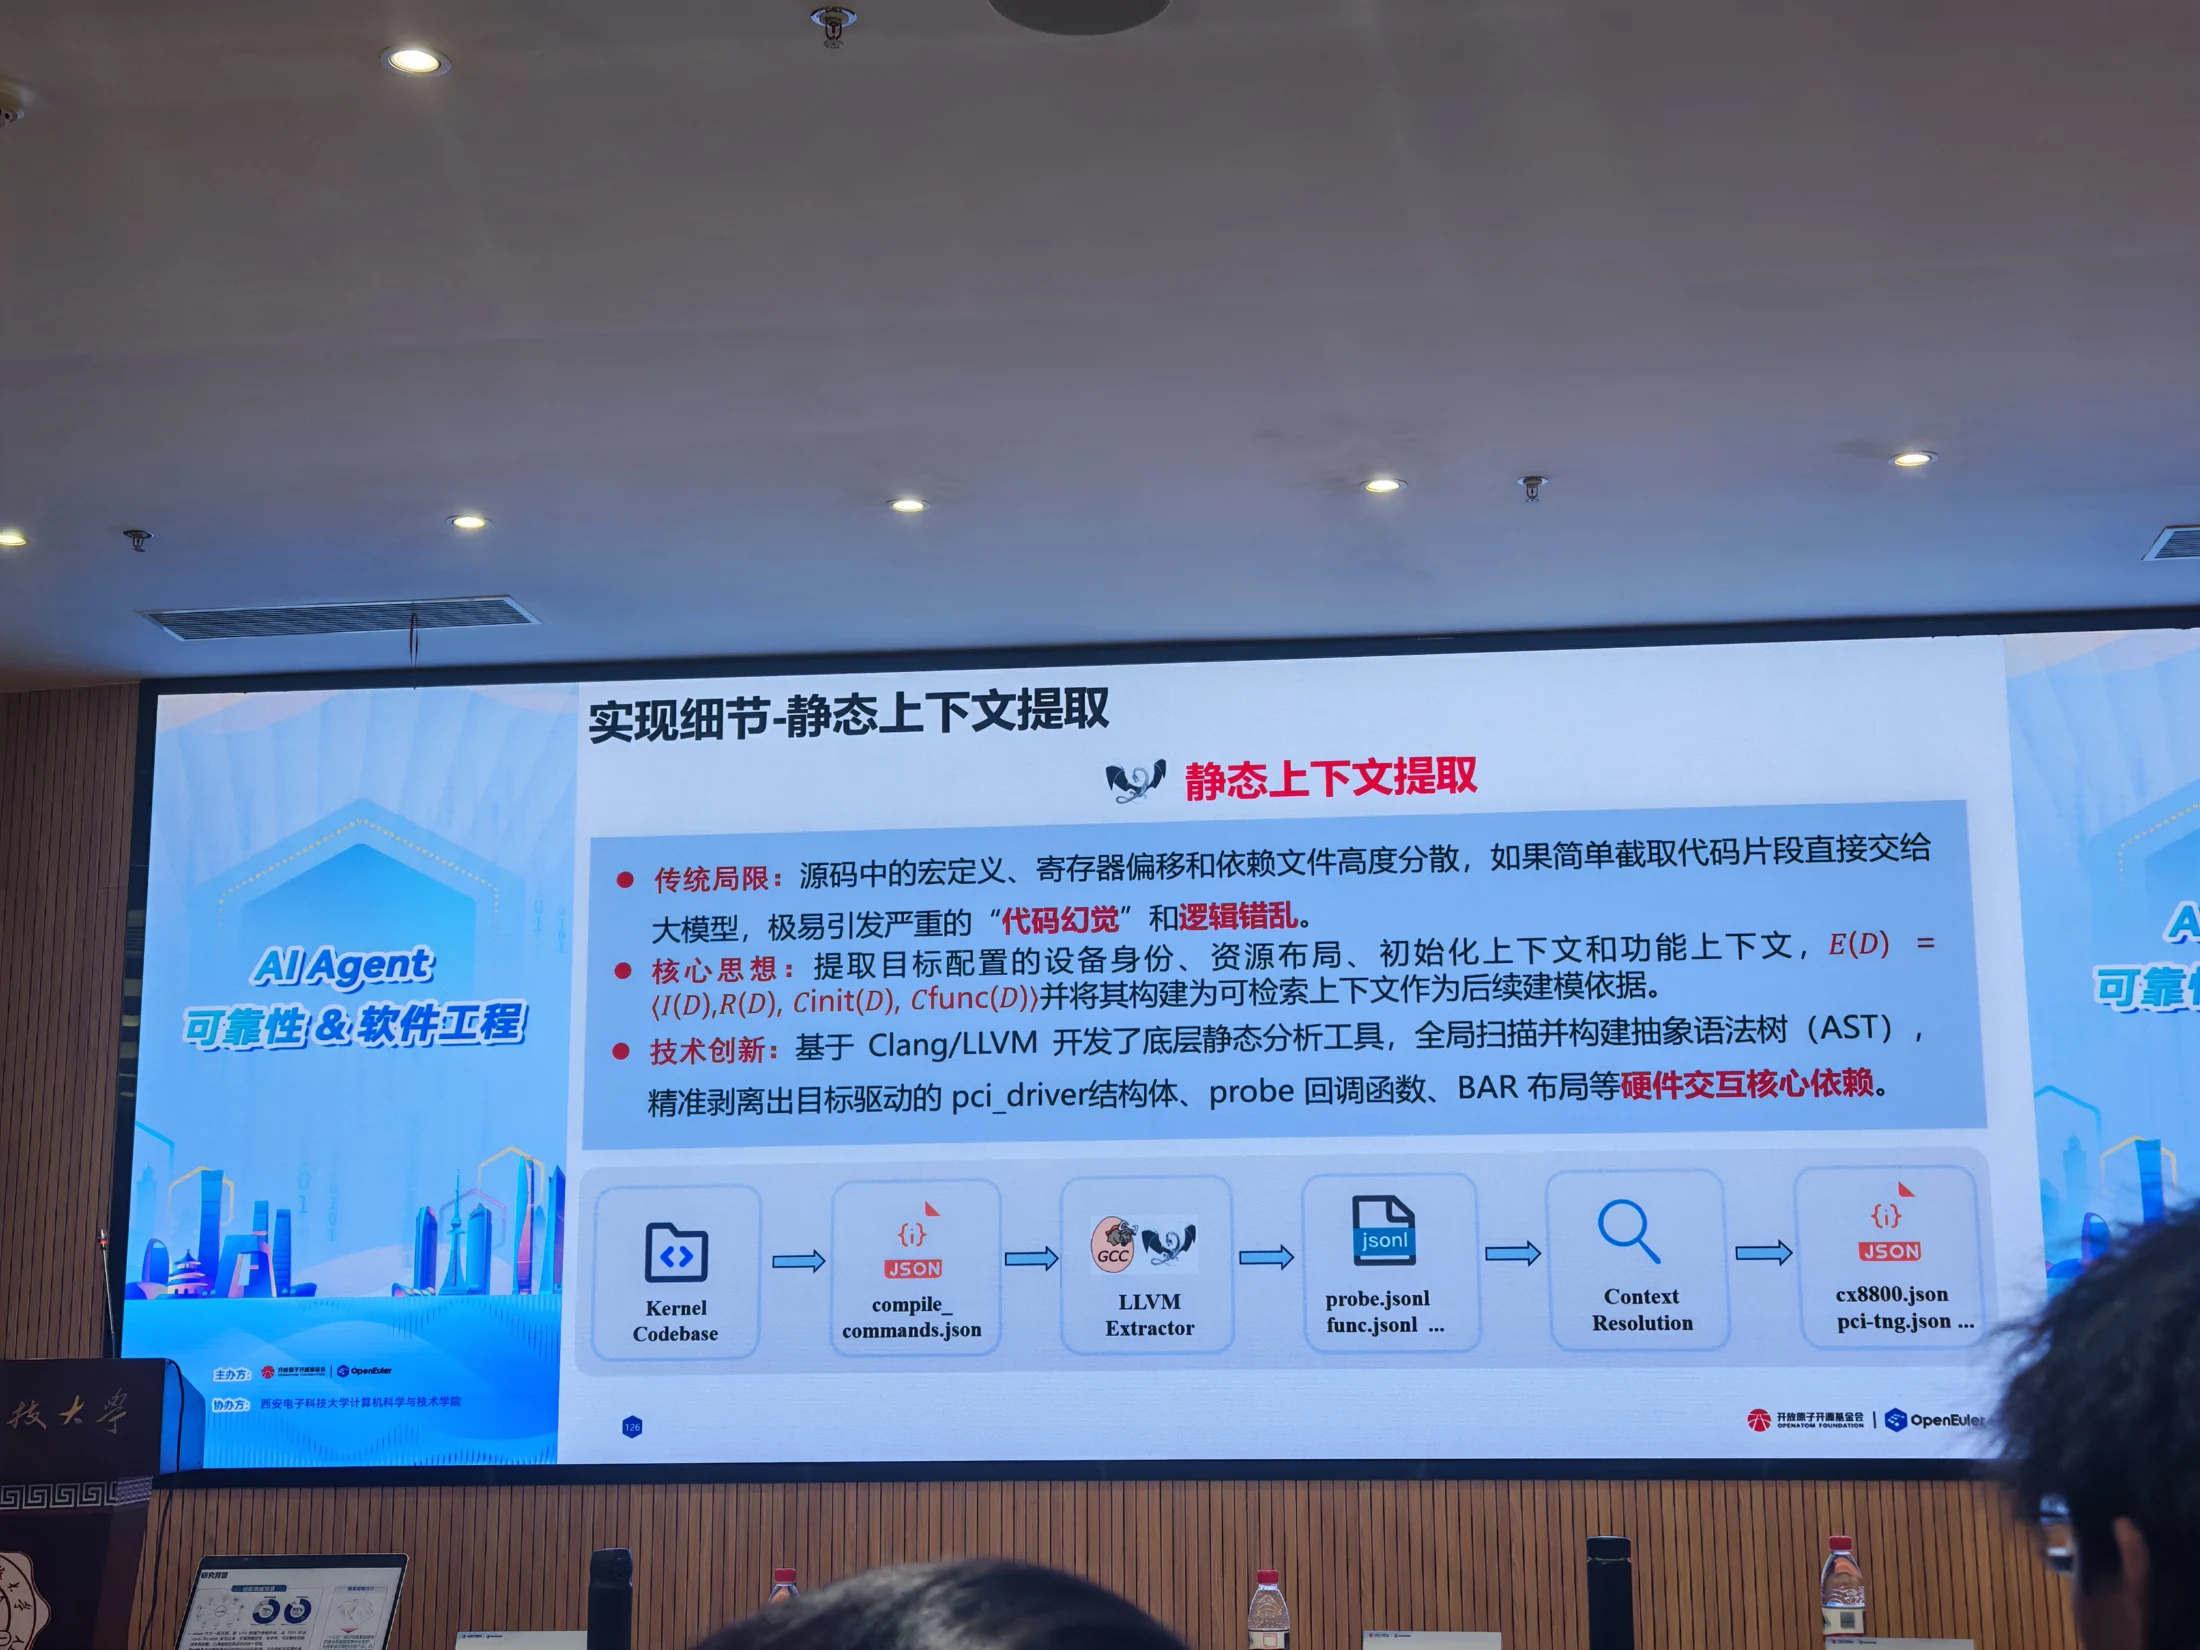
材料通过 Clang/LLVM 分析源码,提取设备身份、寄存器与资源布局、初始化上下文及功能上下文,形成结构化 JSON 索引。重点是跨文件依赖与硬件交互信息,而非随意截取一段代码喂给模型。

查看照片 IMG_20261031_161255.jpg

LLM 按阶段建模并接受反馈

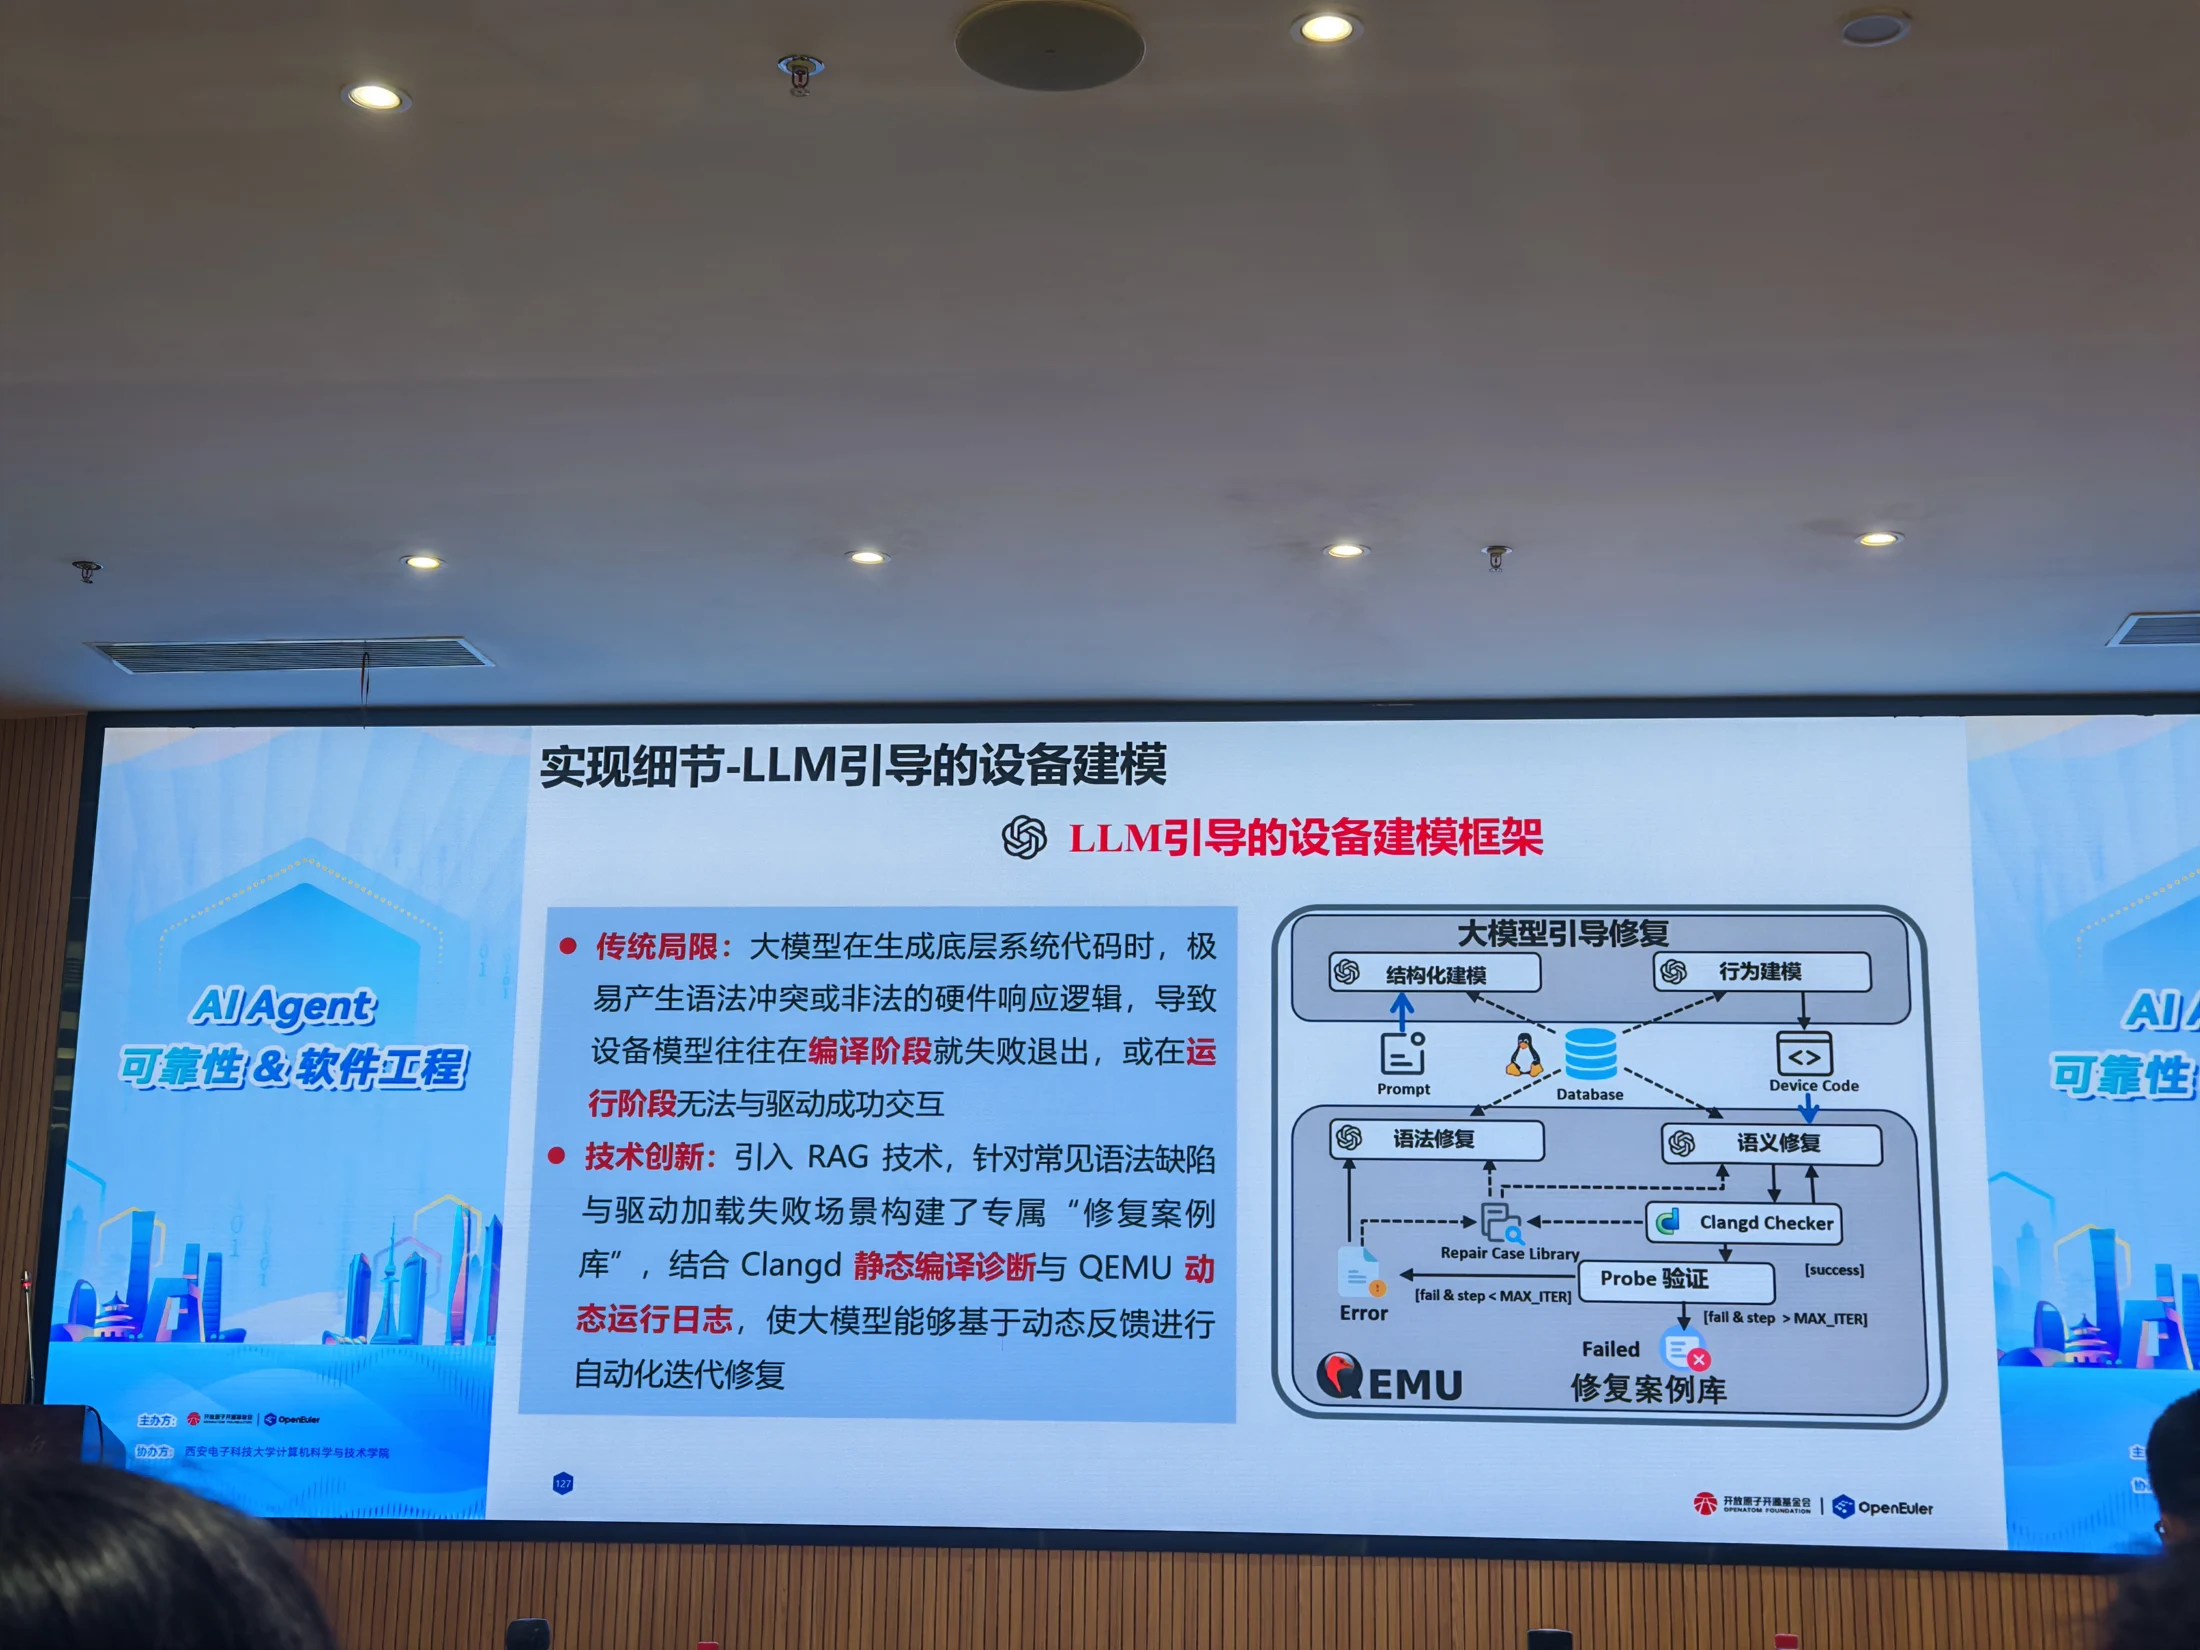
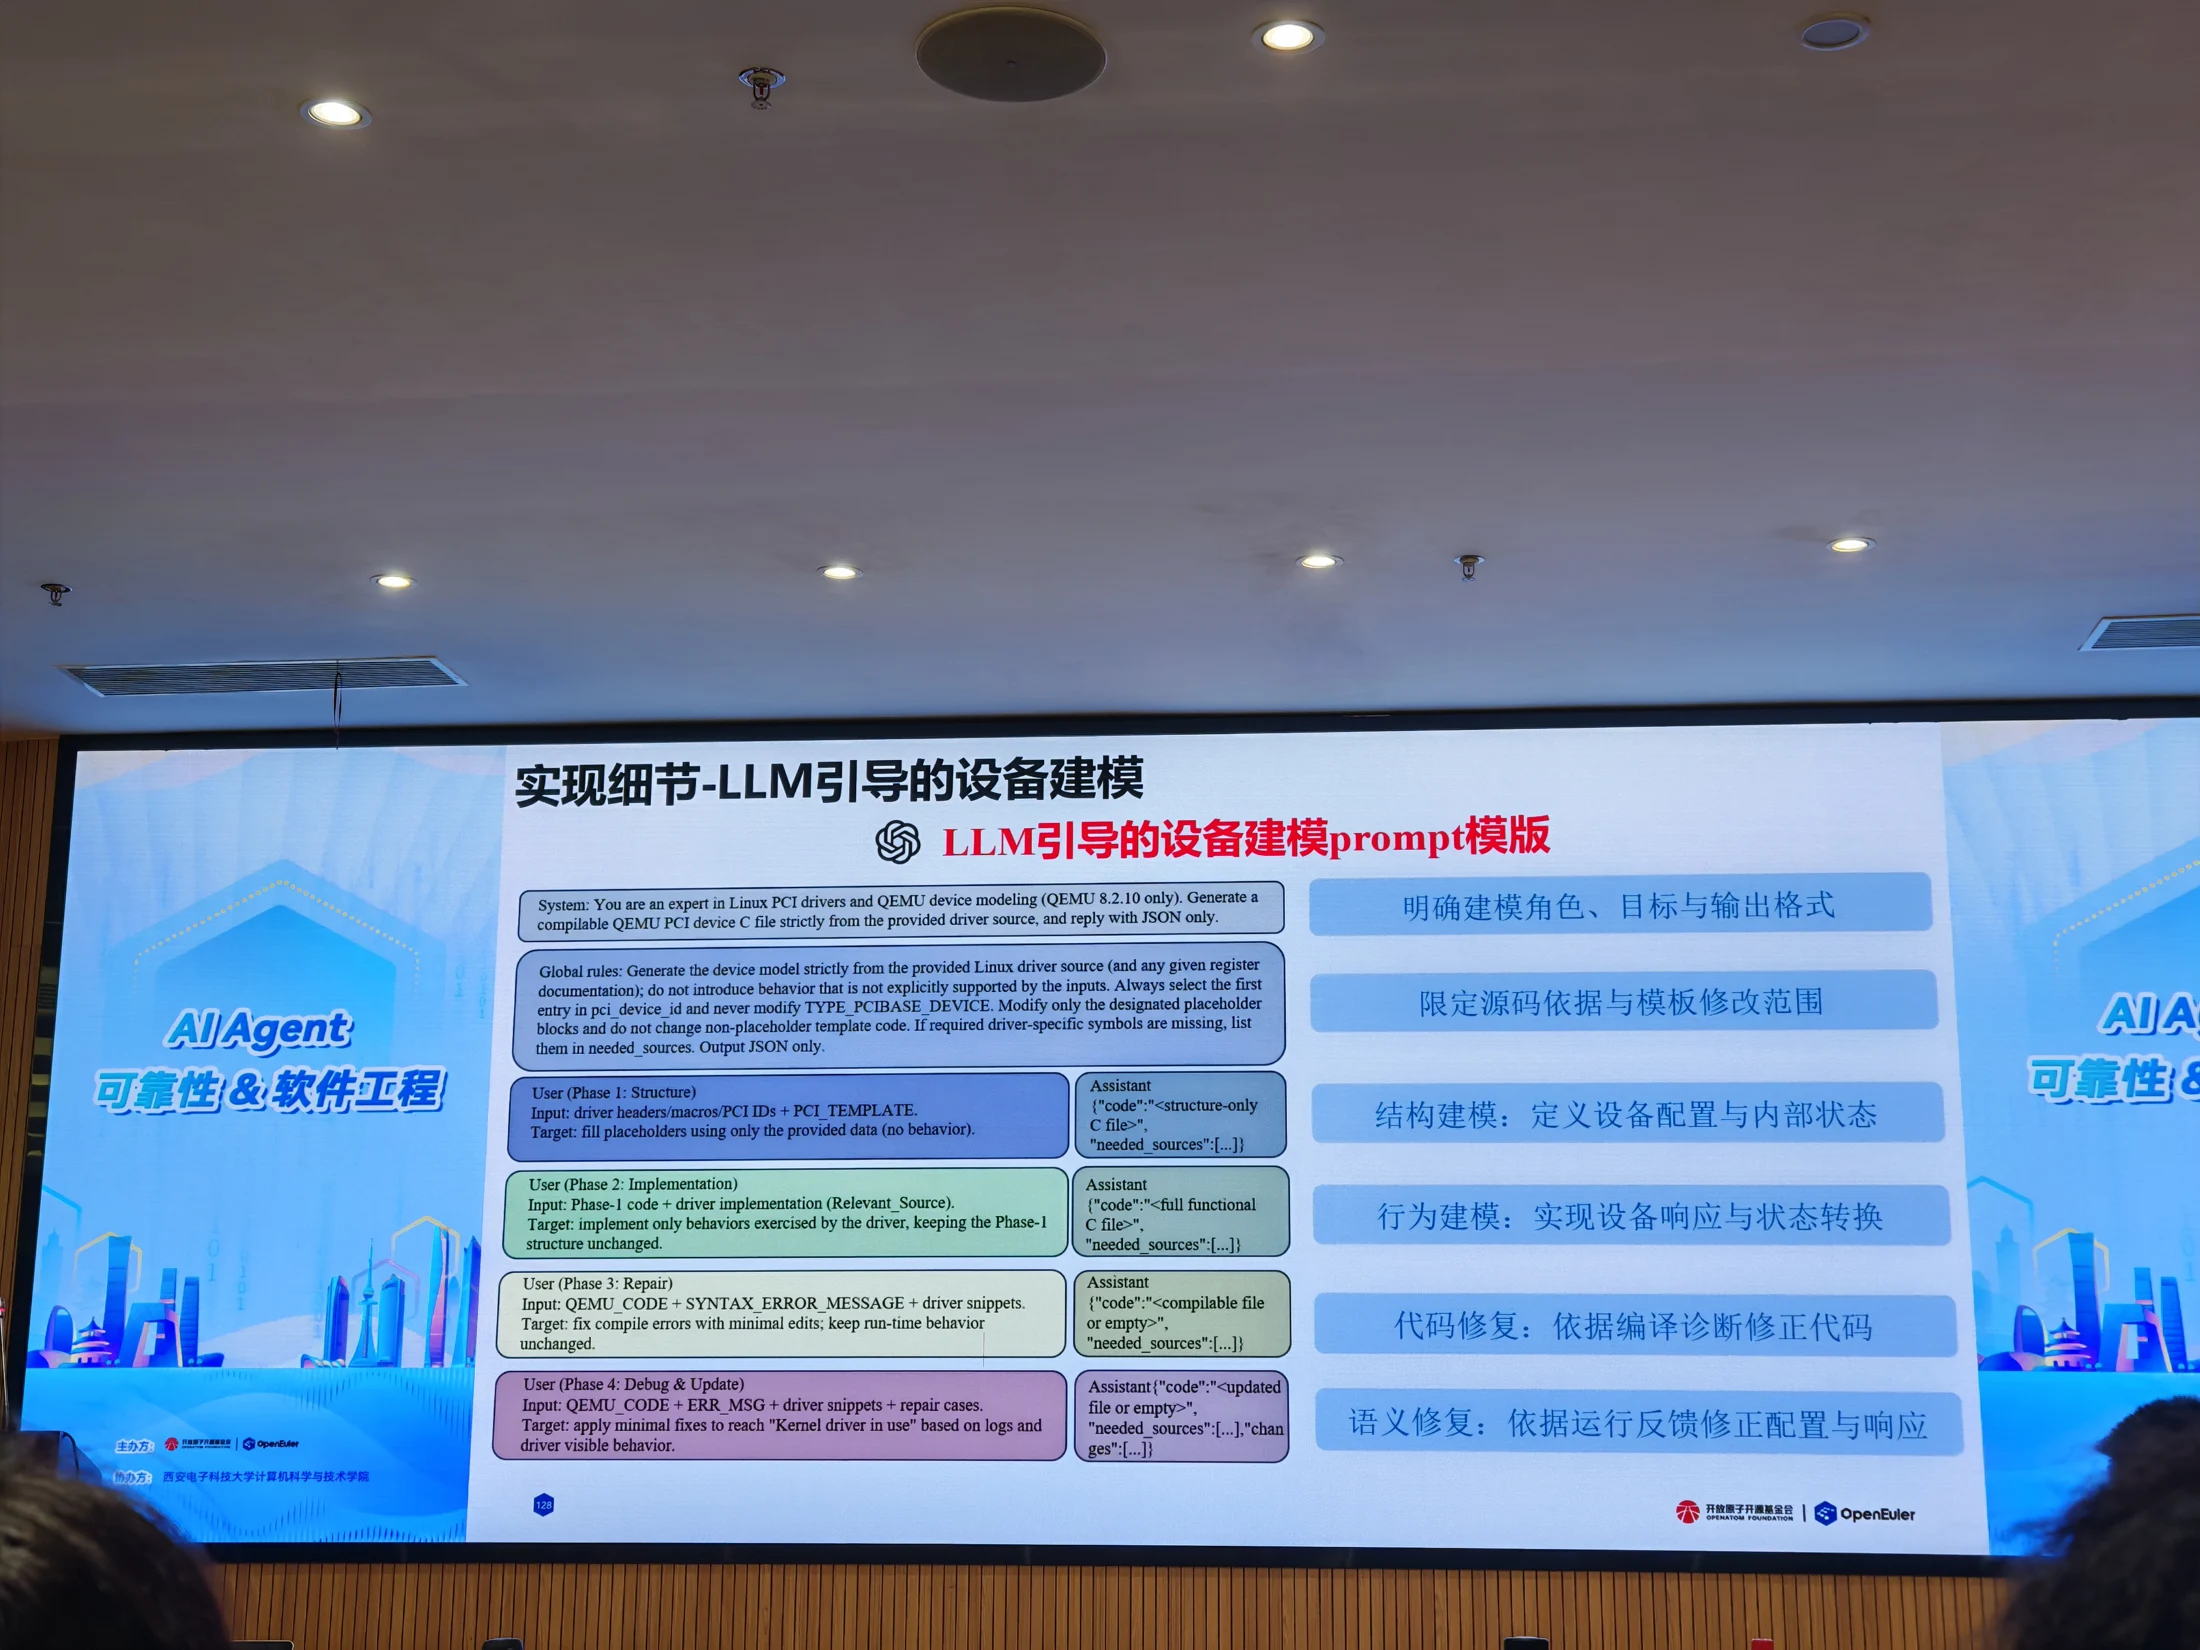
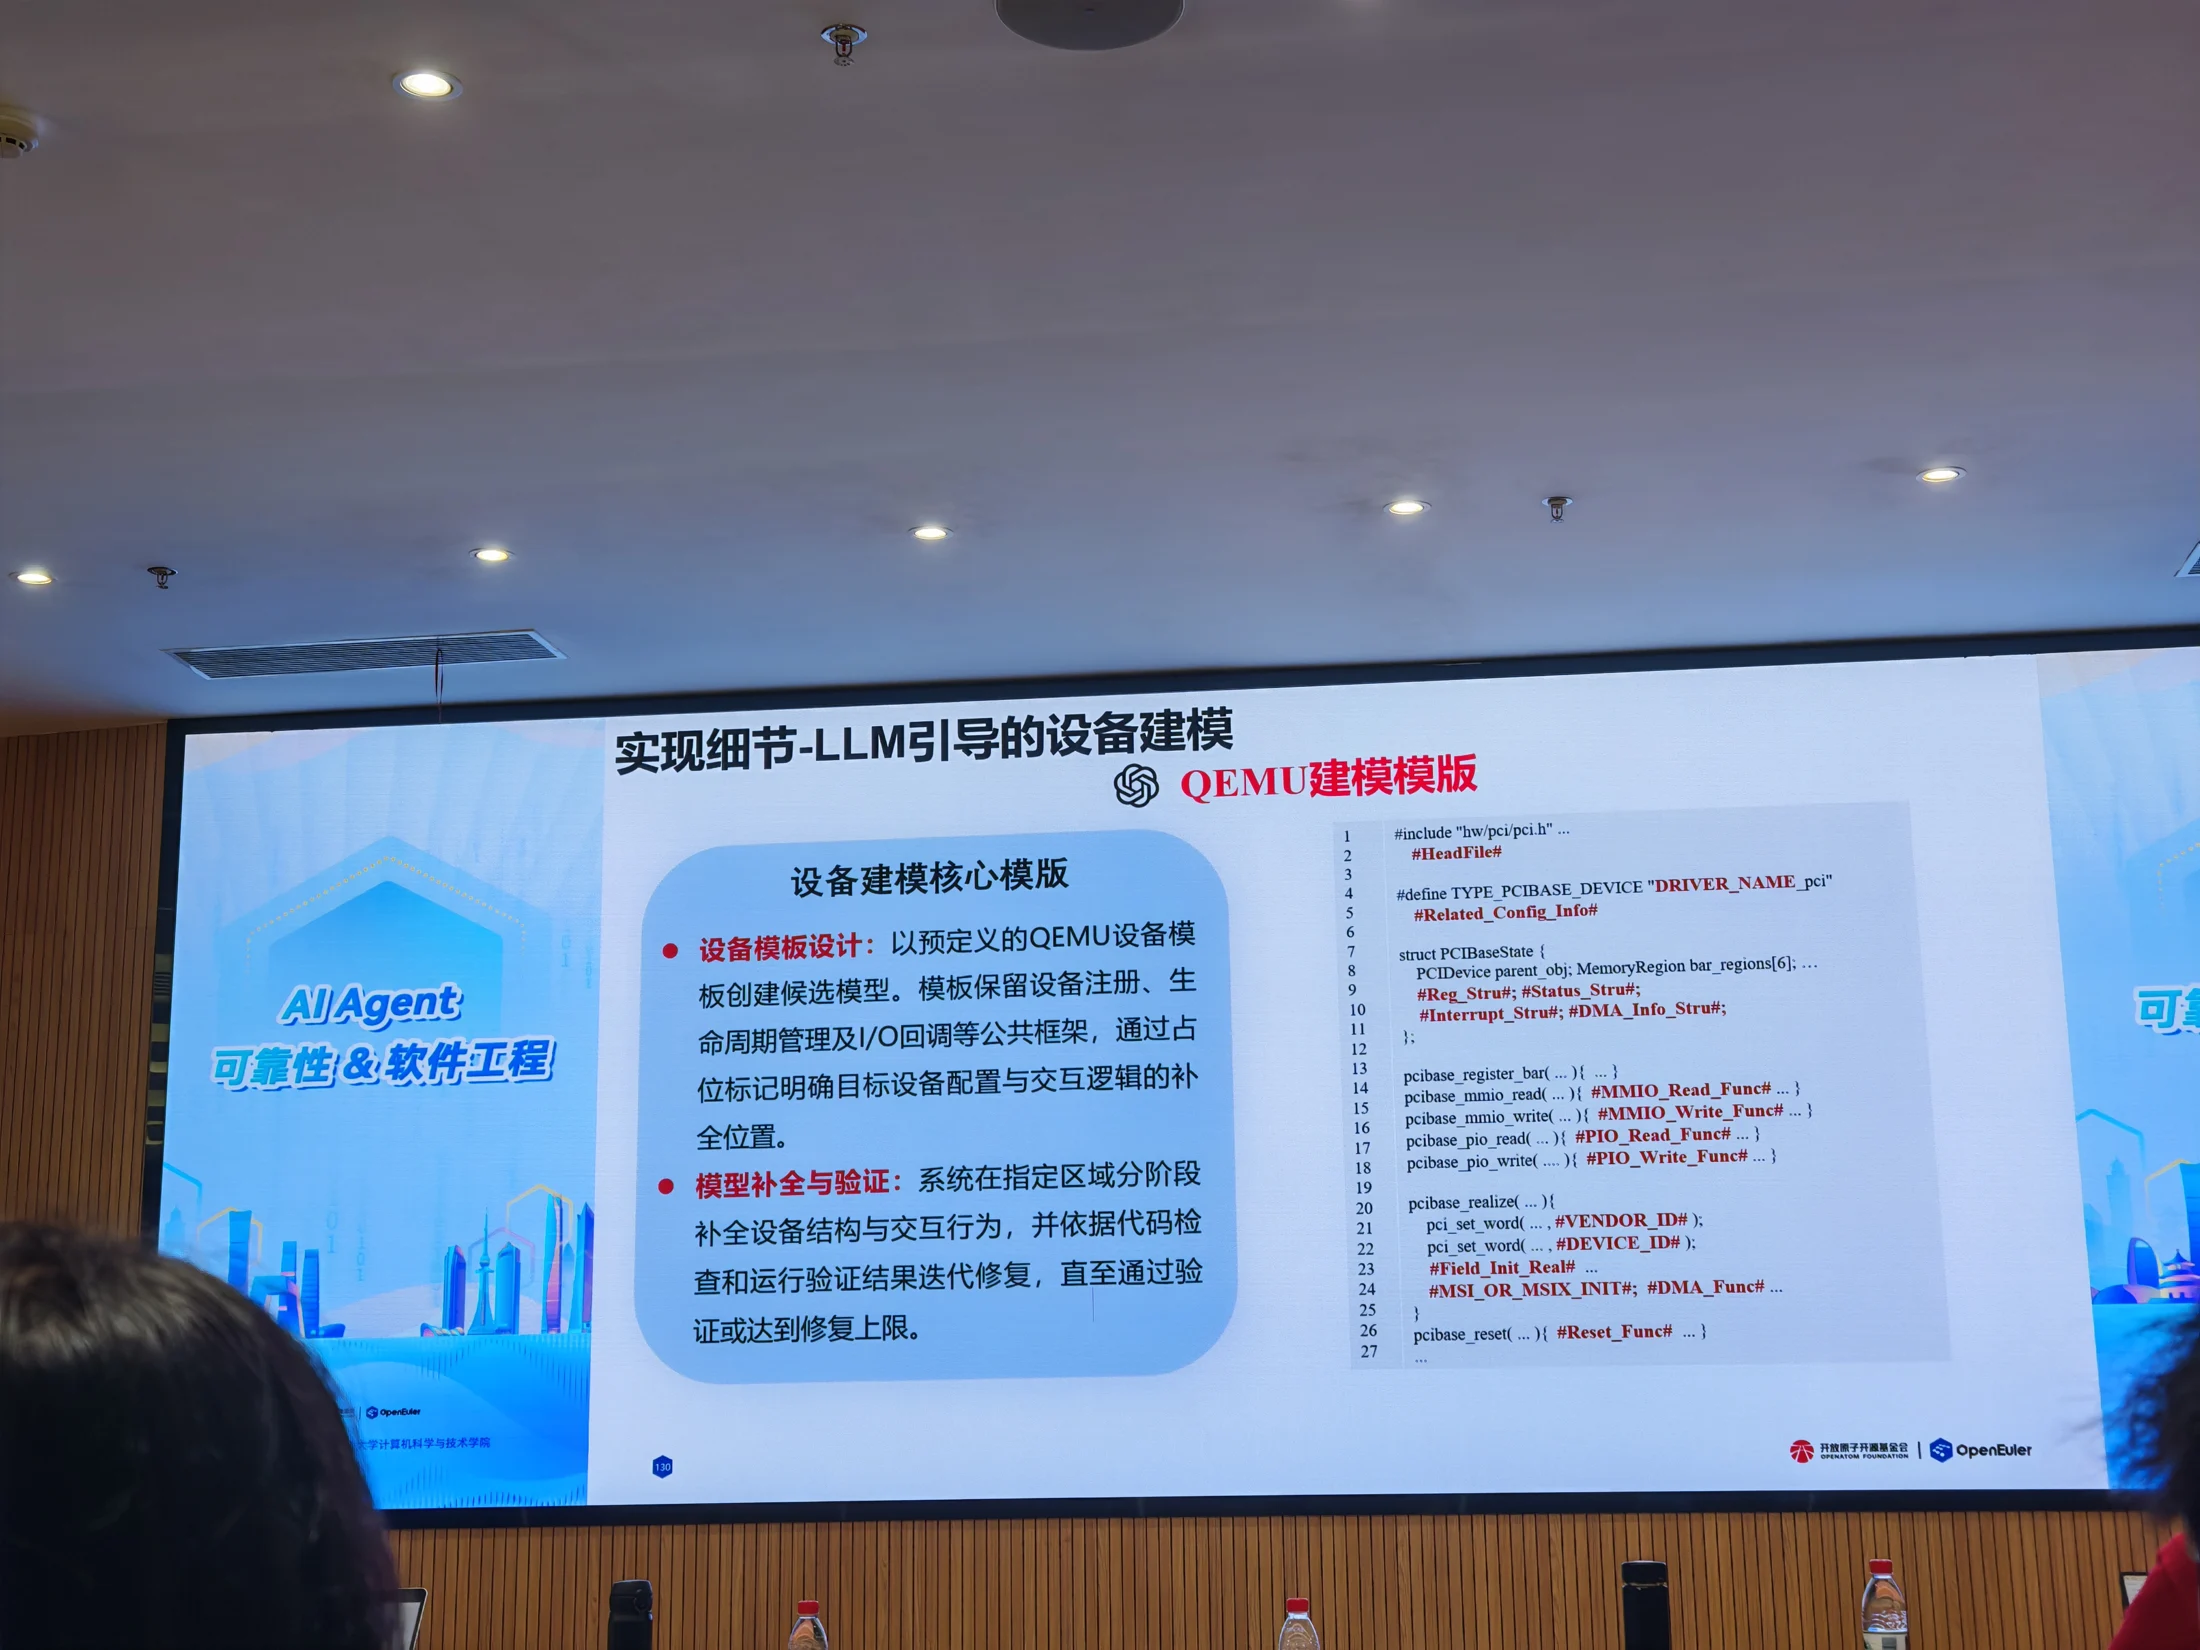
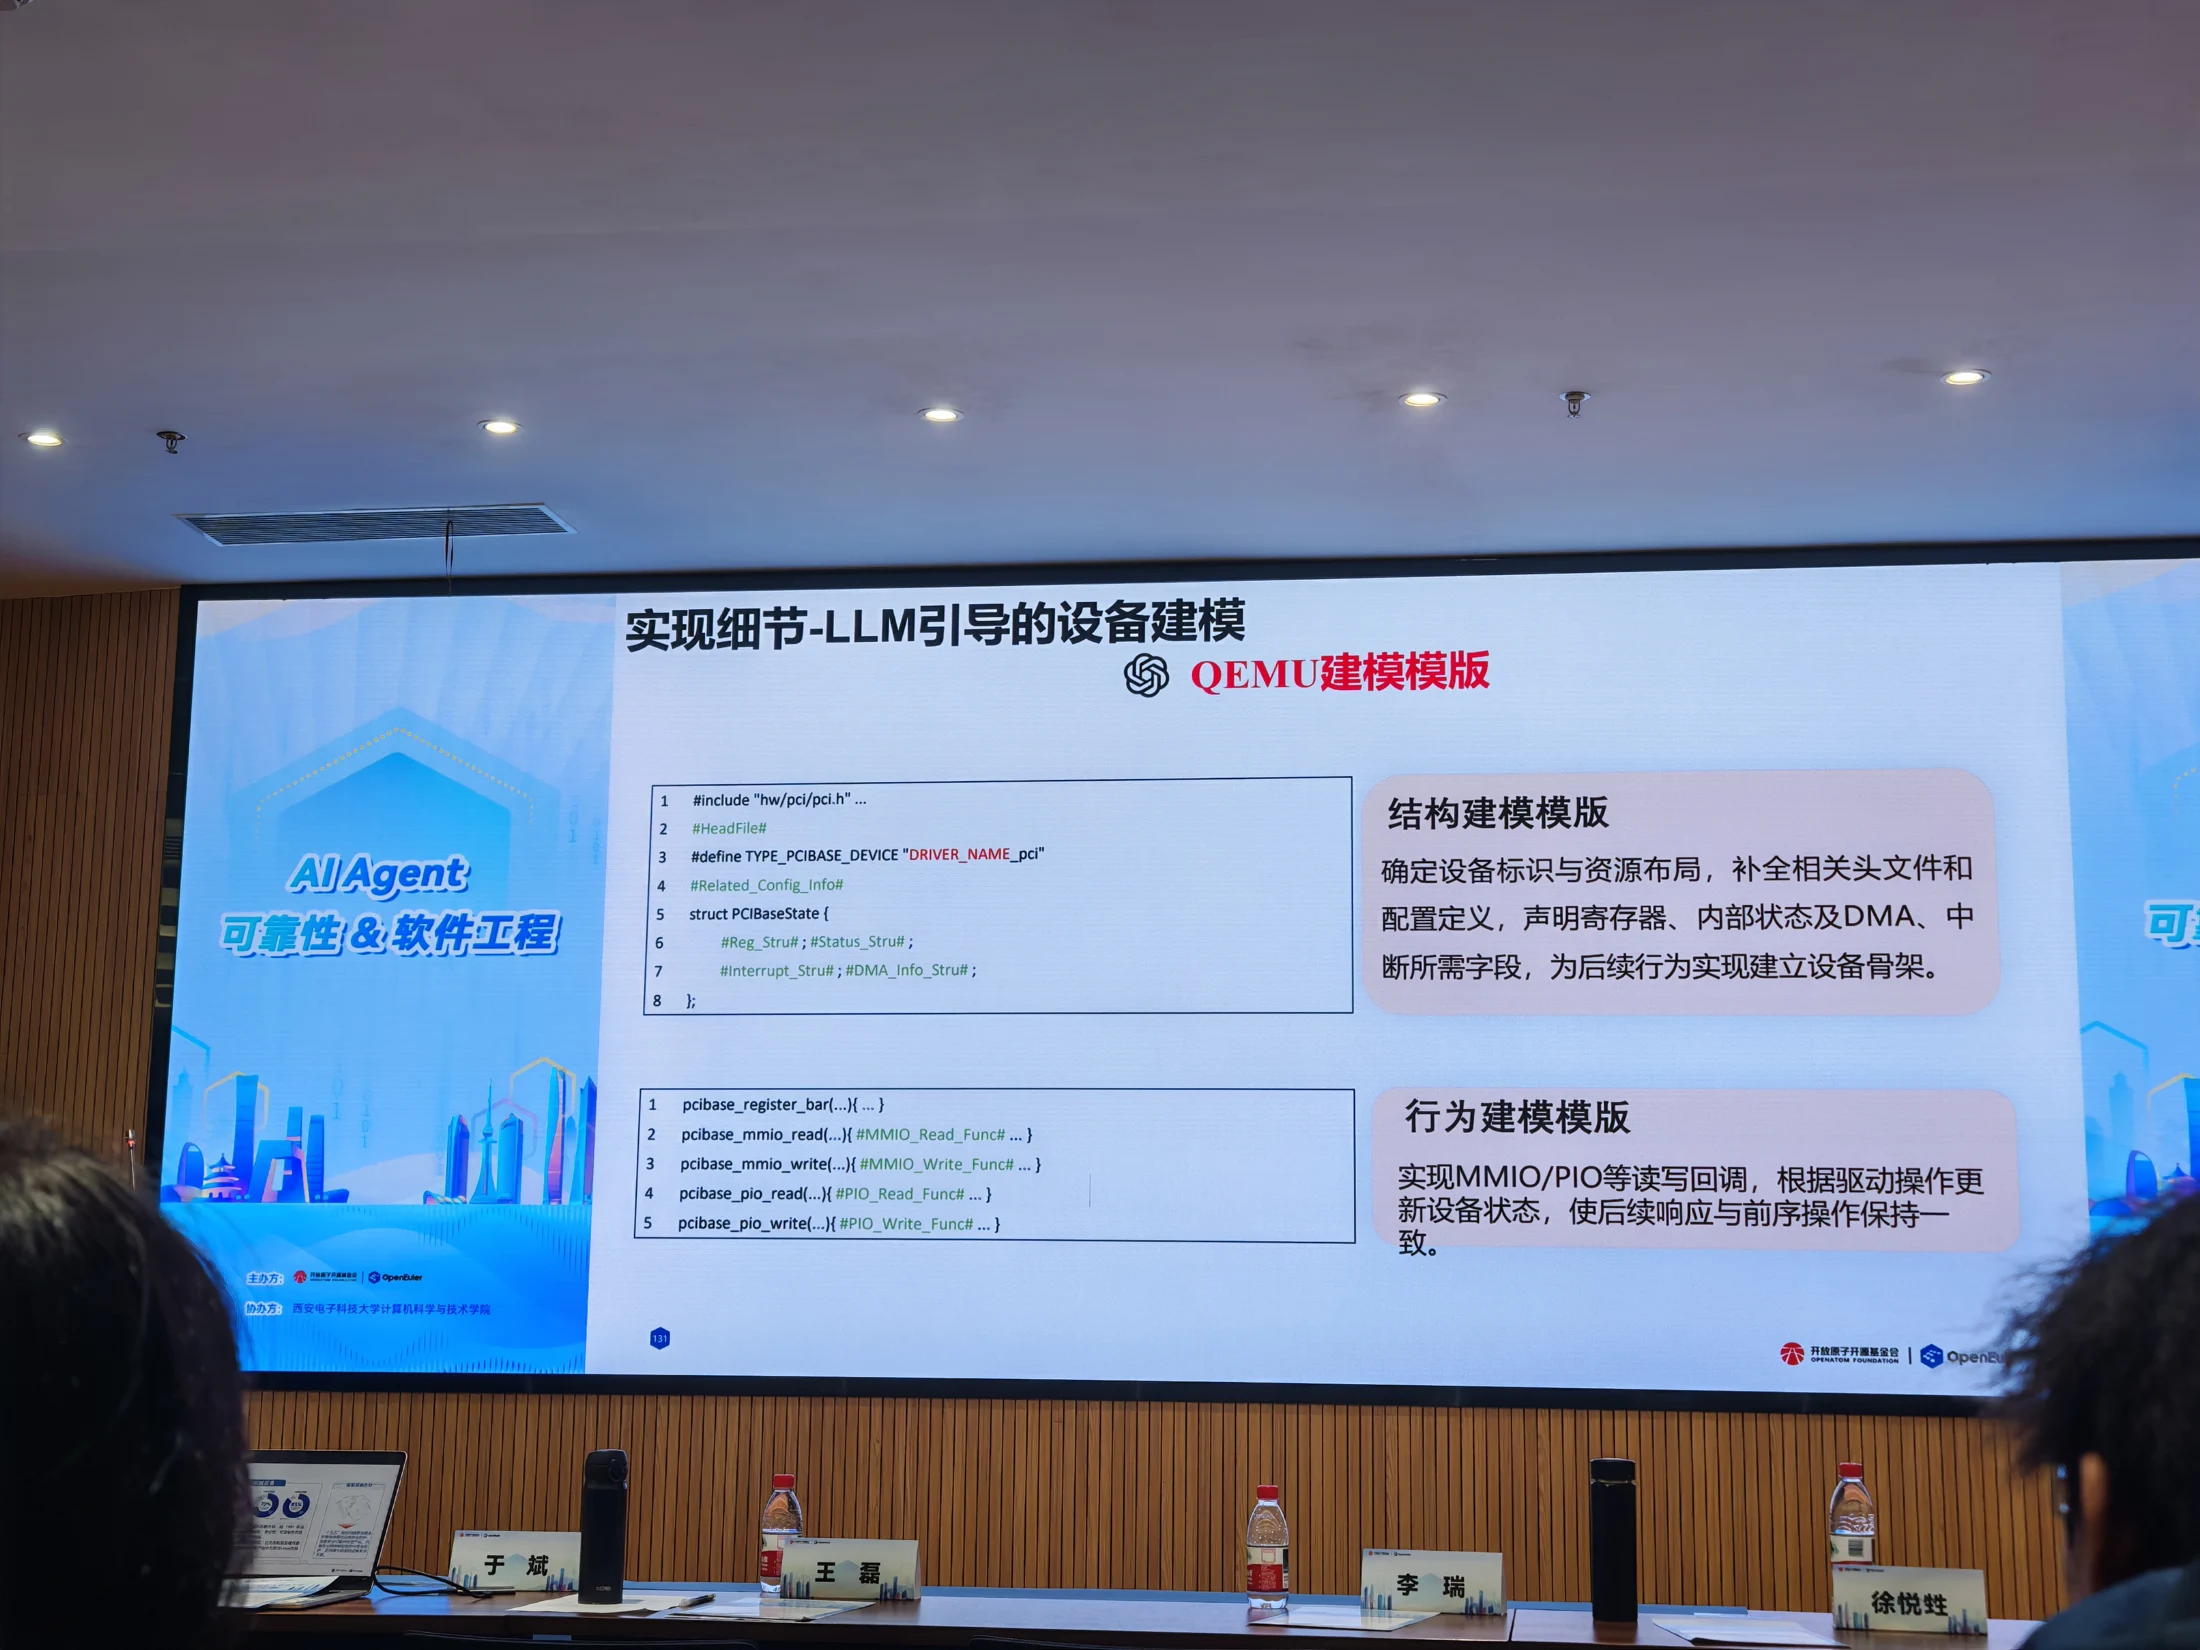
结构模板先定义设备身份、状态和资源;行为模板补全 MMIO、PIO 等交互响应。Clang 编译检查和 QEMU 动态日志分别支持语法与语义修复,RAG 修复案例库供失败场景检索,达到验证条件或修复上限后停止。

查看照片 IMG_20261031_161315.jpg

补全调用描述,接入定向模糊测试

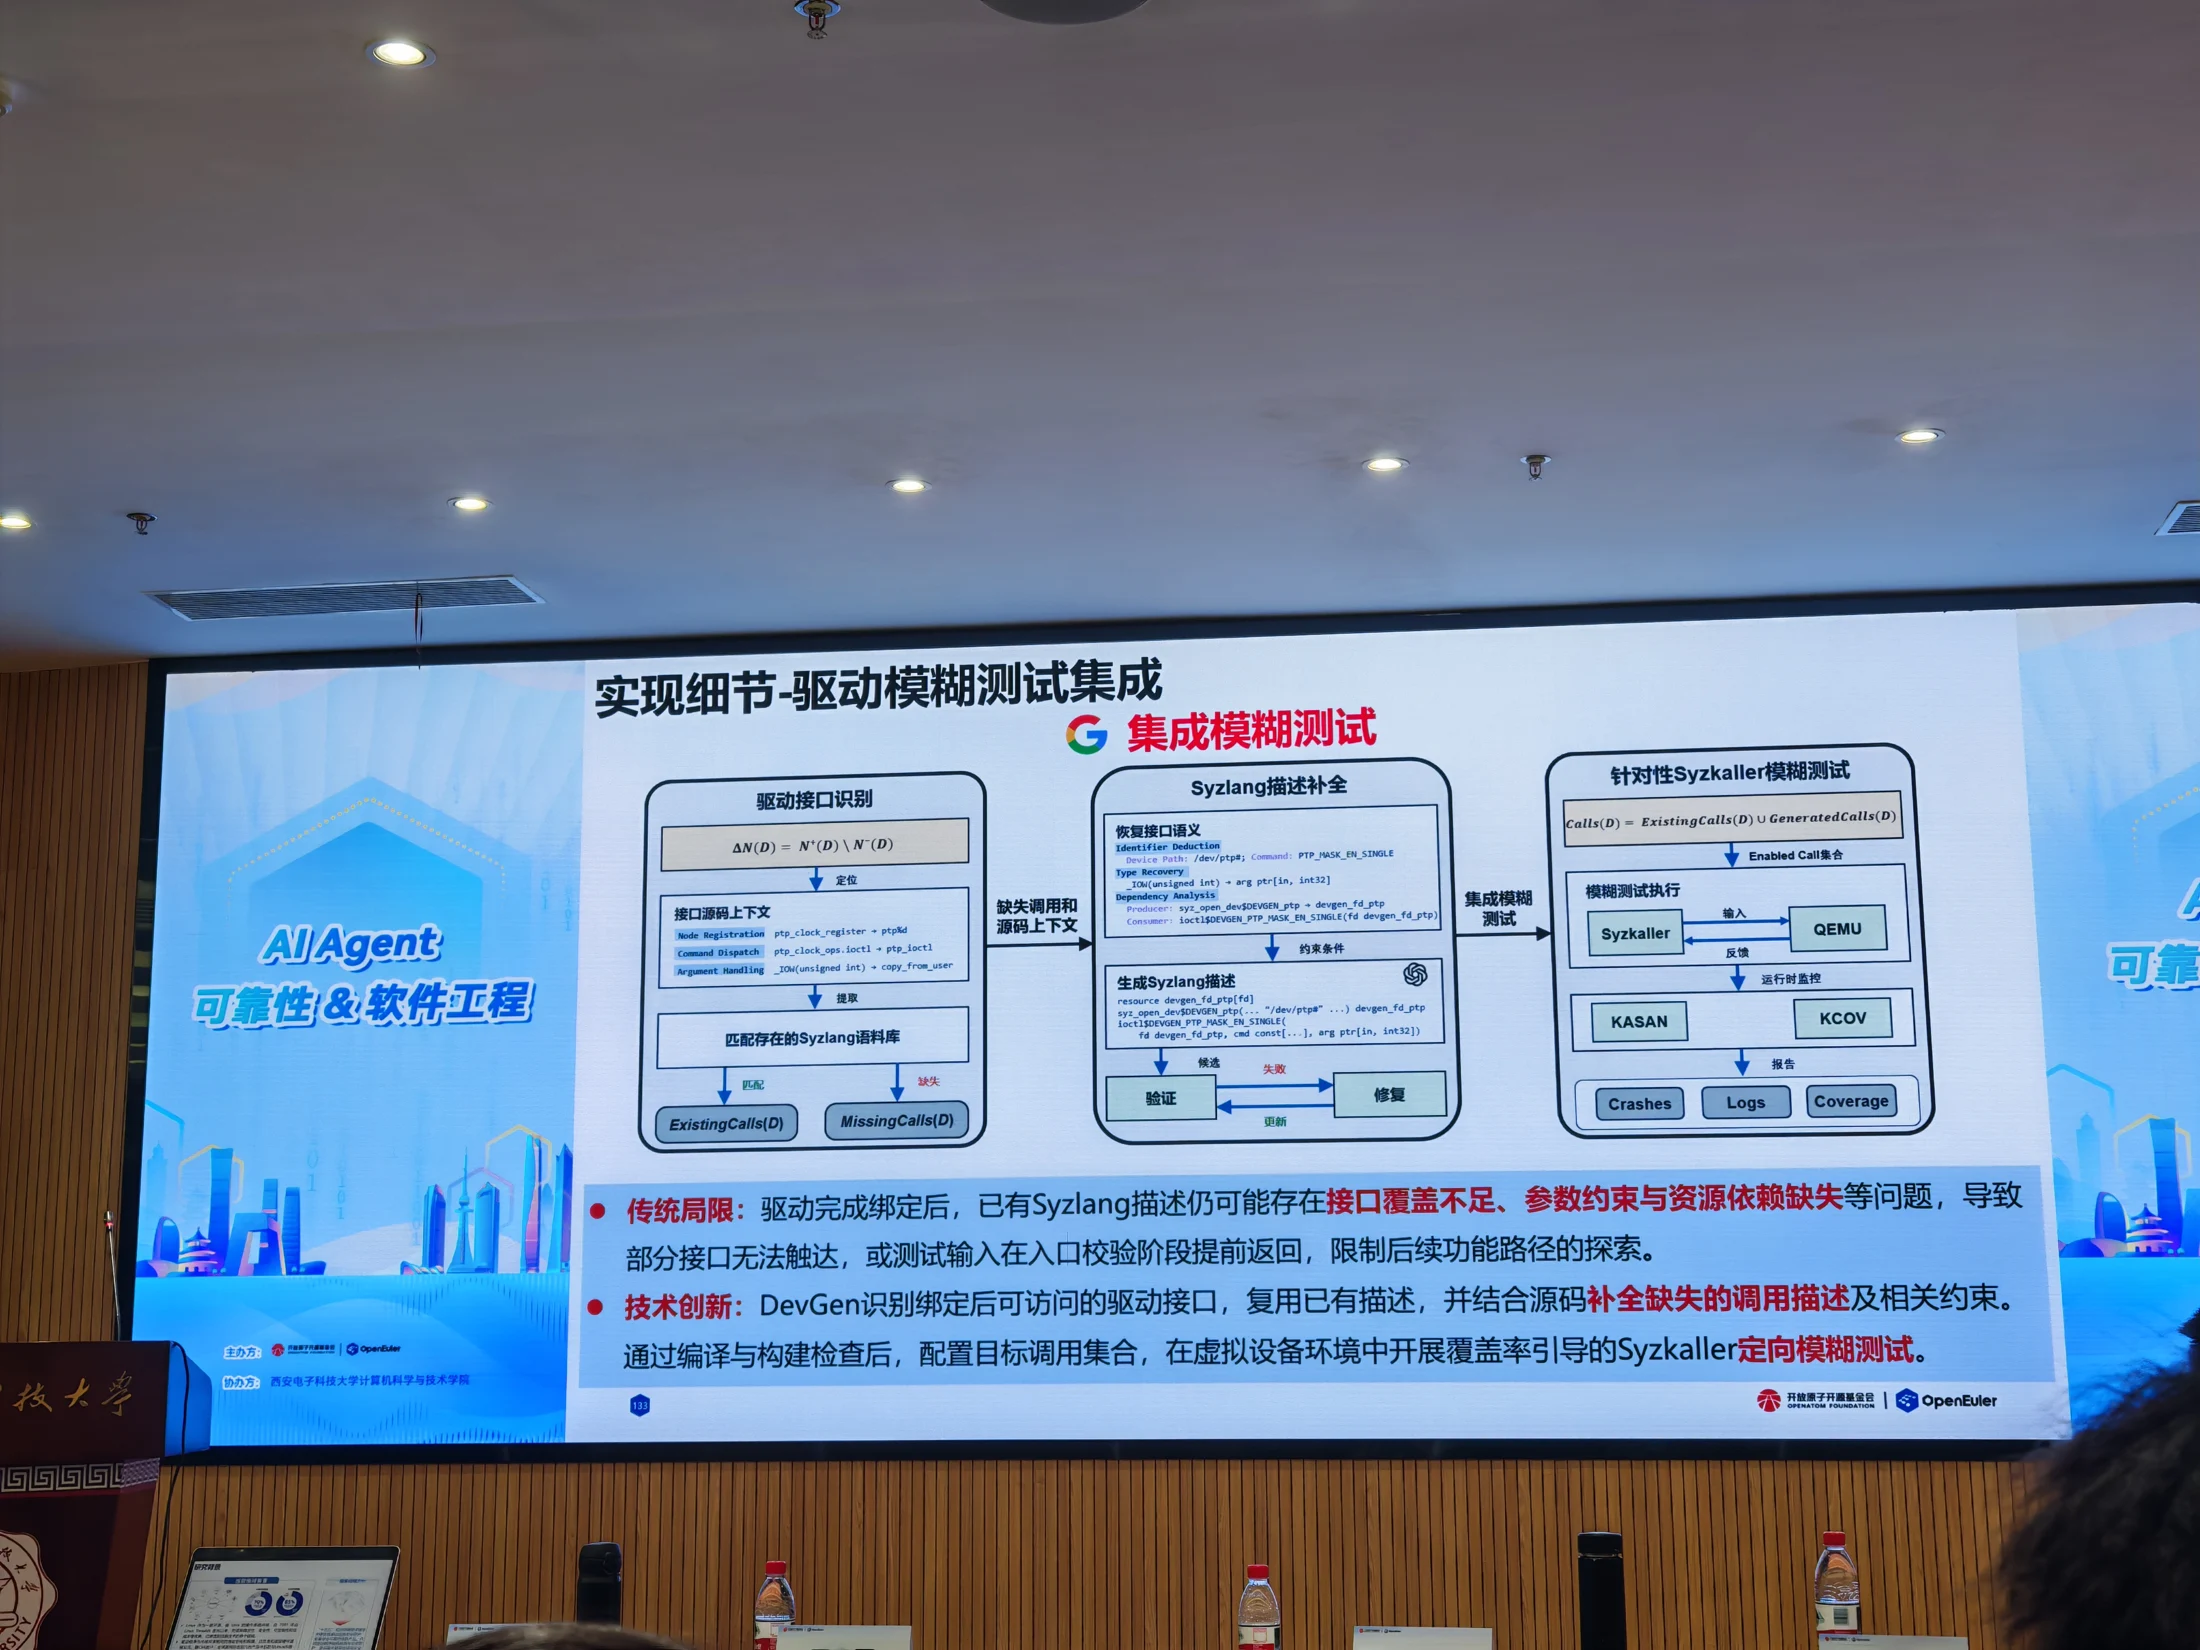
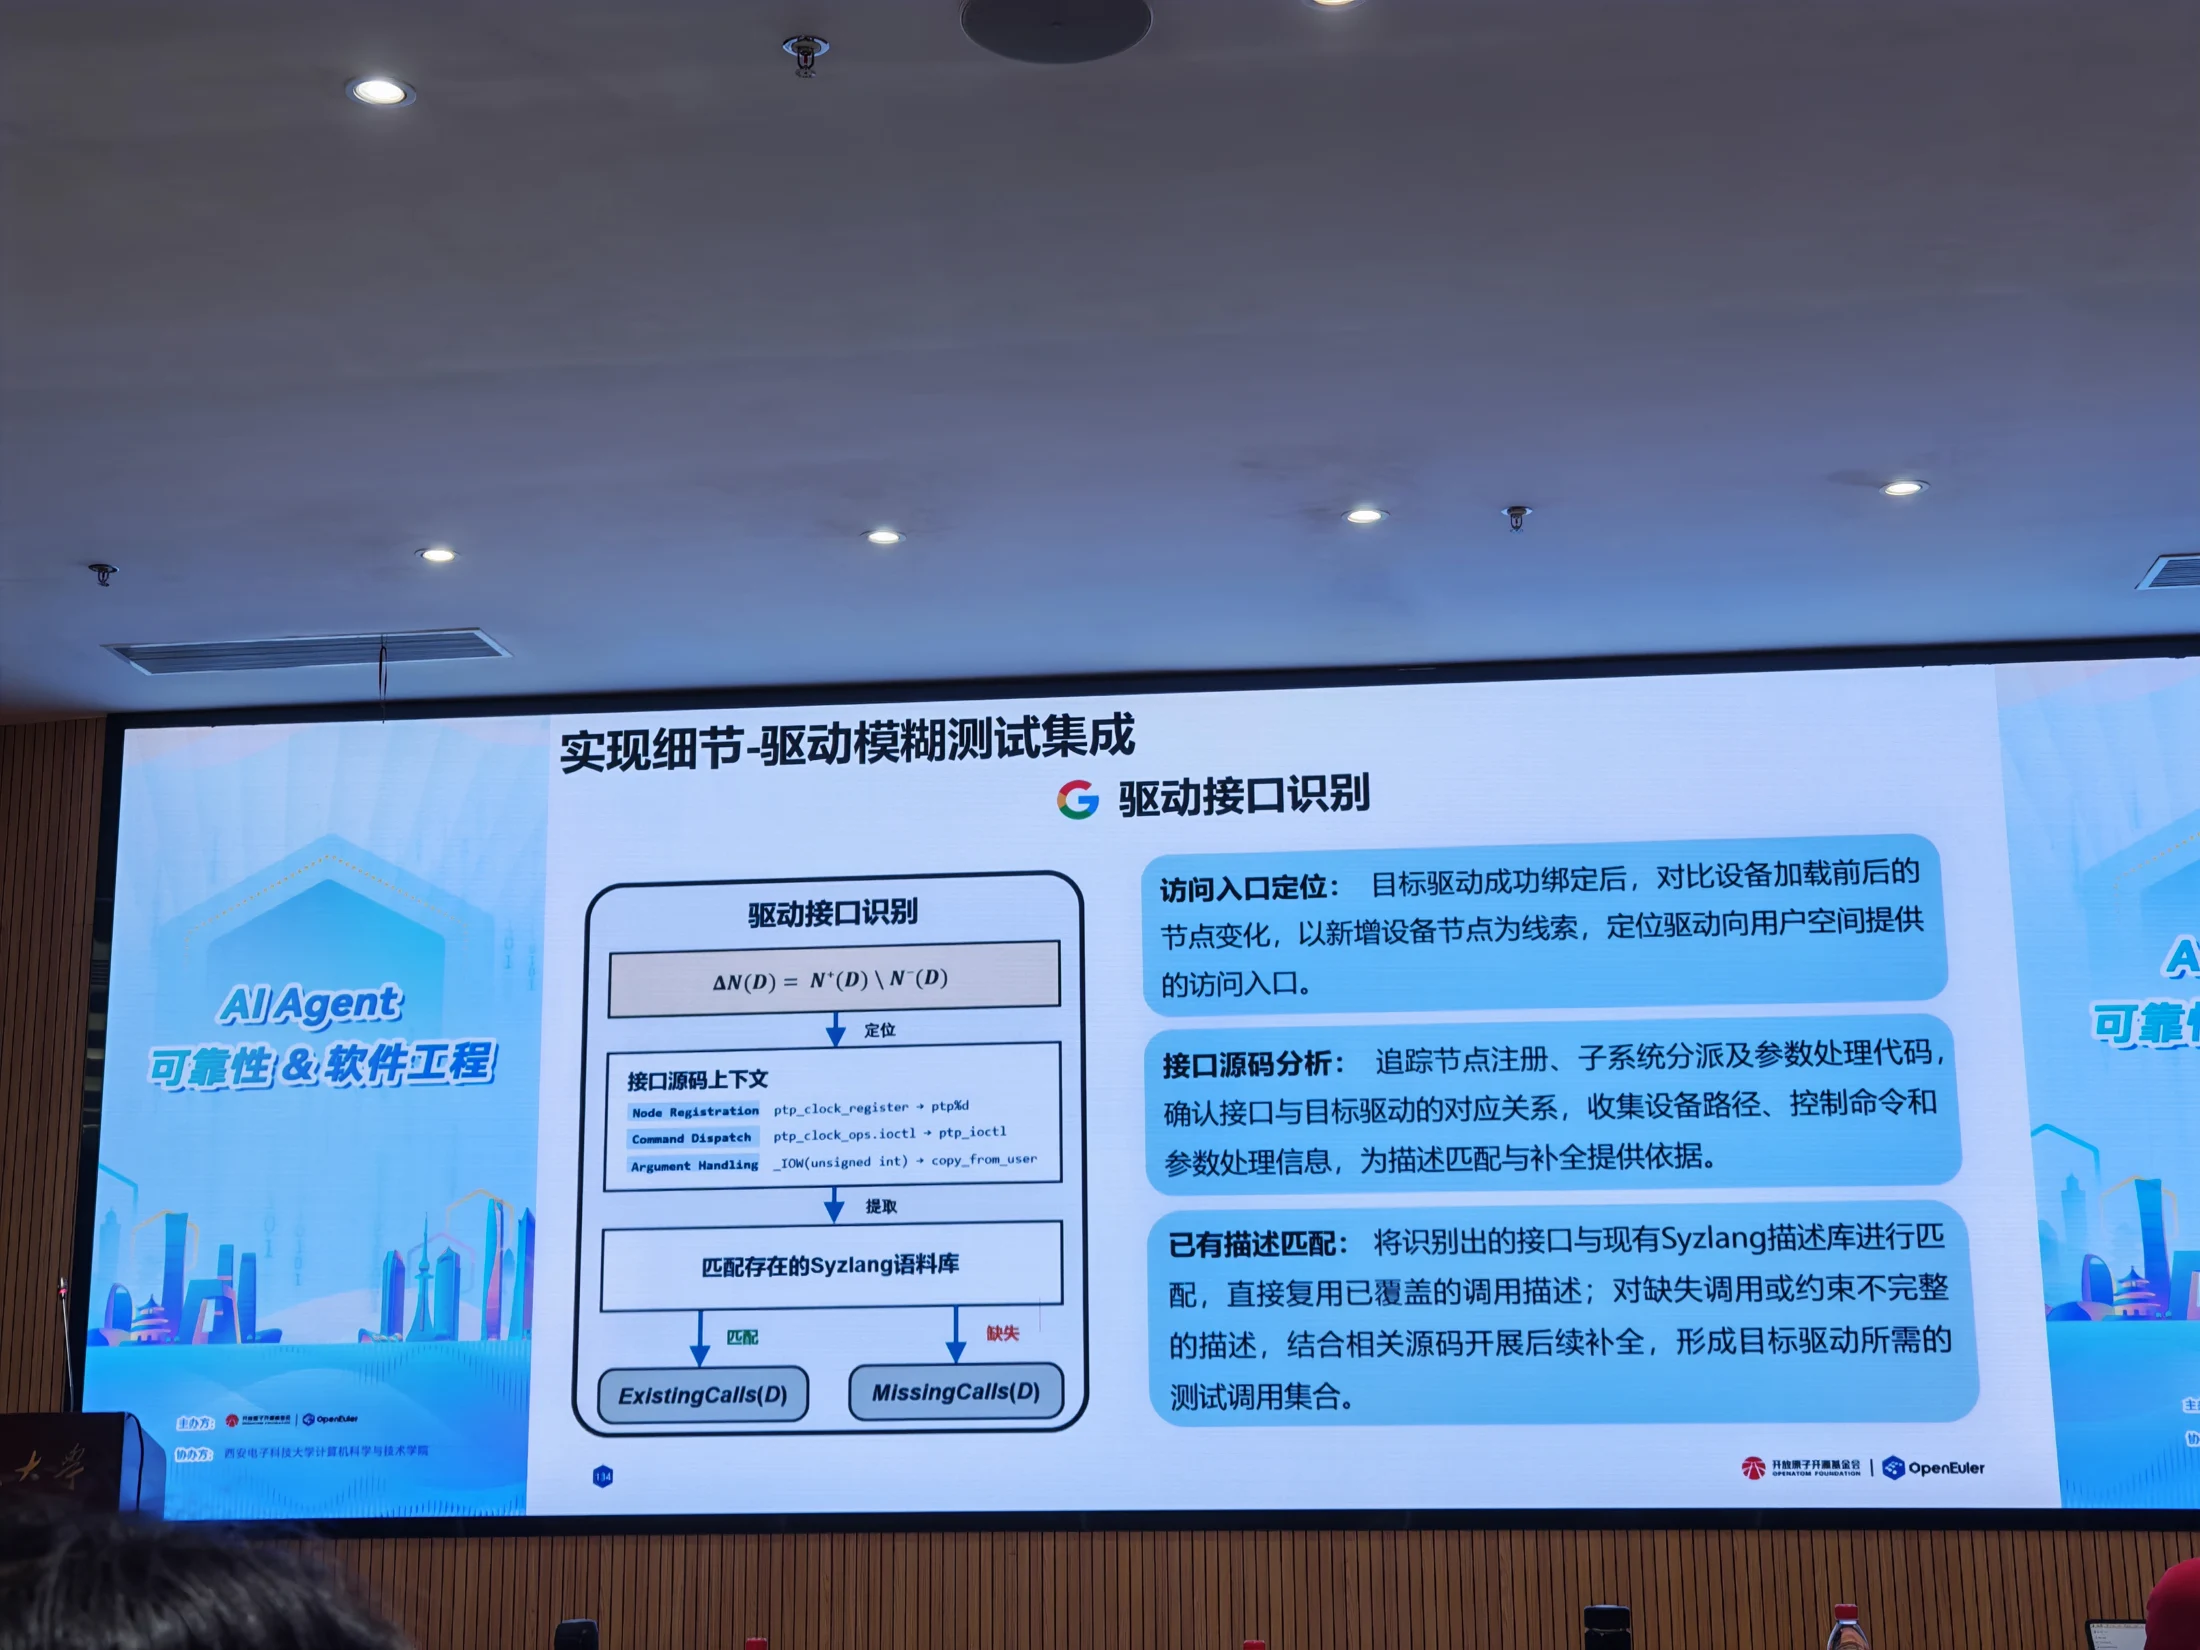
识别绑定后可访问的驱动接口,复用已有 Syzlang 描述,补齐缺失调用和参数约束。用目标调用集合配置 Syzkaller,在虚拟设备环境中运行覆盖率反馈引导的测试。

查看照片 IMG_20261031_161821.jpg

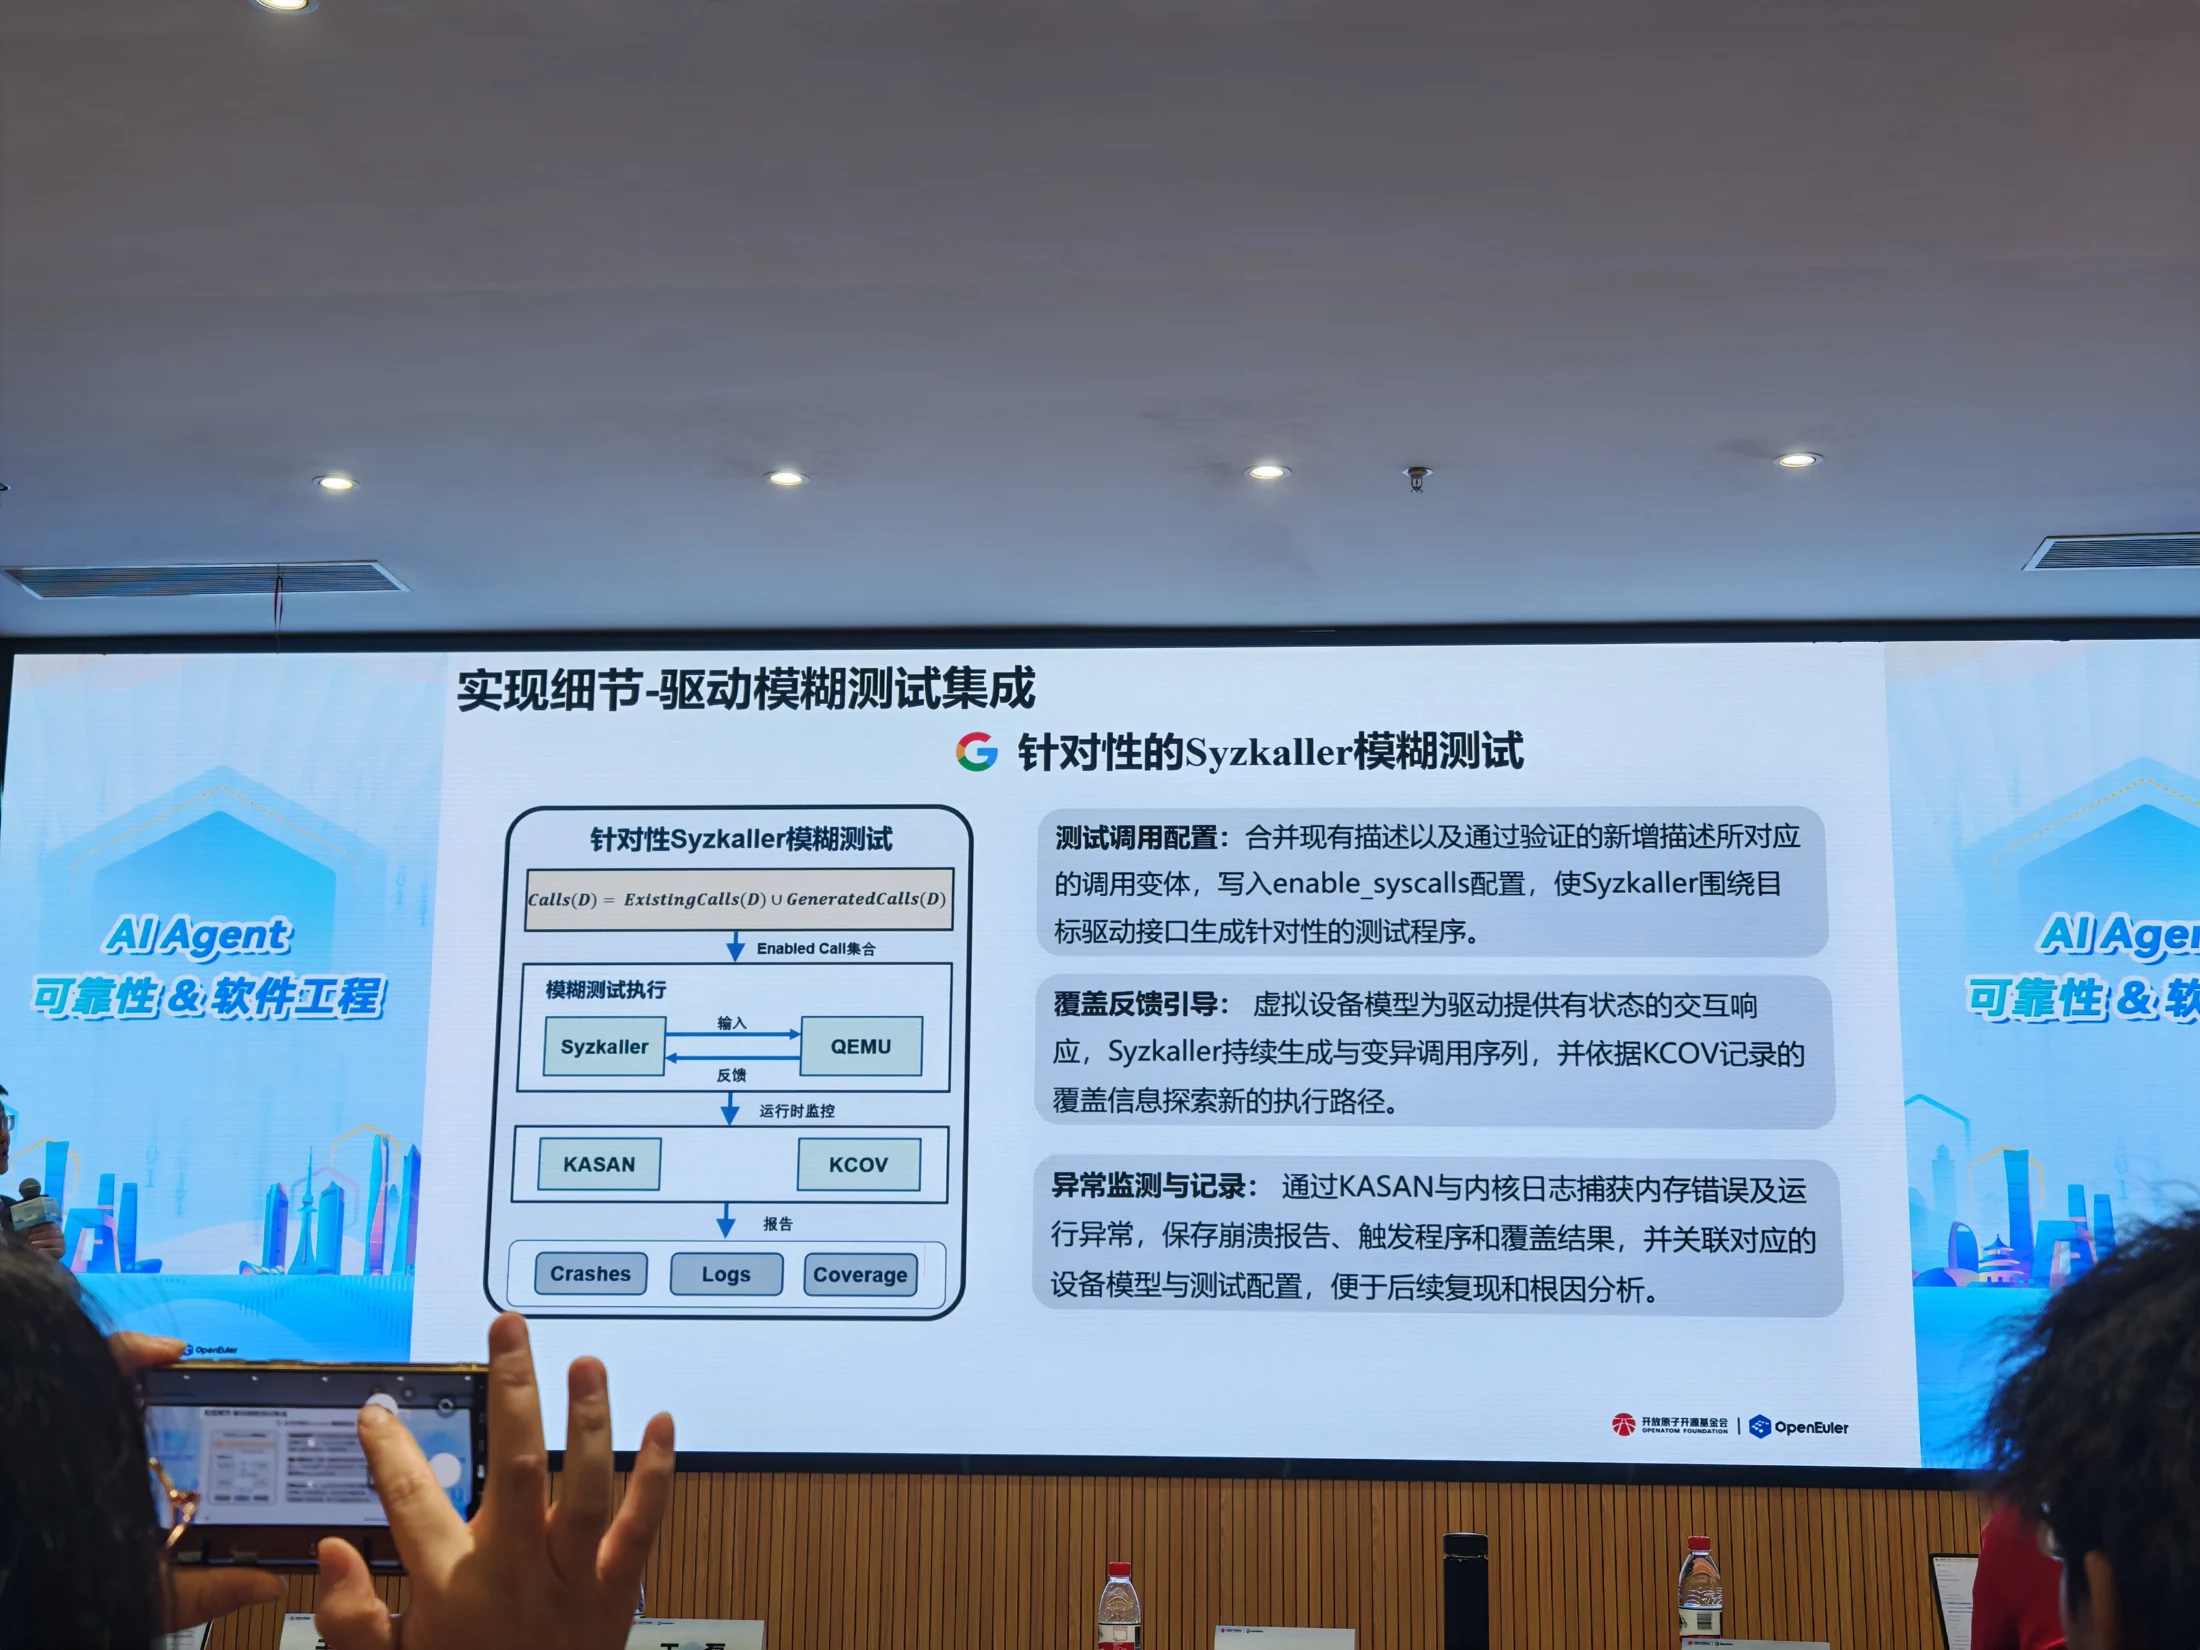
覆盖和崩溃形成后续证据

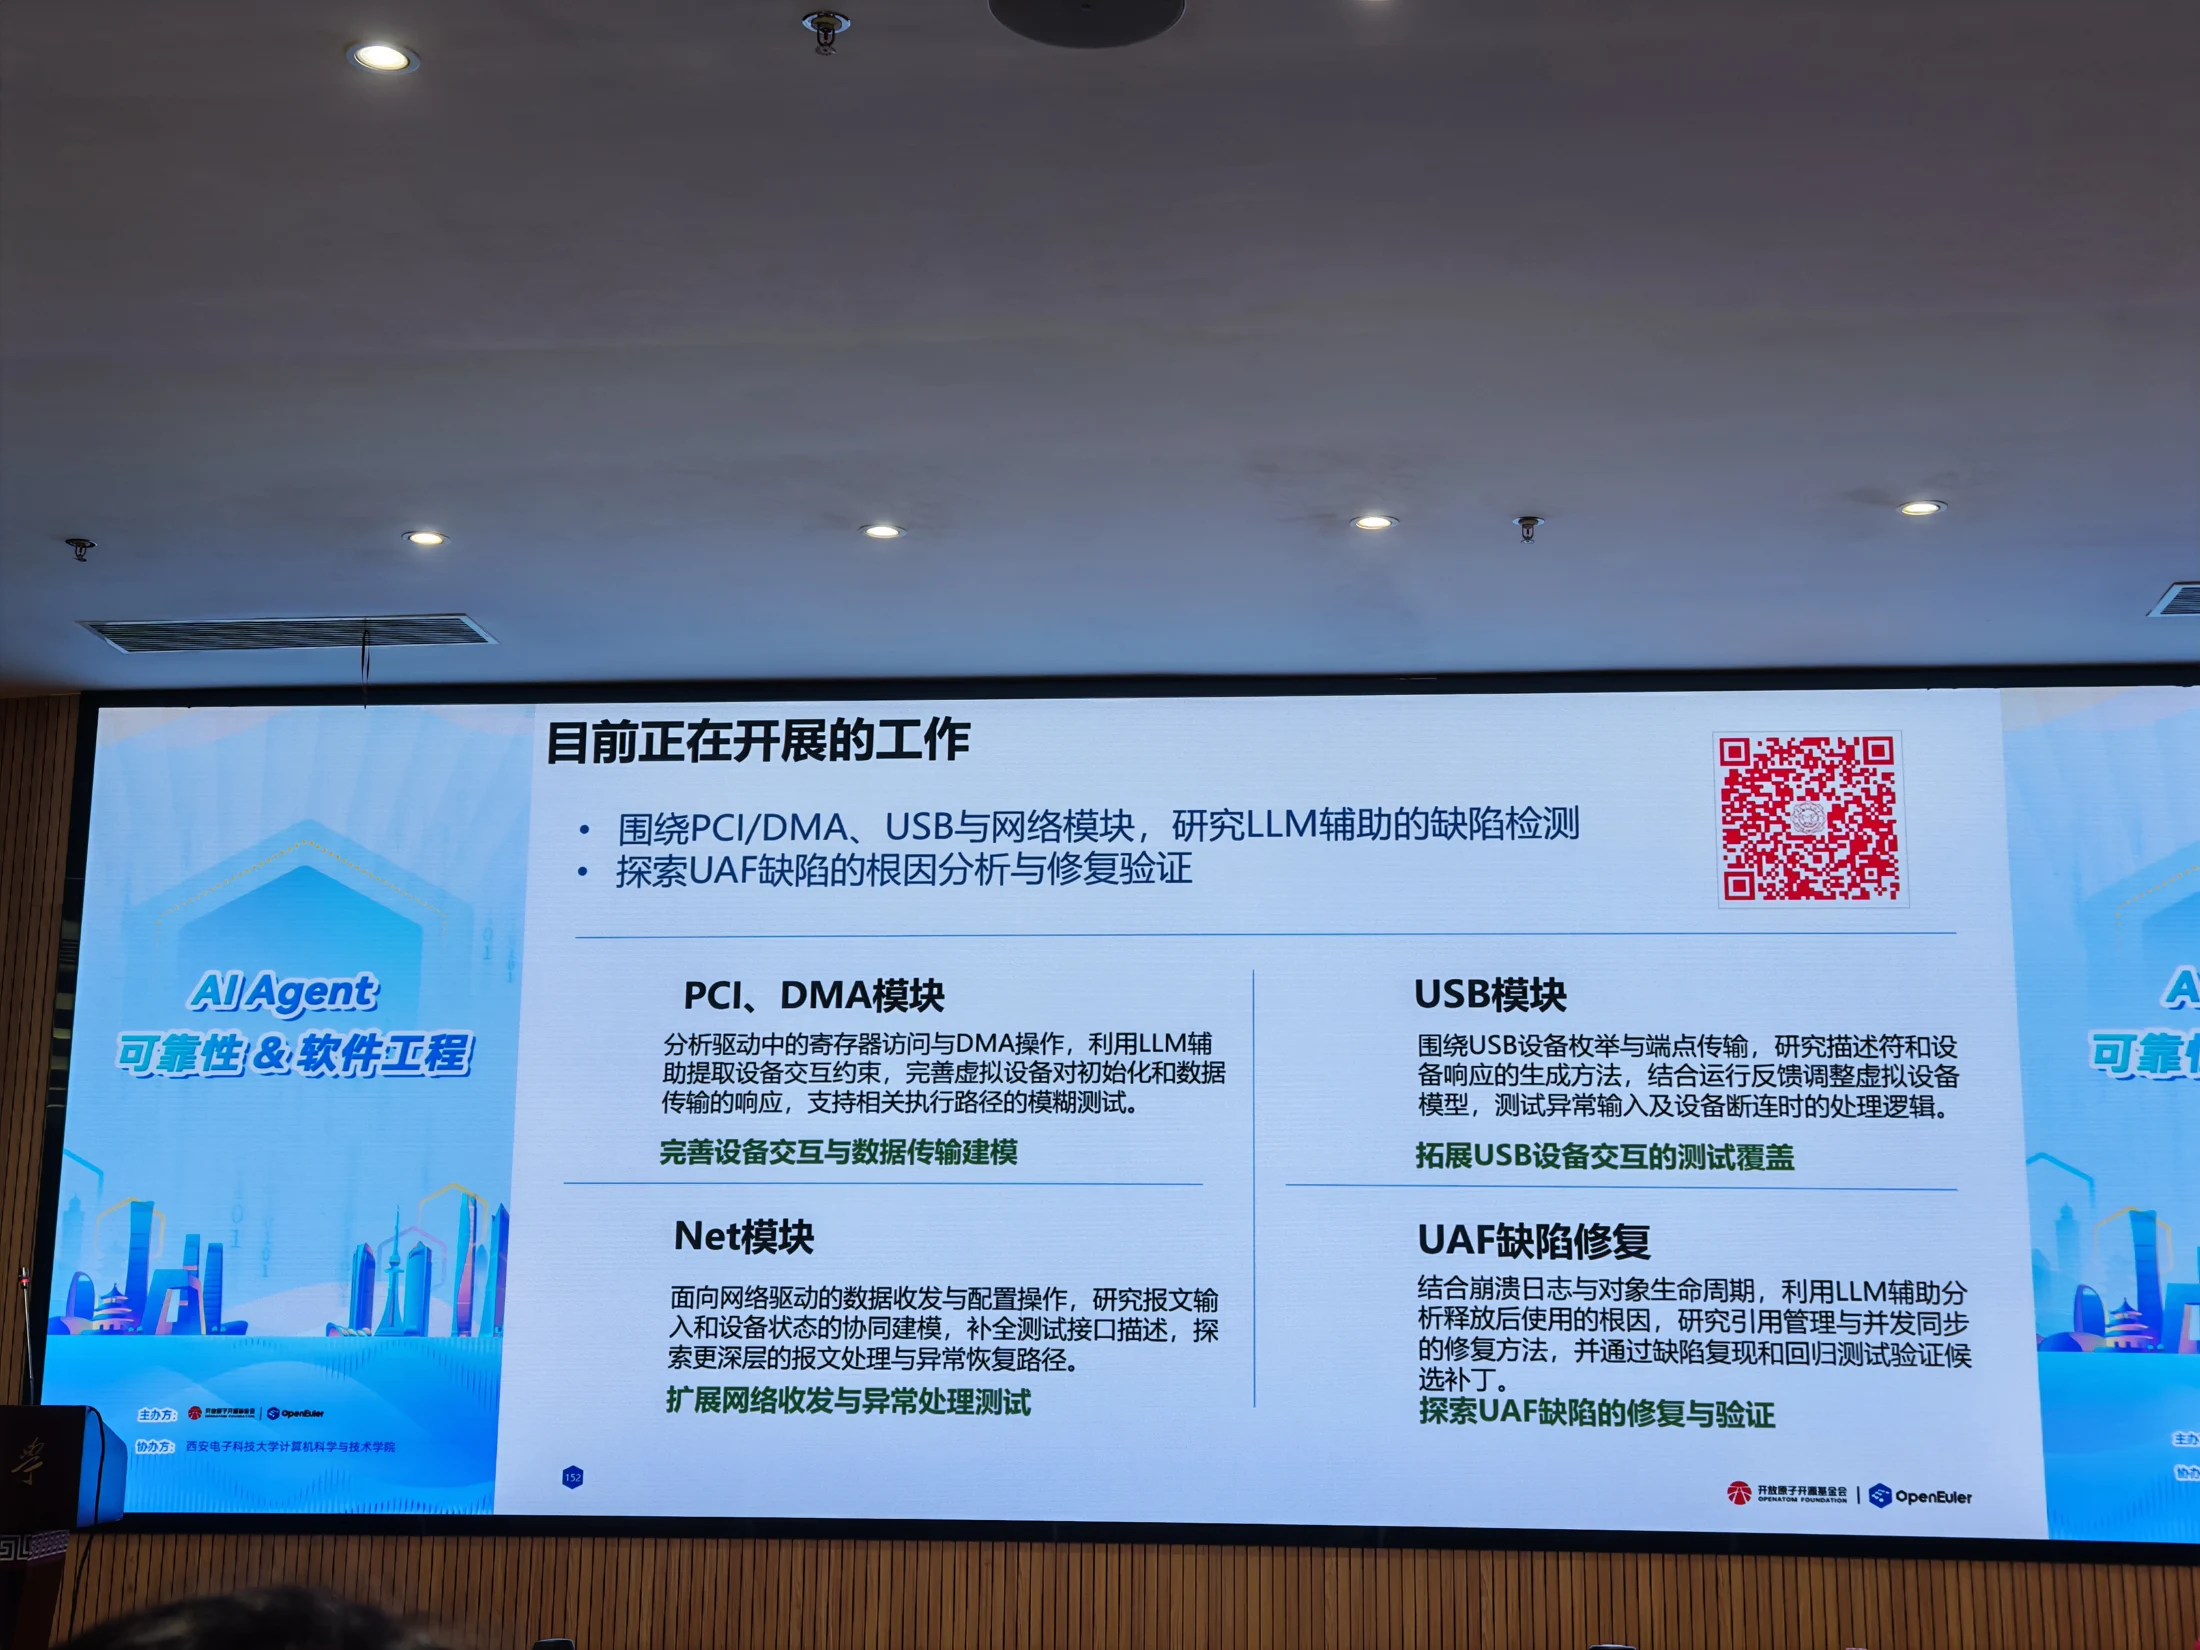
KCOV 记录覆盖信息,KASAN 和内核日志用于捕获内存错误与异常;保存崩溃报告、触发程序、模型与配置,支持复现和根因分析。PCI/DMA、USB、网络及 UAF 修复验证在照片中列为正在开展的工作。

查看照片 IMG_20261031_162614.jpg

我感受到的是软件测试需要环境建模能力。模型能生成源码,并不意味着理解了硬件行为;编译成功、probe 成功、深层路径覆盖是不同层次的证据。

如果将来做系统软件方向,我需要补齐 C、Linux 内核、设备协议与调试基础。LLM 可以帮助读代码和生成模型,但我仍要解释状态变化、内存交互与异常条件。

虚拟设备通过测试只能说明当前模型和输入下没有观察到问题,不能直接推导真实设备上的正确性。对模型真实性的评估也需要独立检查。

我验证的是模型能编译,还是驱动确实走到了目标路径?

  1. 先跑通最小环境

    在隔离虚拟机里学习 QEMU 和一个简单虚拟设备,解释初始化、寄存器读写和中断的路径。

  2. 做一个受控的小模型

    选择已有文档的简单设备,先手工列状态与响应表,再让 LLM 辅助实现,逐项对照而非直接接受生成结果。

  3. 保留可复现测试证据

    固定内核、QEMU 与工具版本,保存 seed、配置、覆盖和最小触发程序;在授权隔离环境开展测试。

展开这场的 14 张现场照片

照片保持原始画面比例;点击放大,放大后可在新标签打开图片继续缩放。原始文件保留在原文件夹。
AI 代码审查框架概念示意图

成建坤
华润数科高级工程师

16:25–17:00
议程时间,以会议海报为准

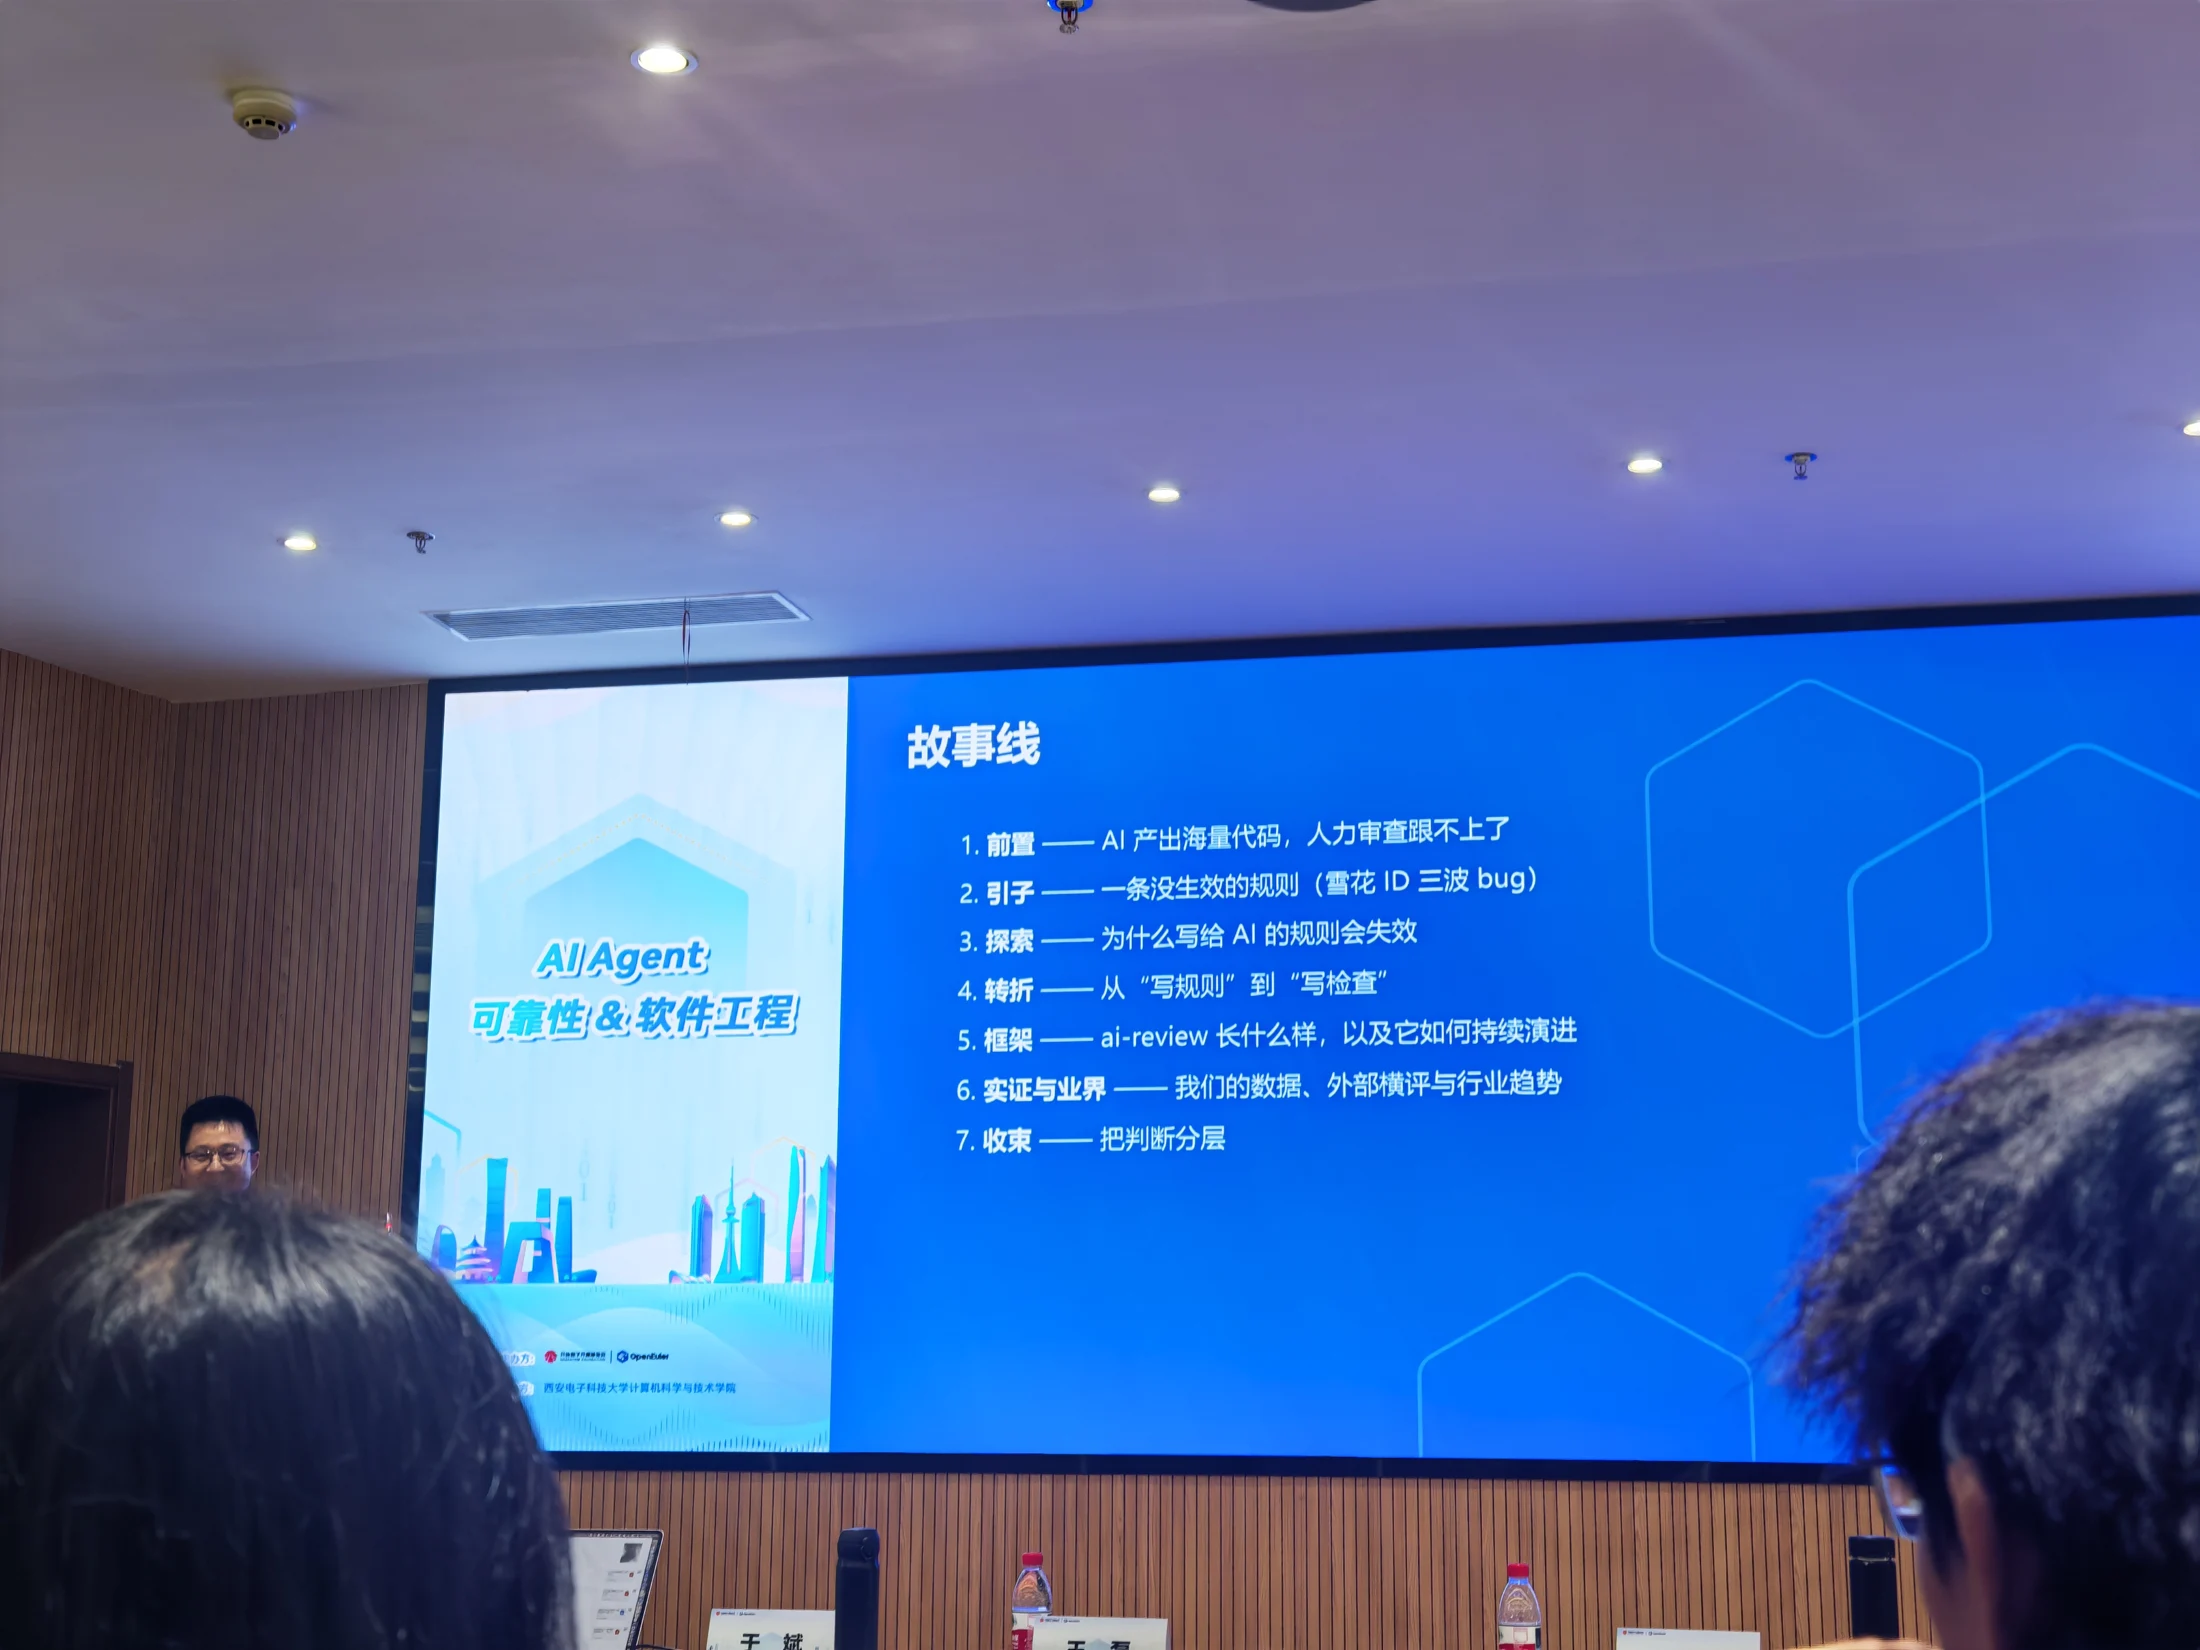
从一条没生效的规则说起:AI 代码审查框架的诞生、演进与落地

能写成检查的规则,放进每次执行的流程。

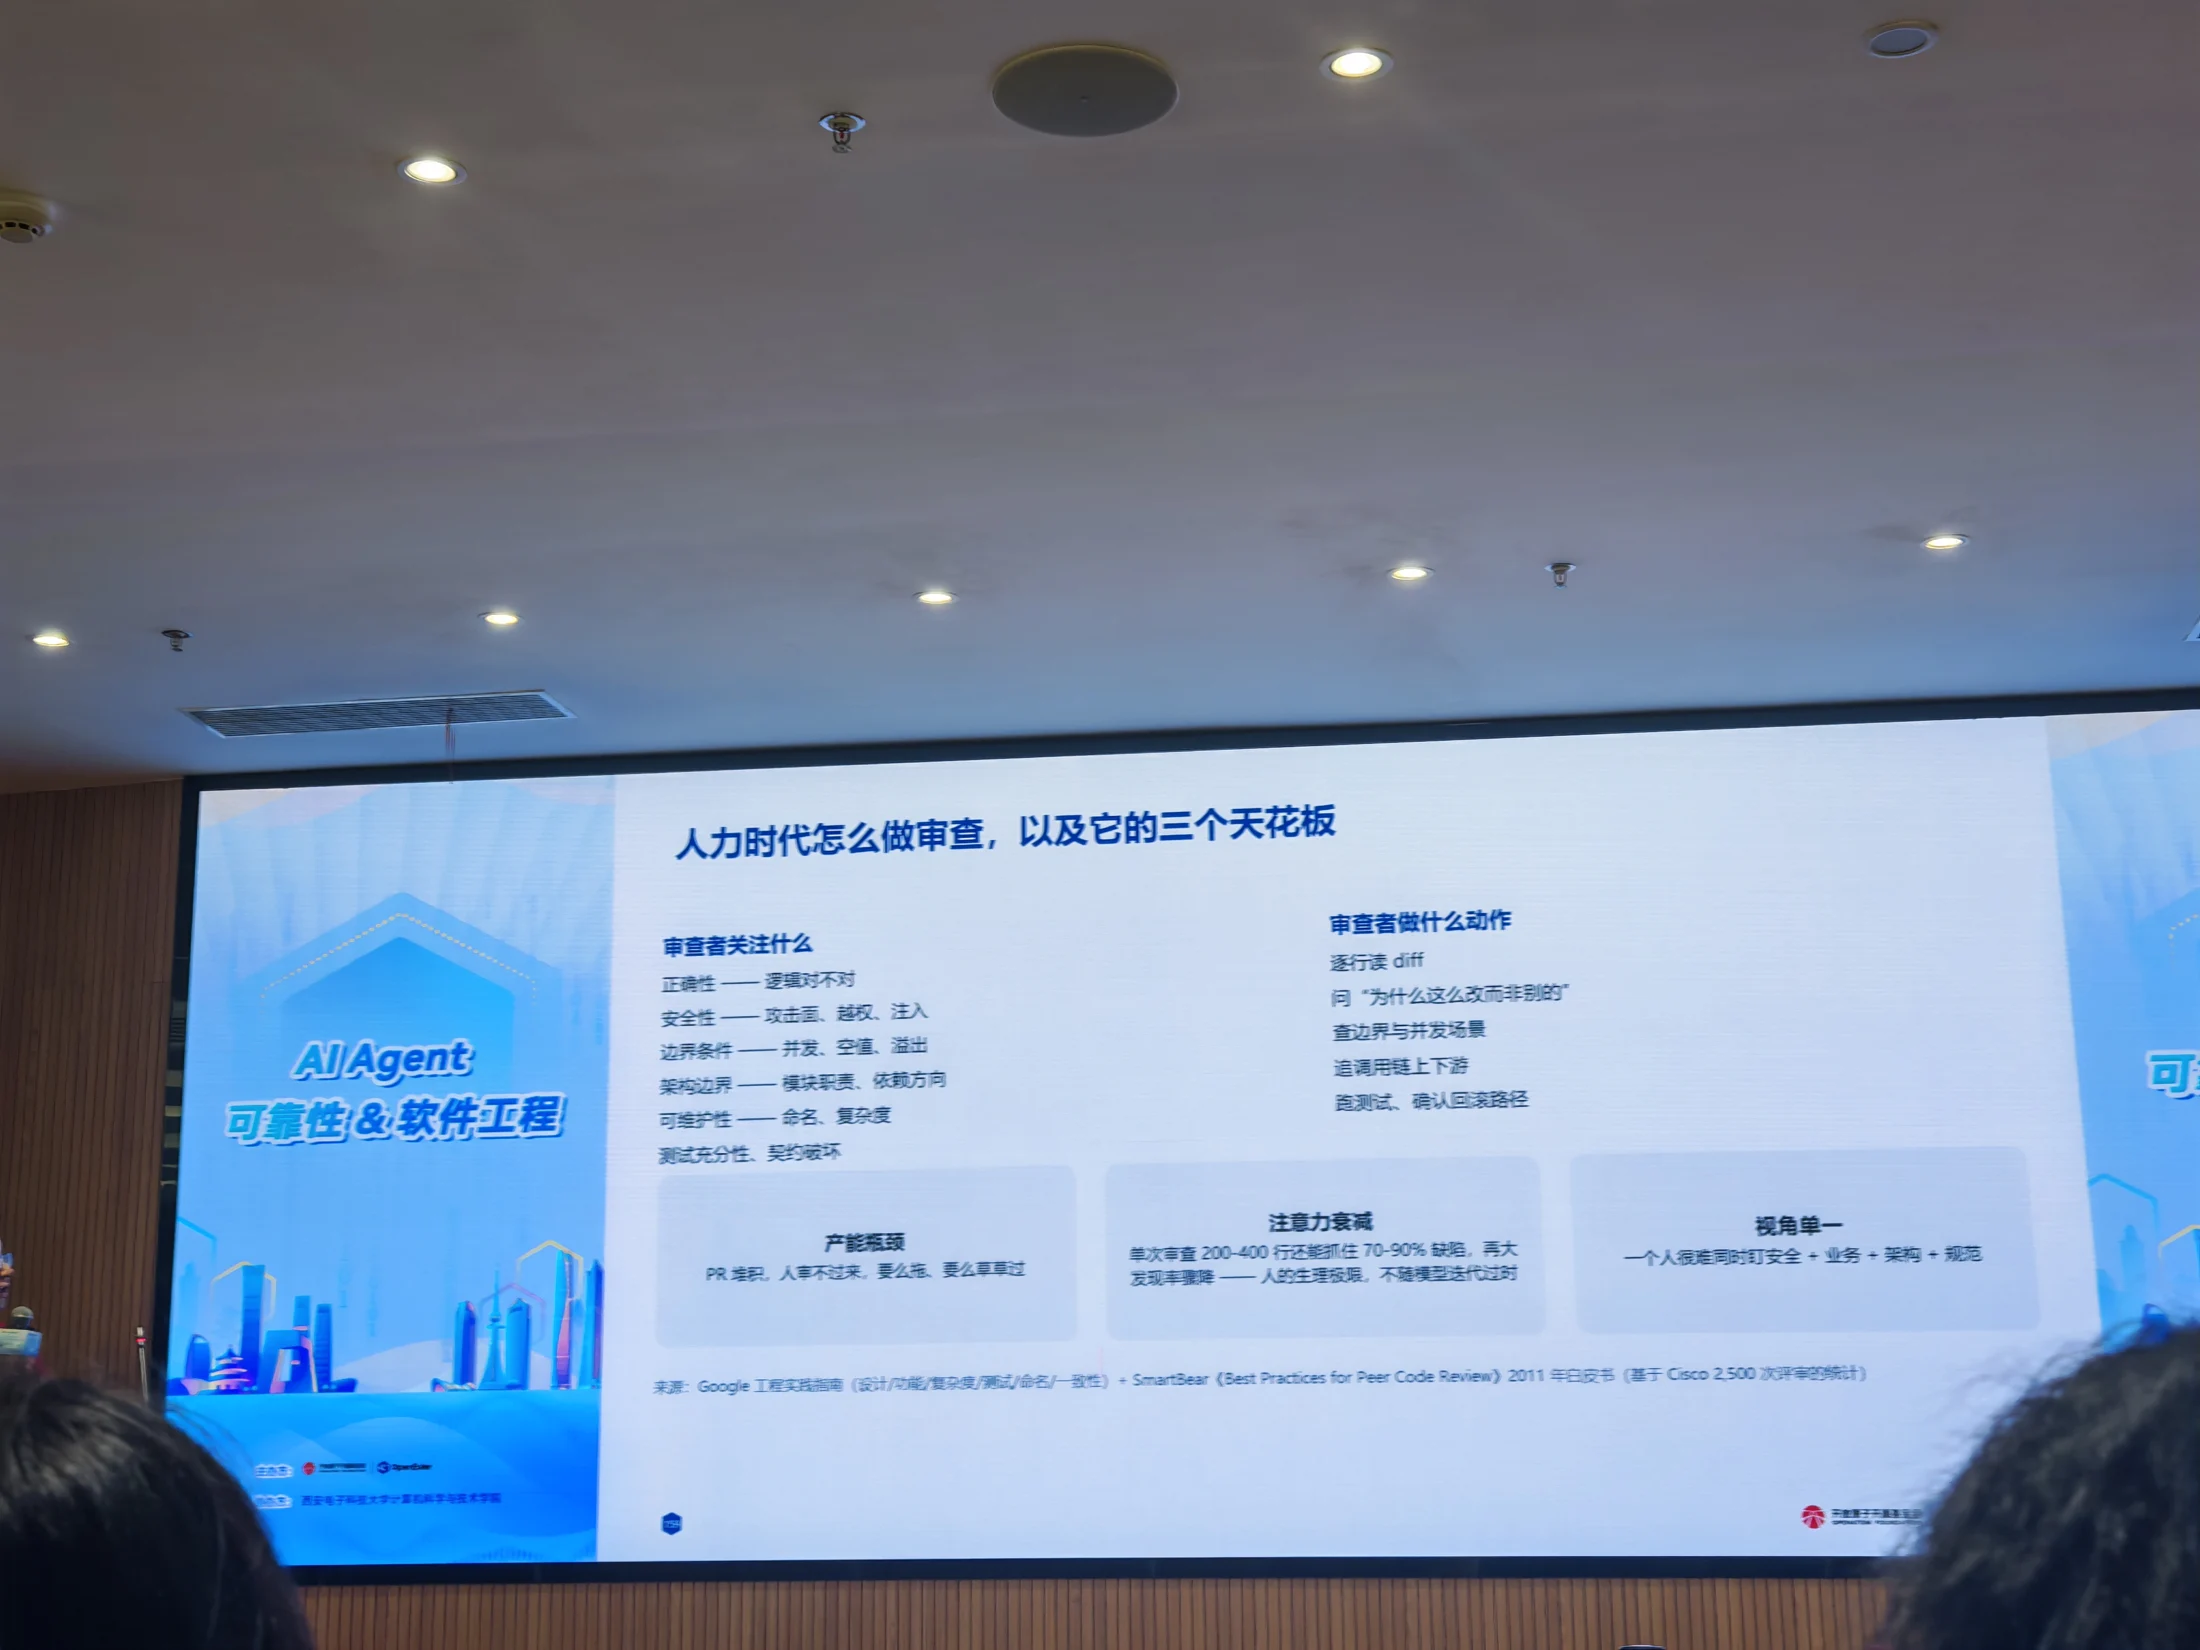
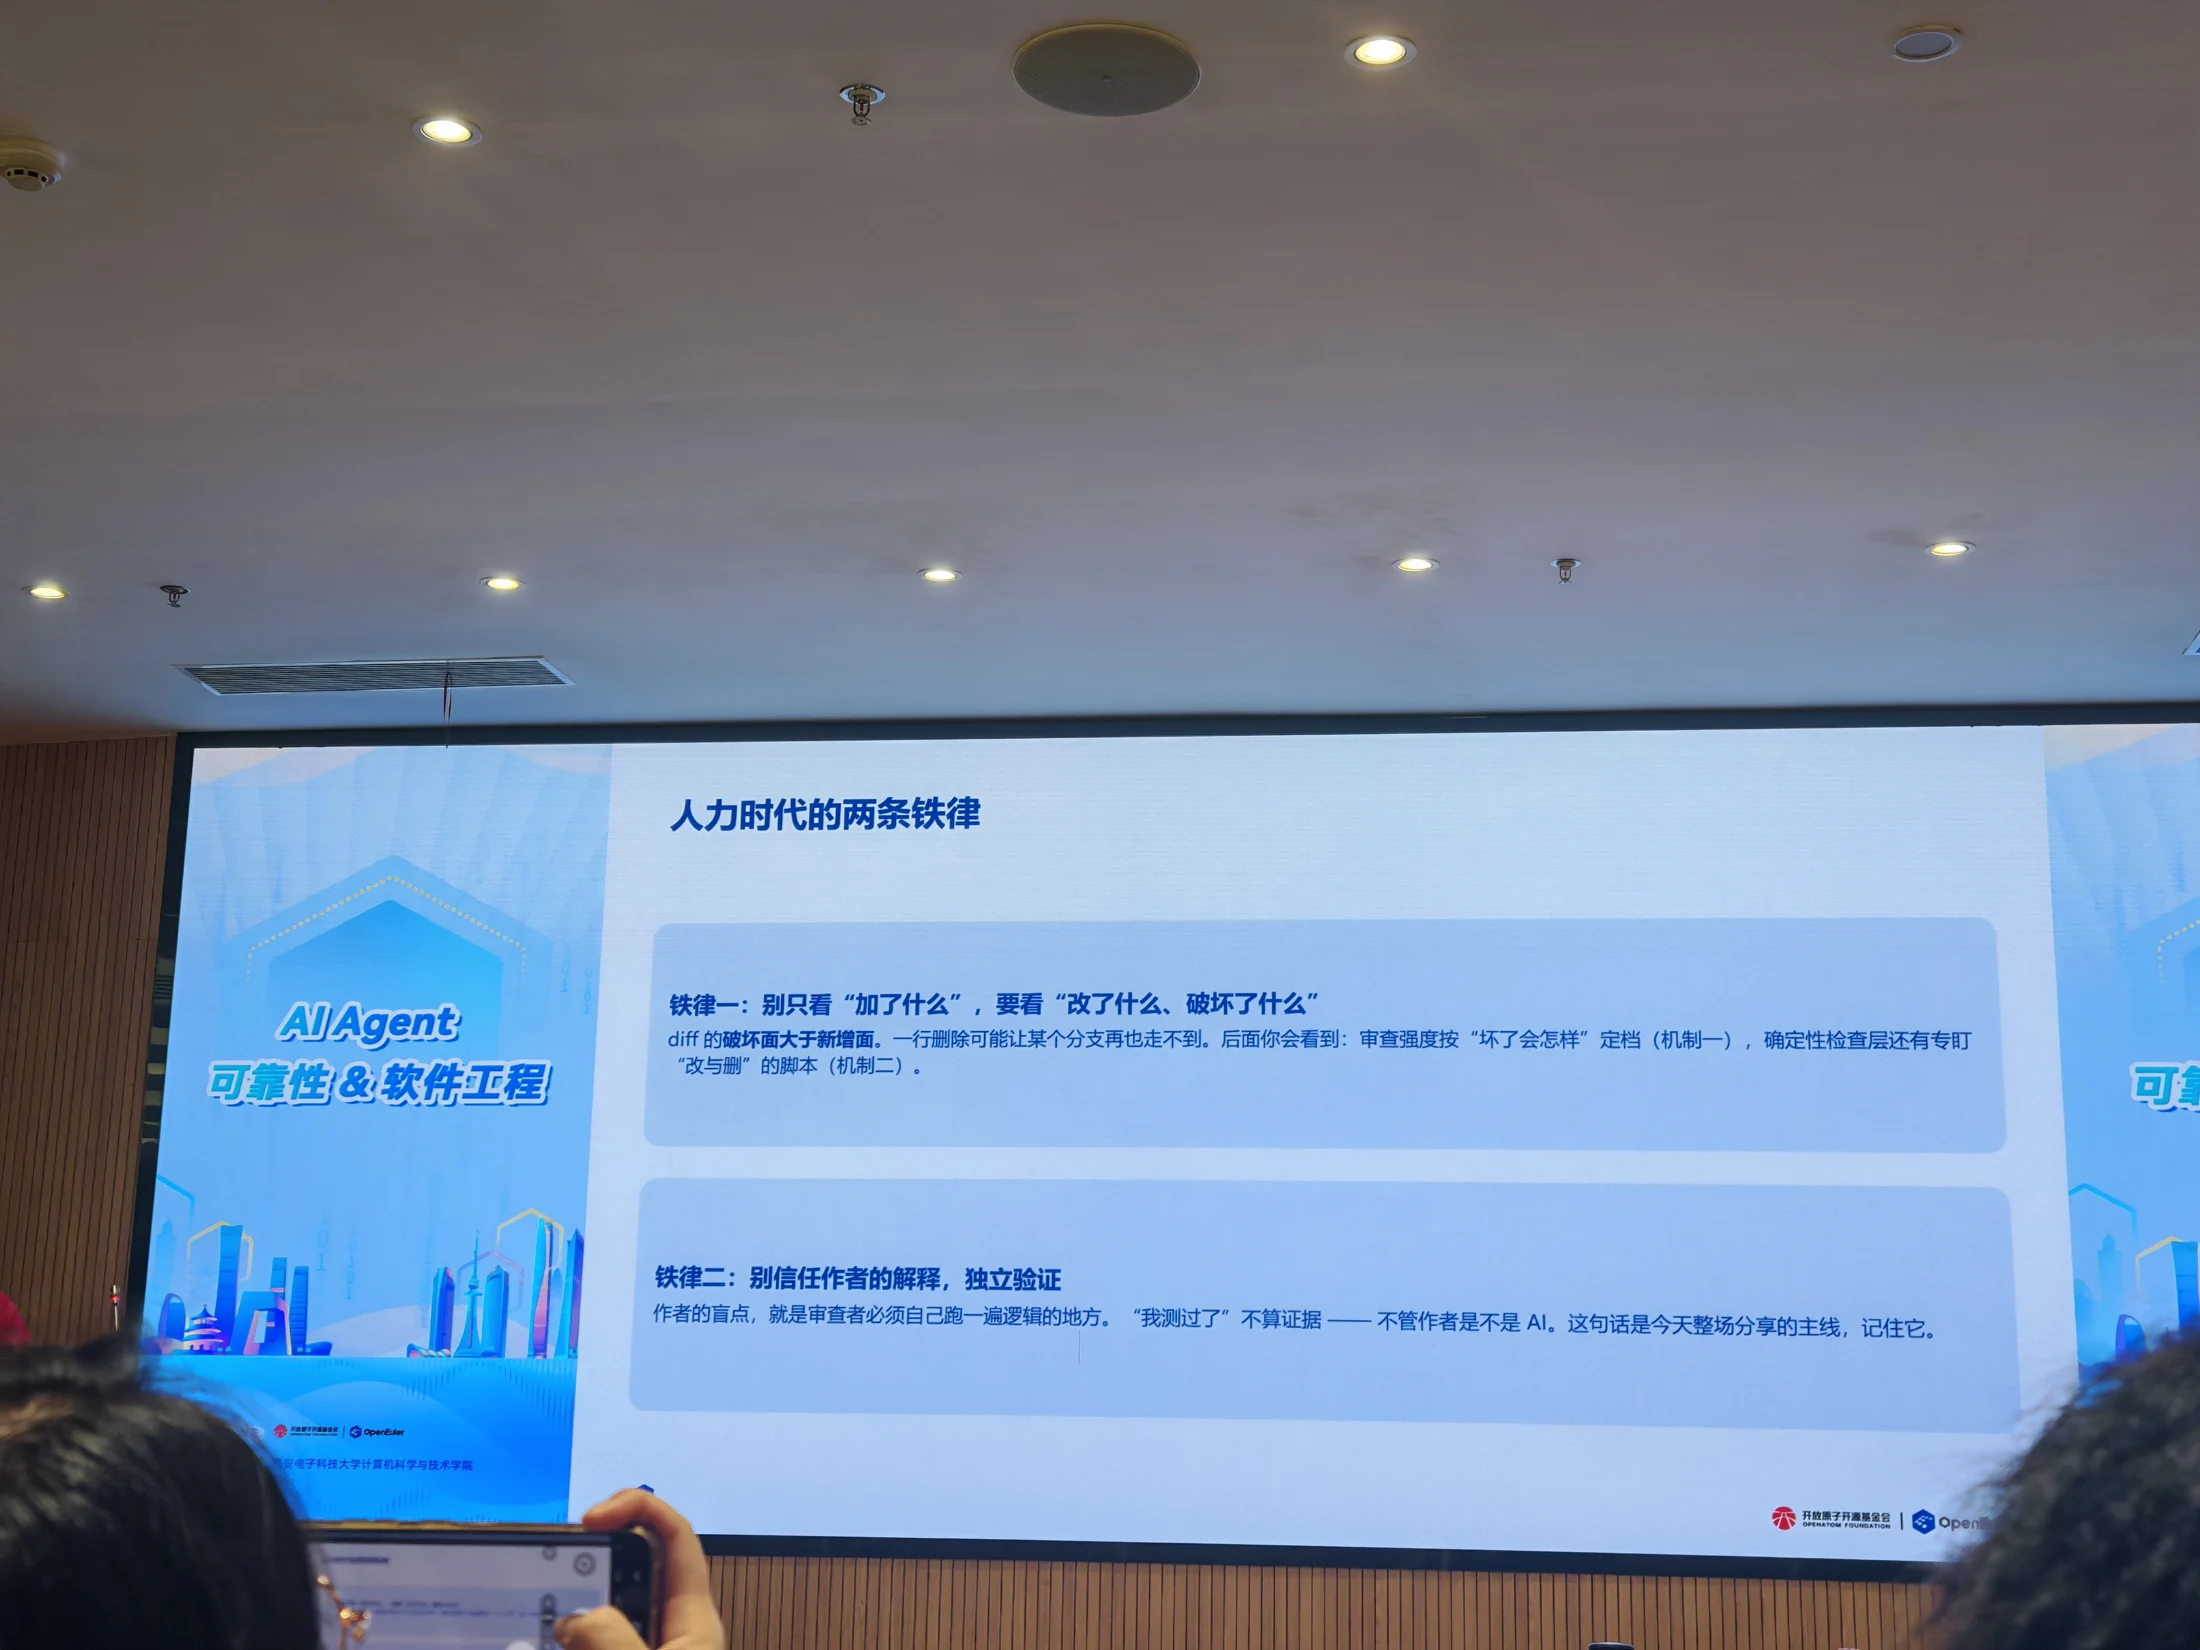
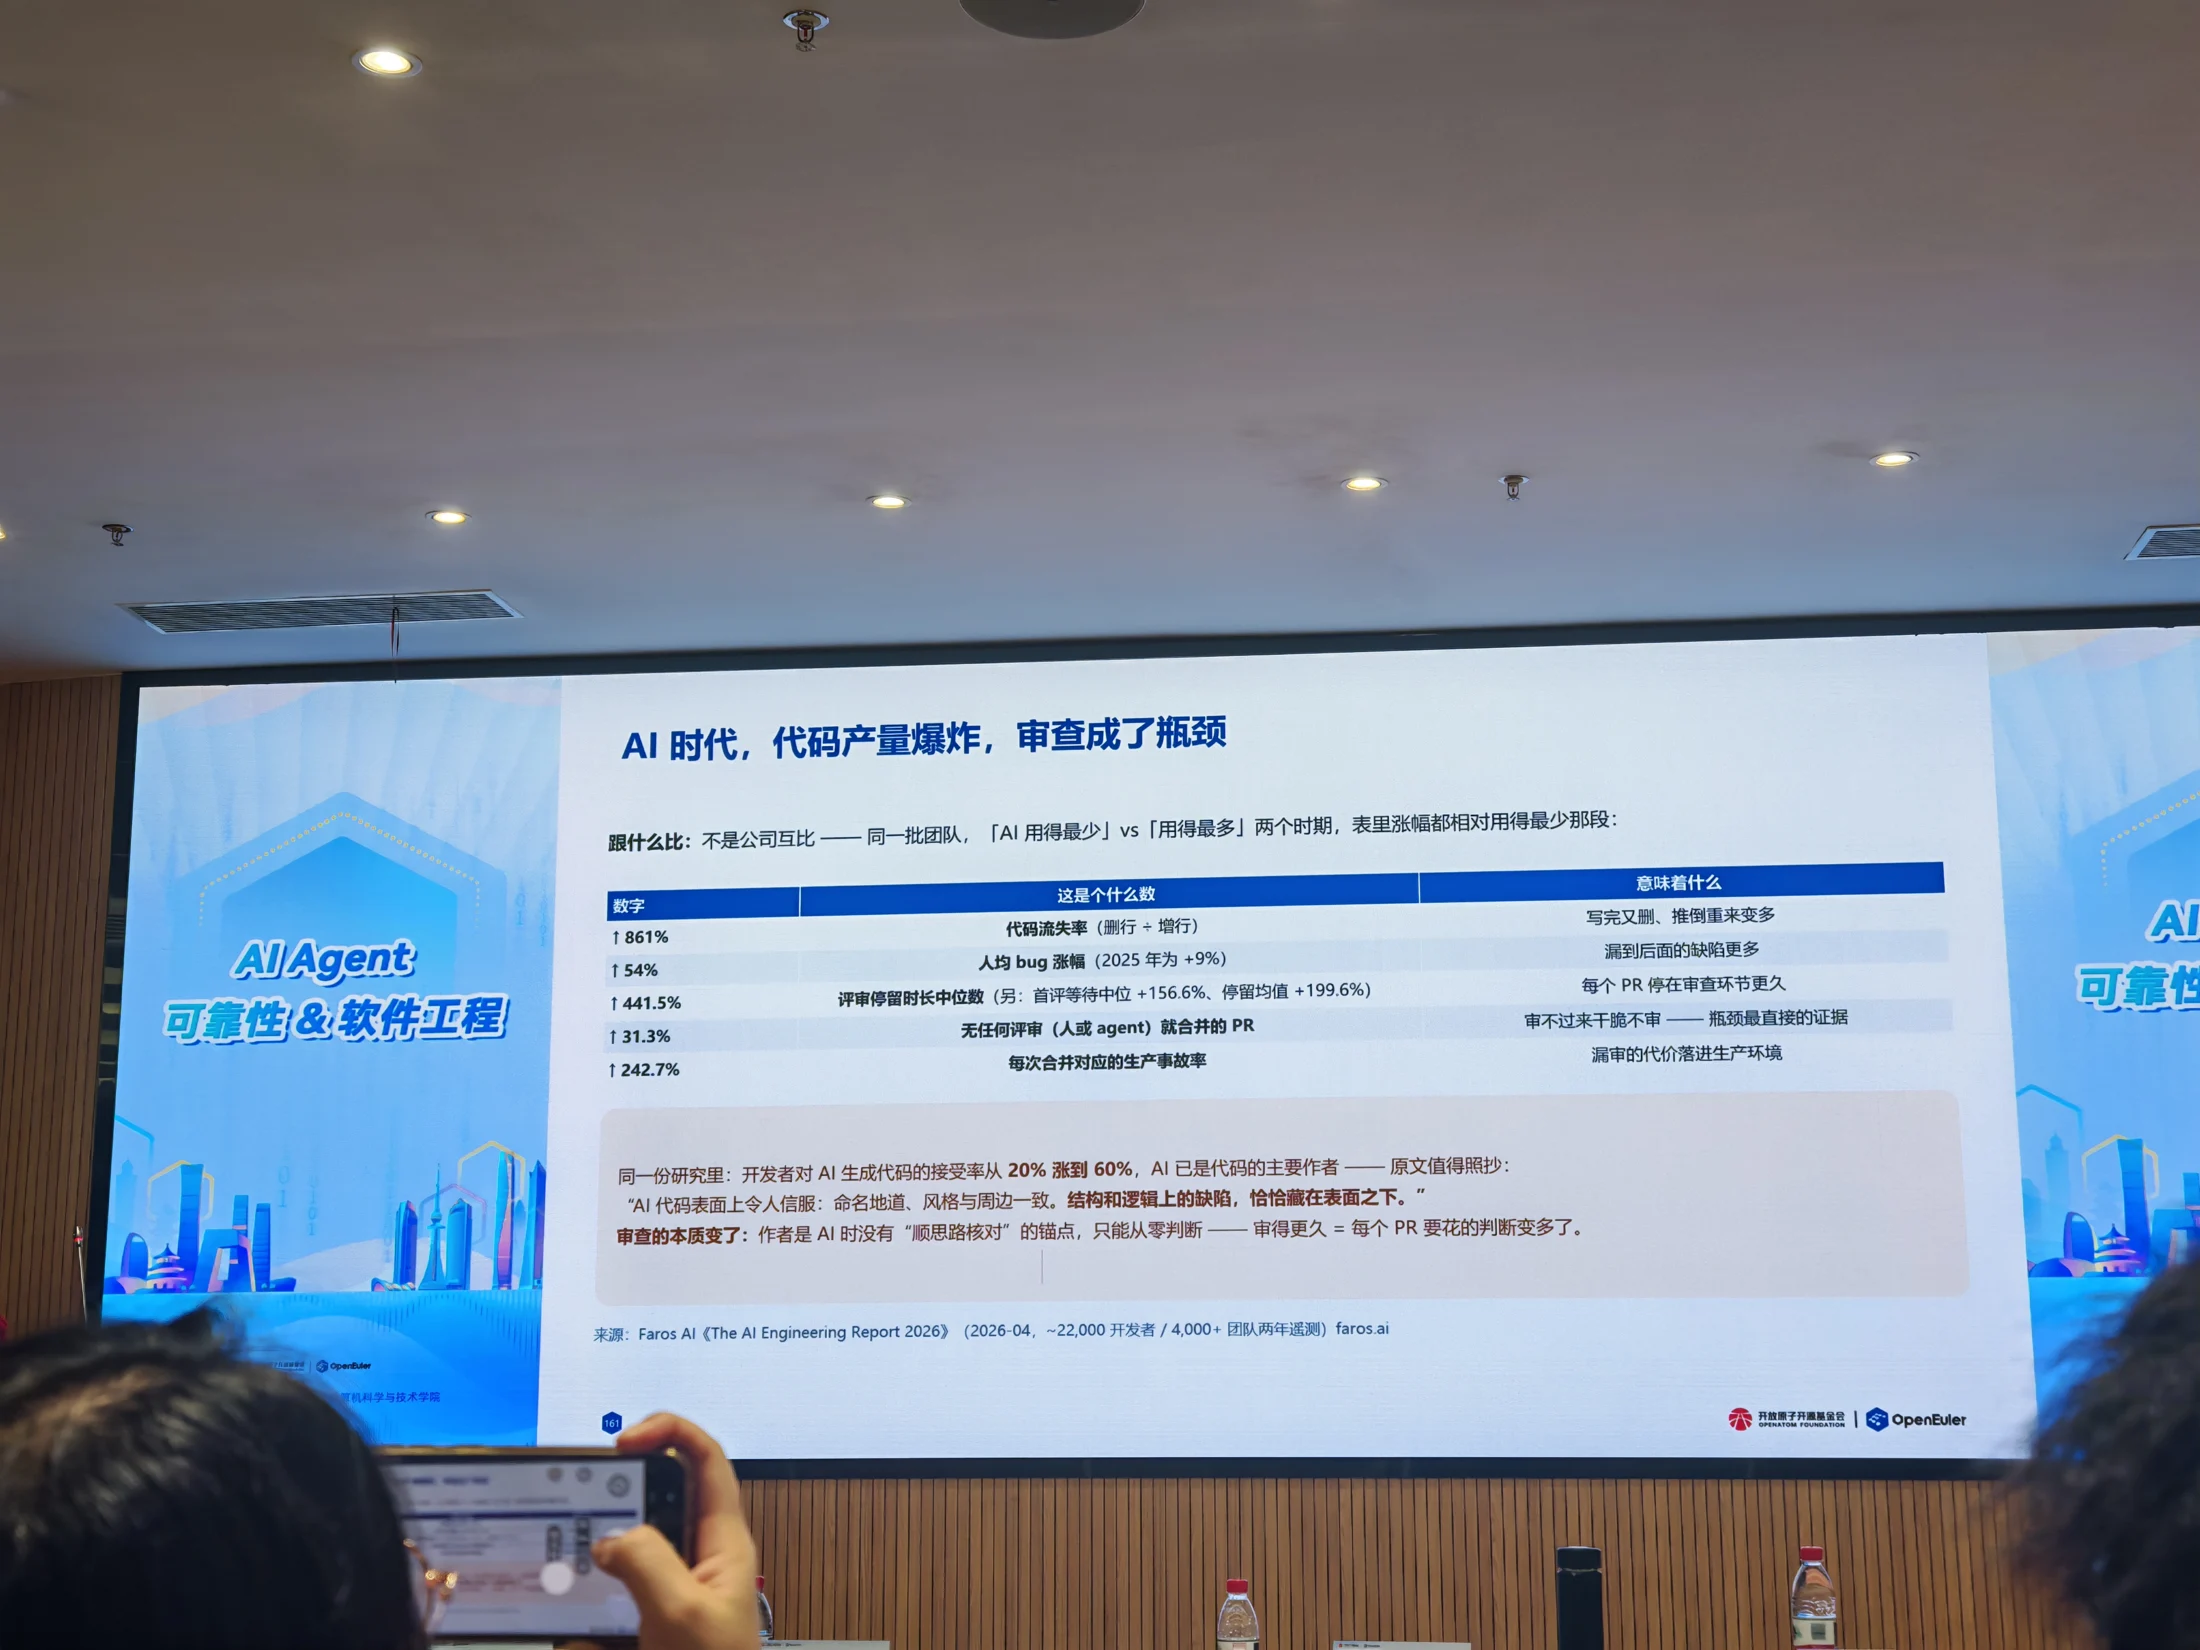
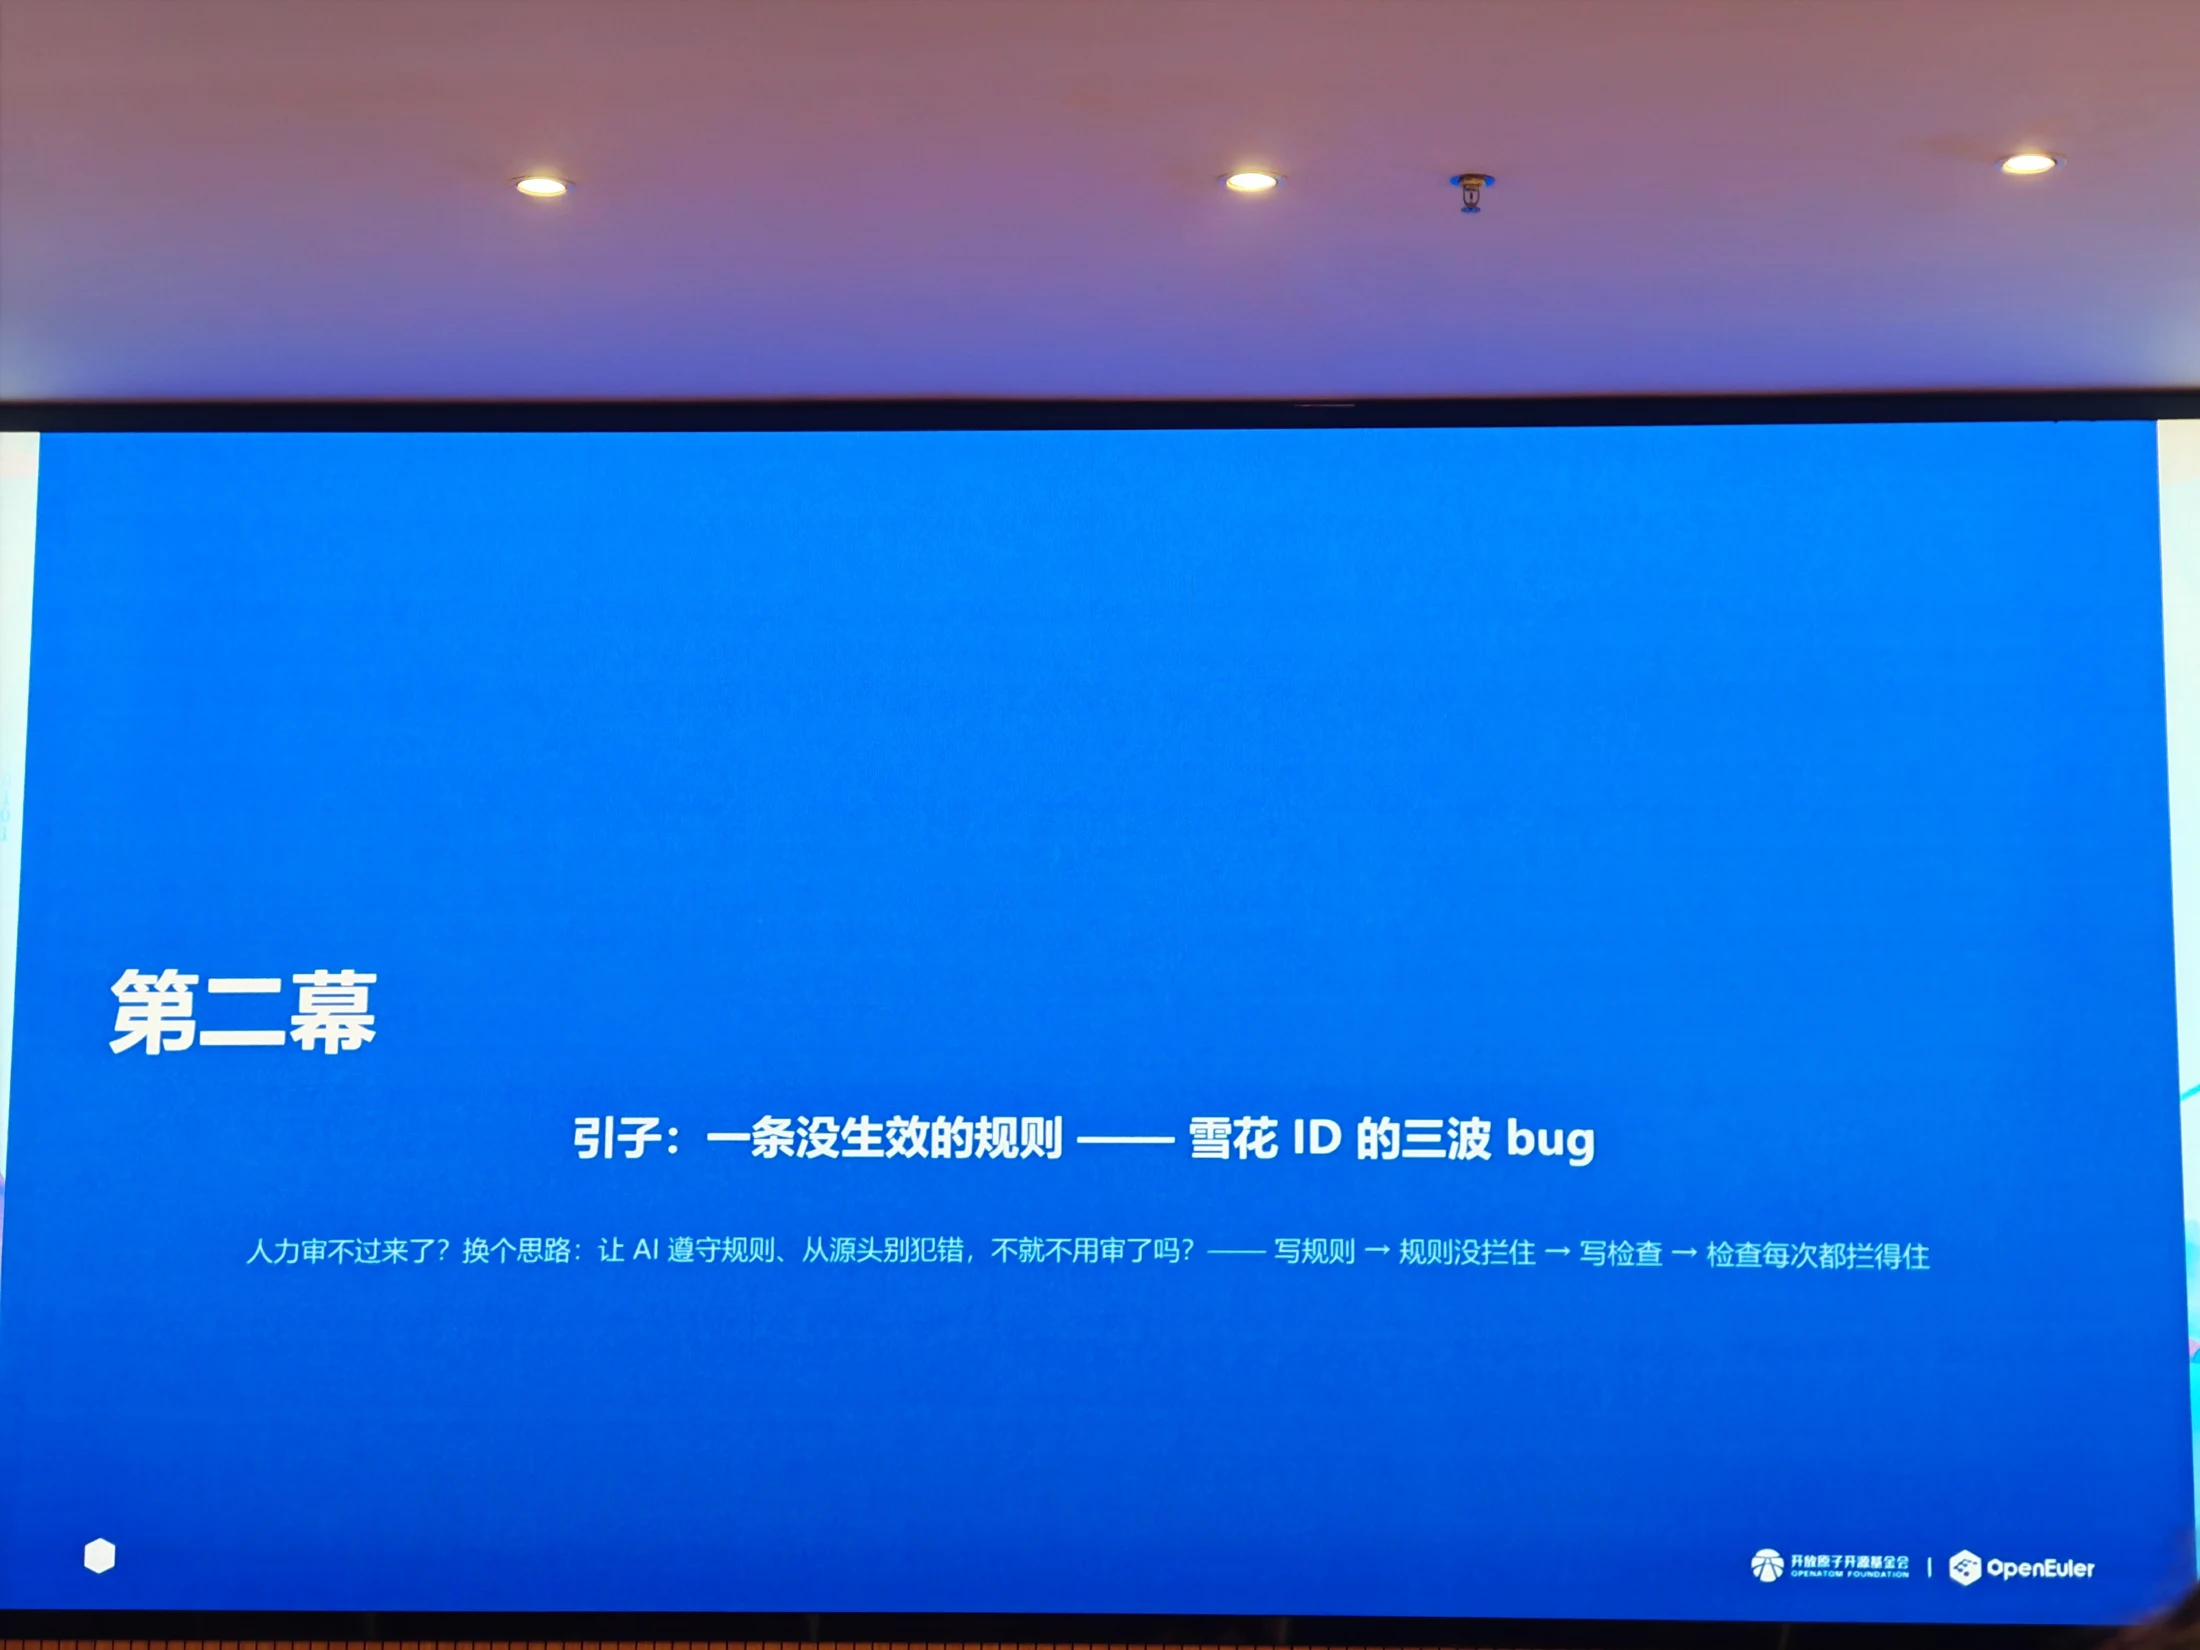
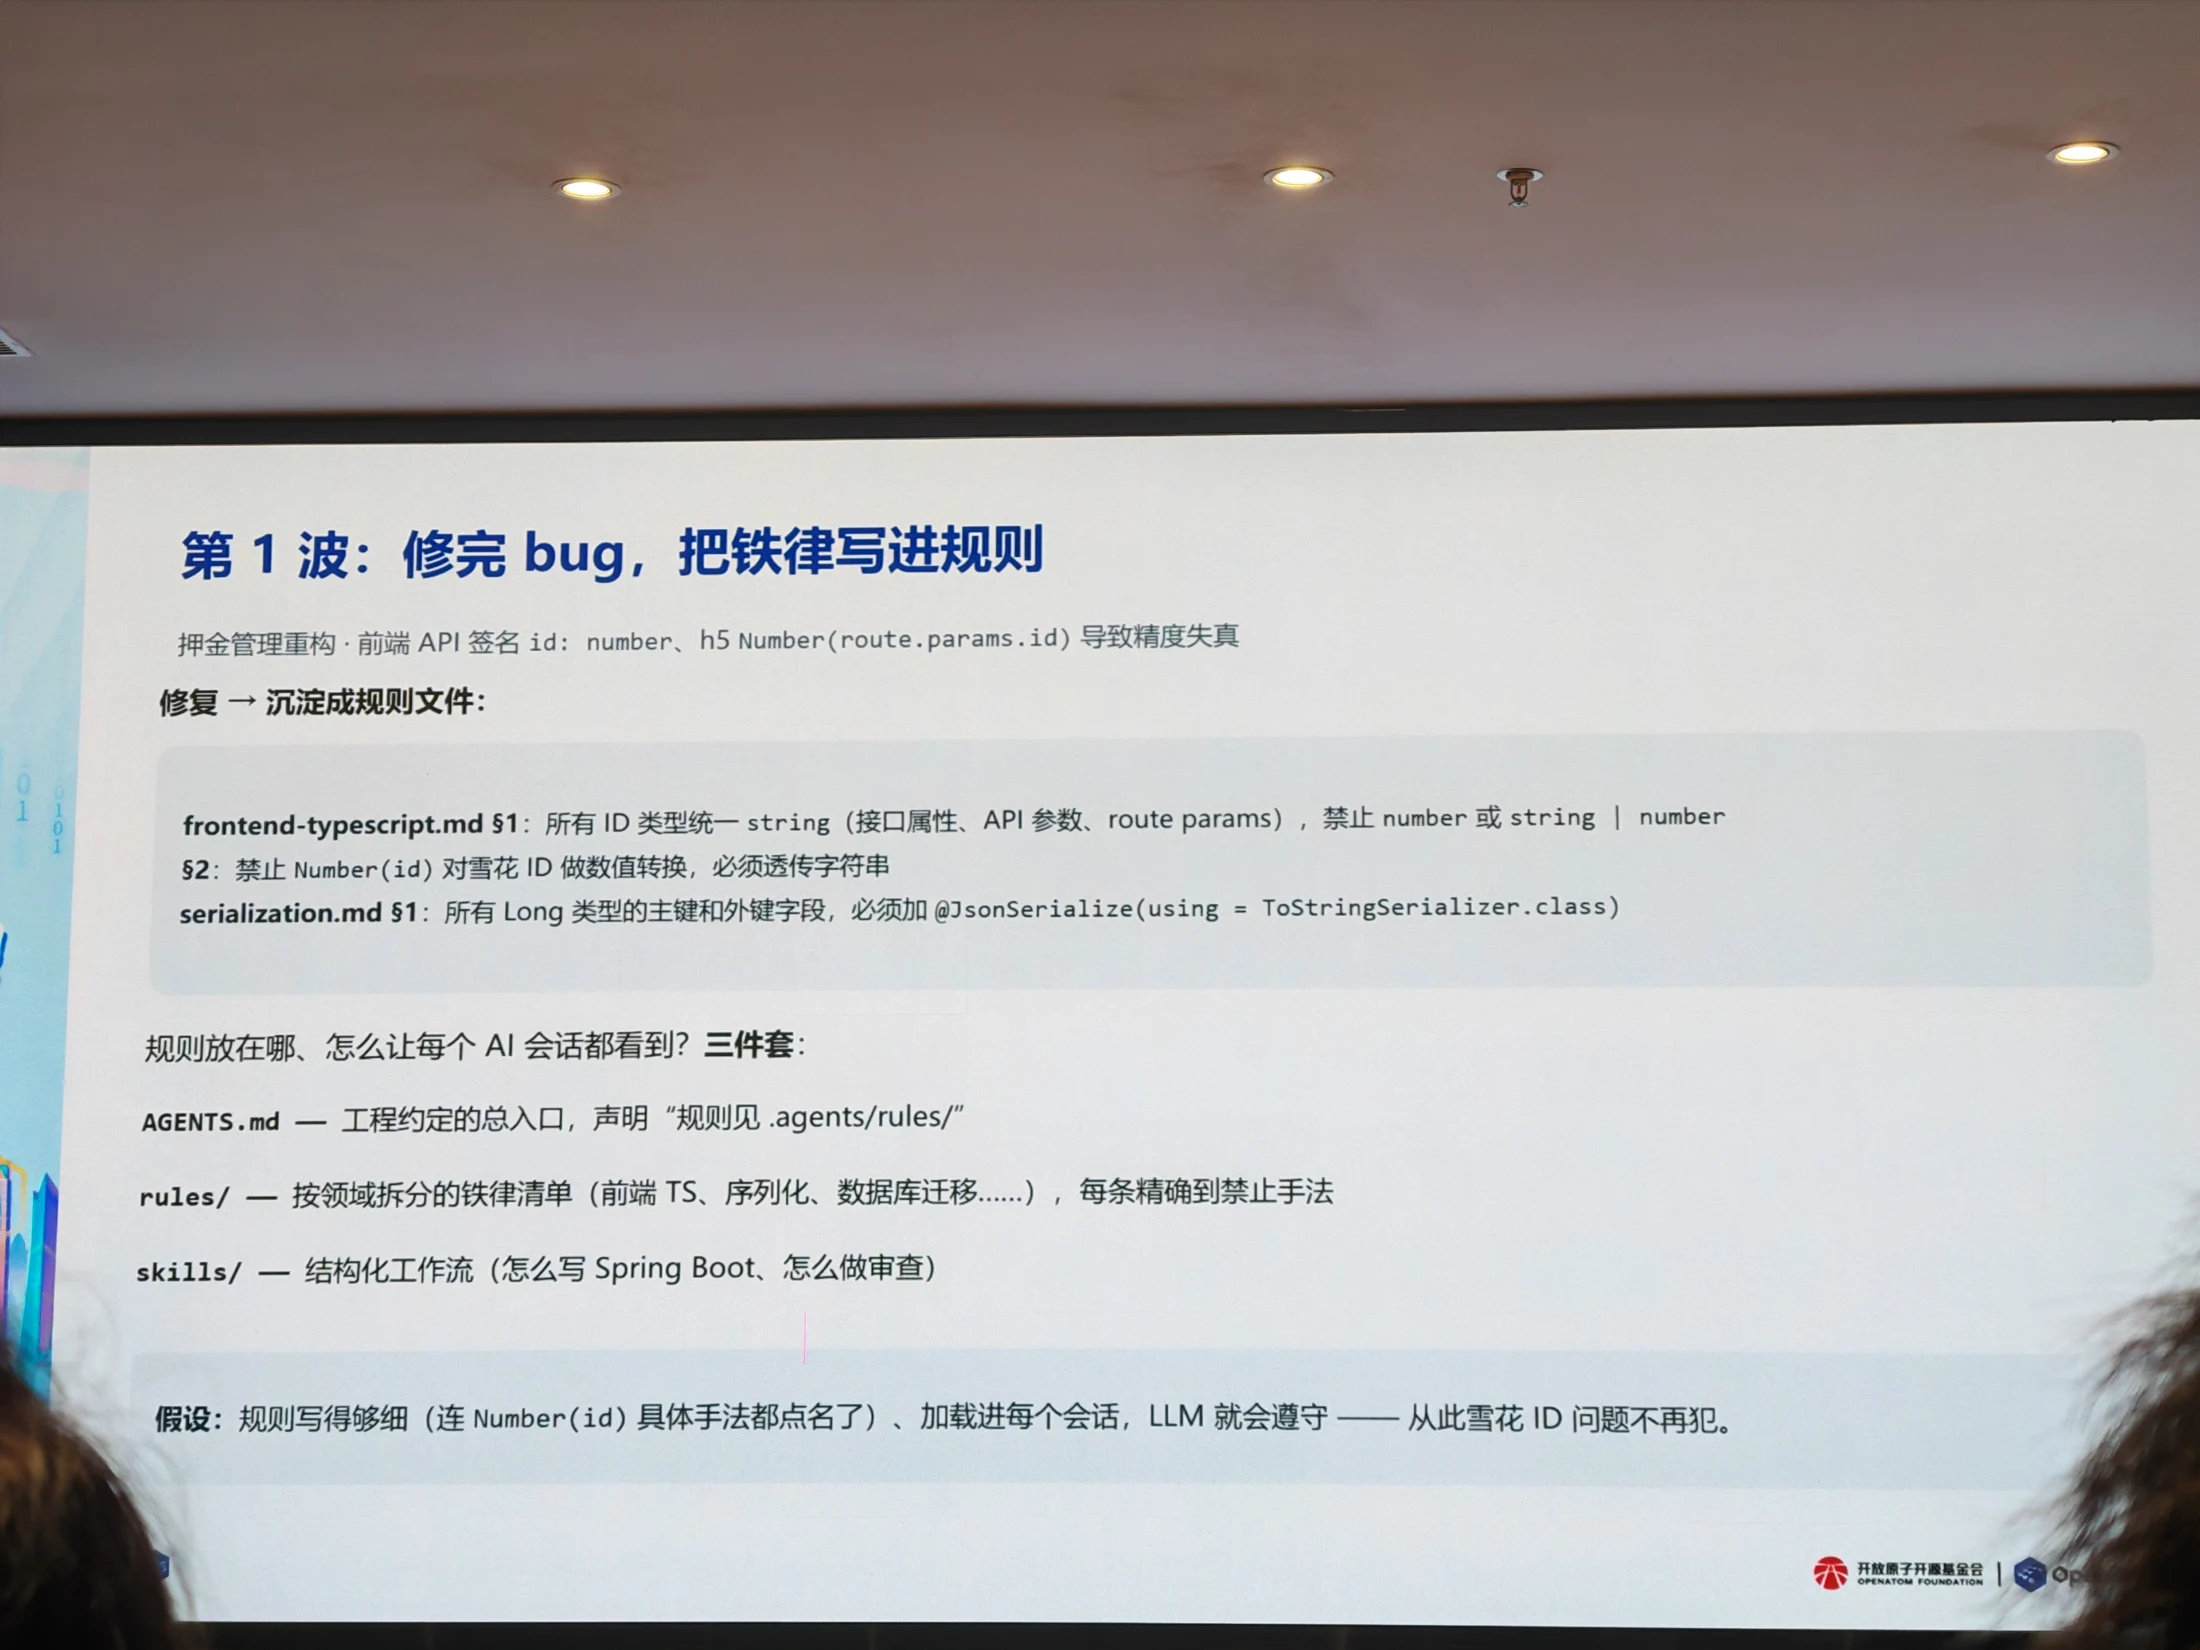
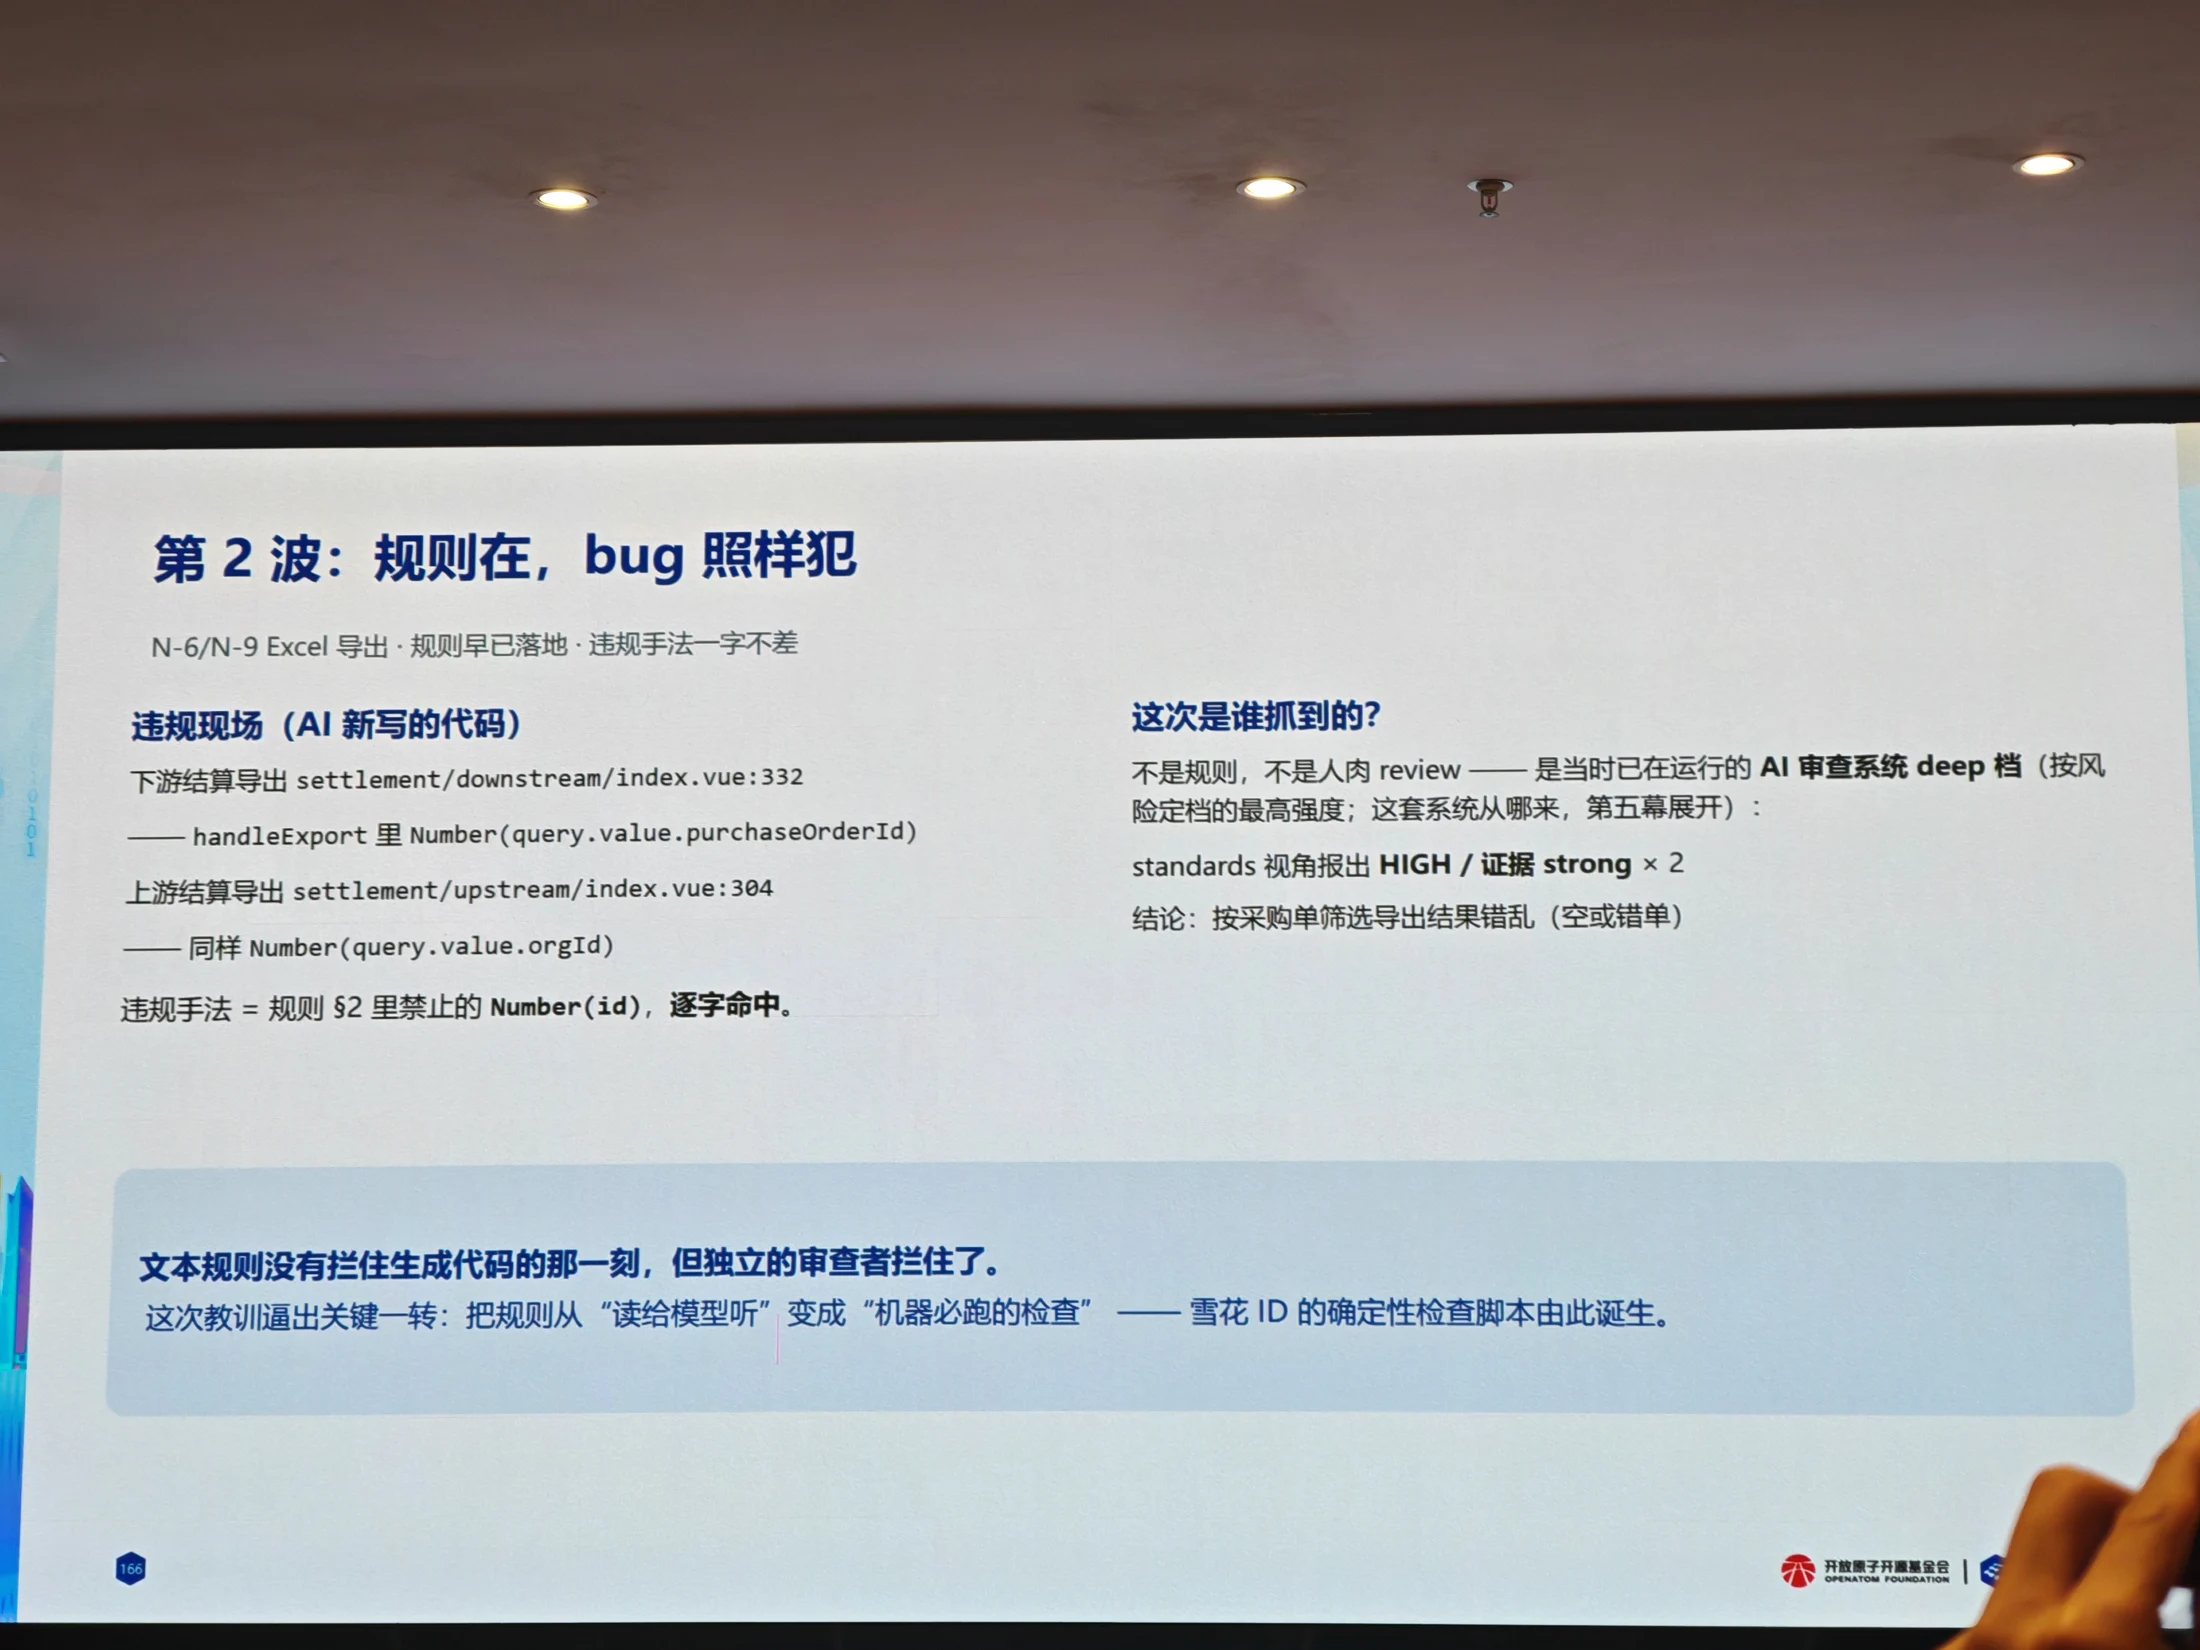
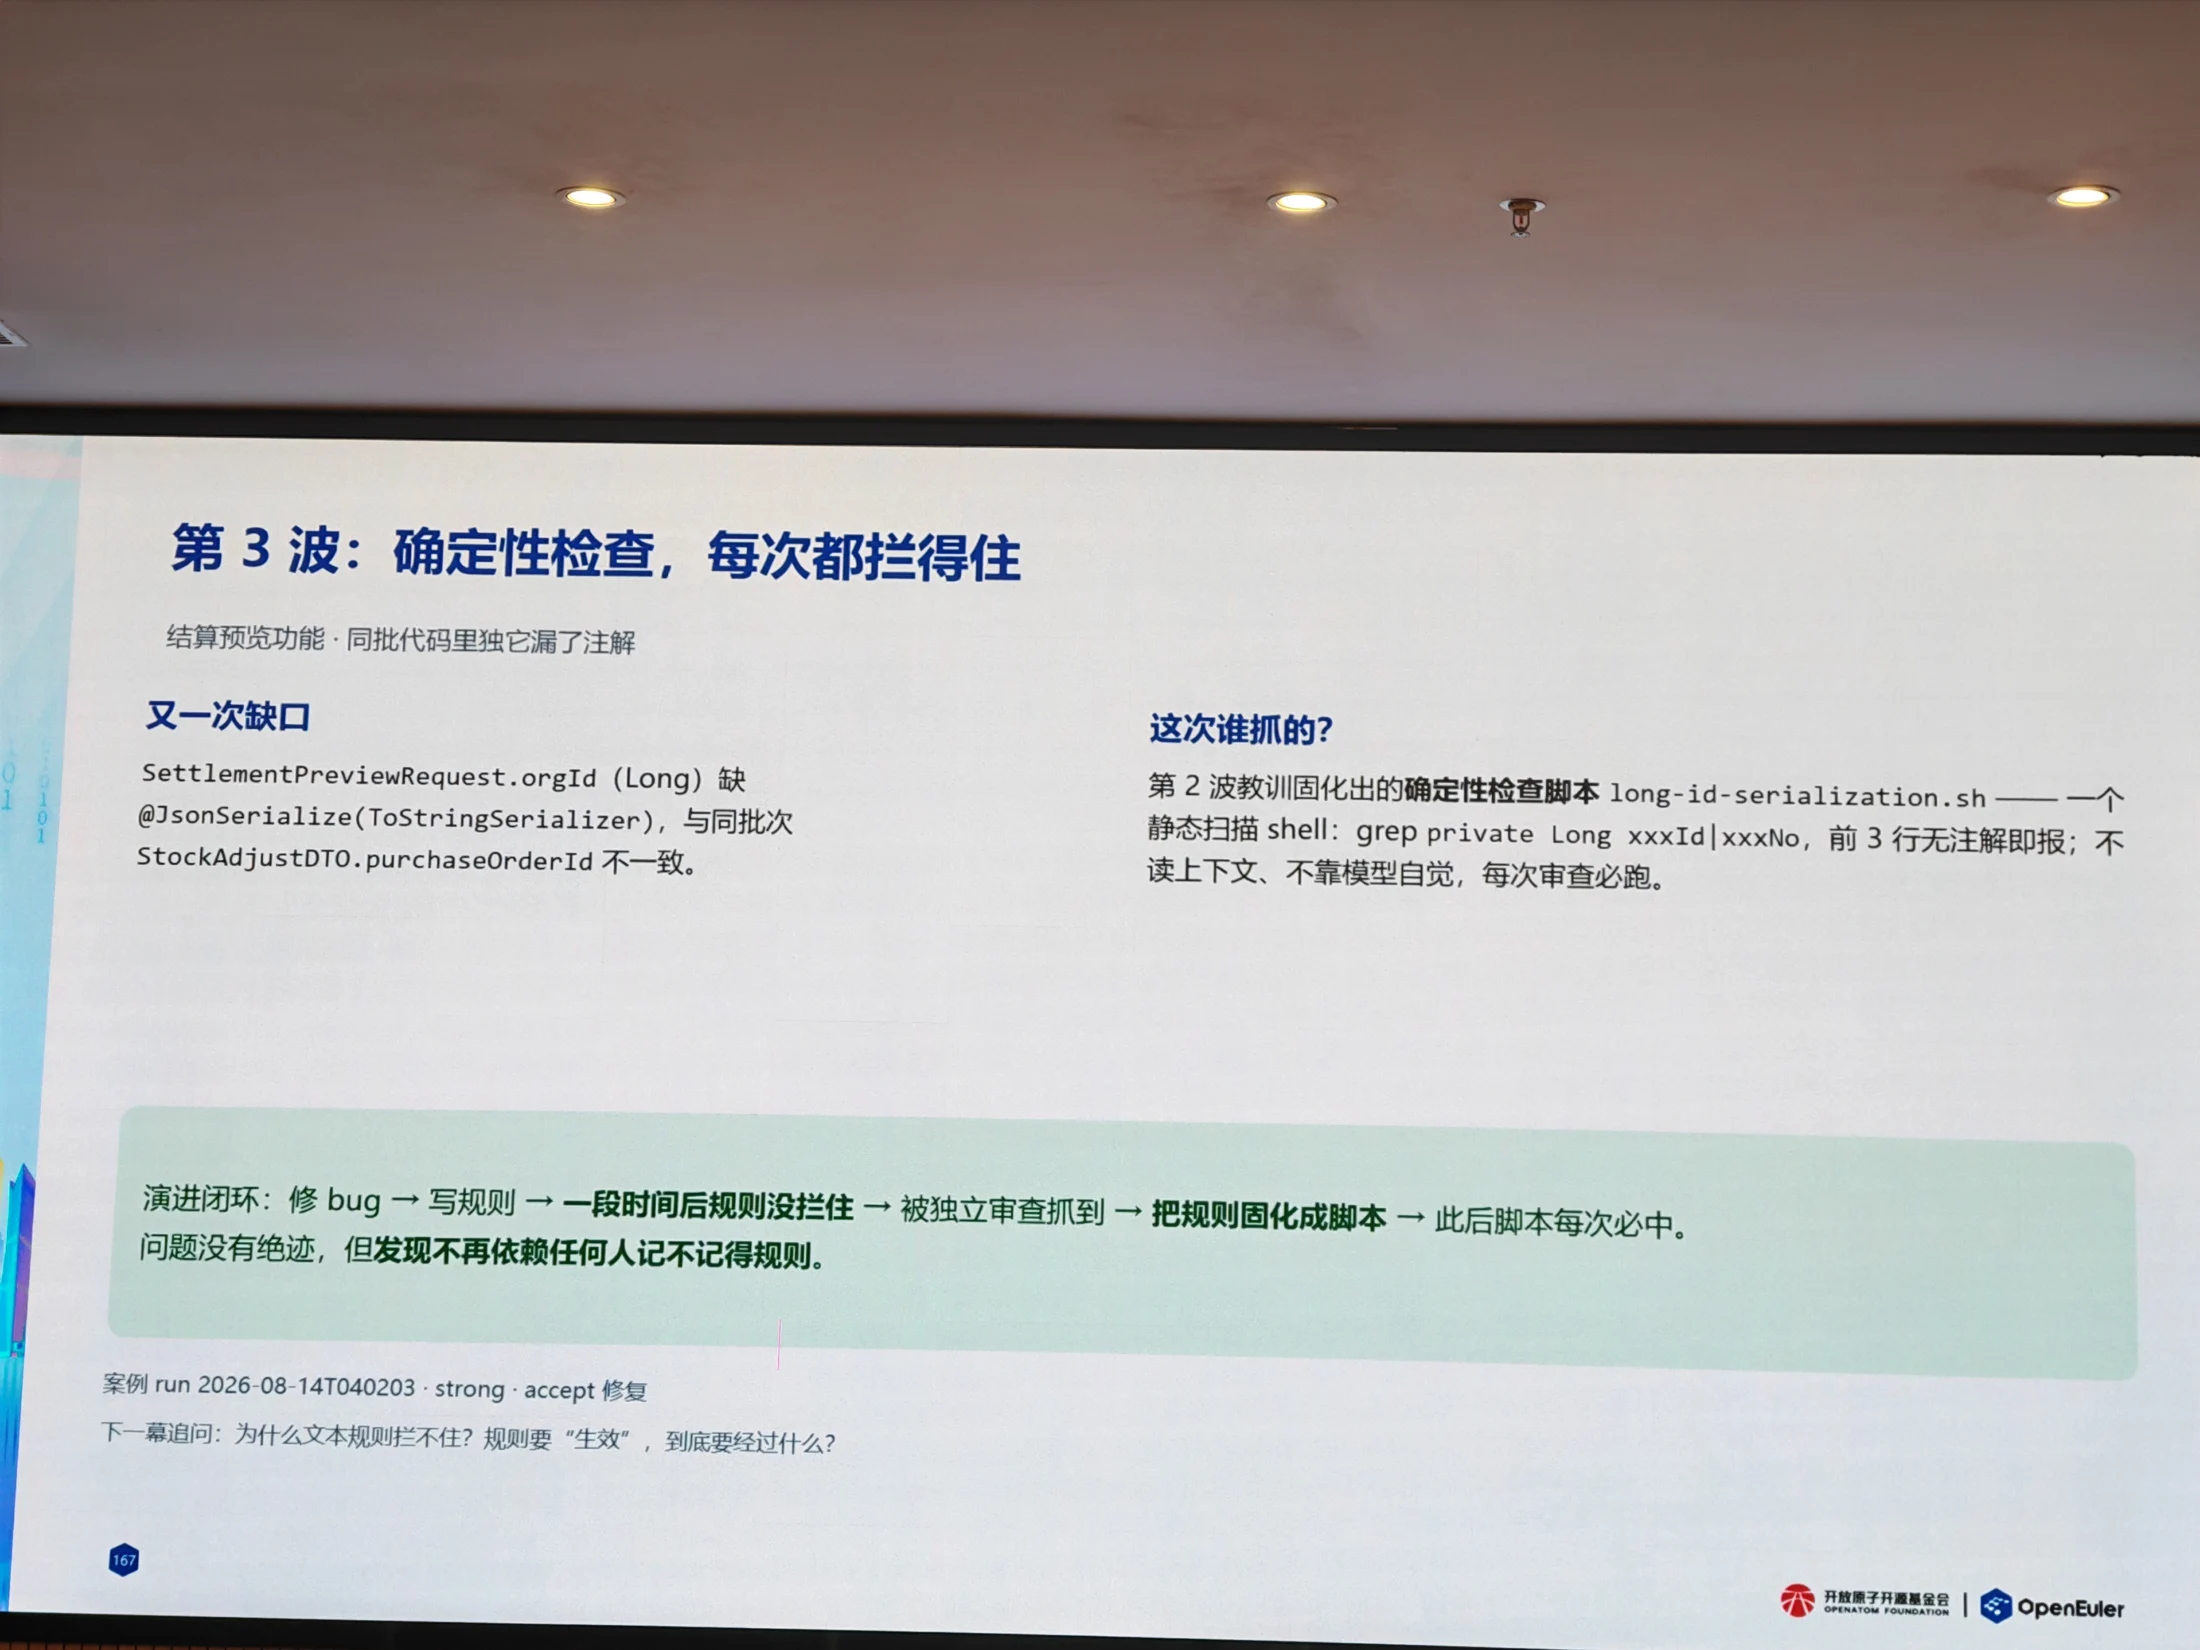
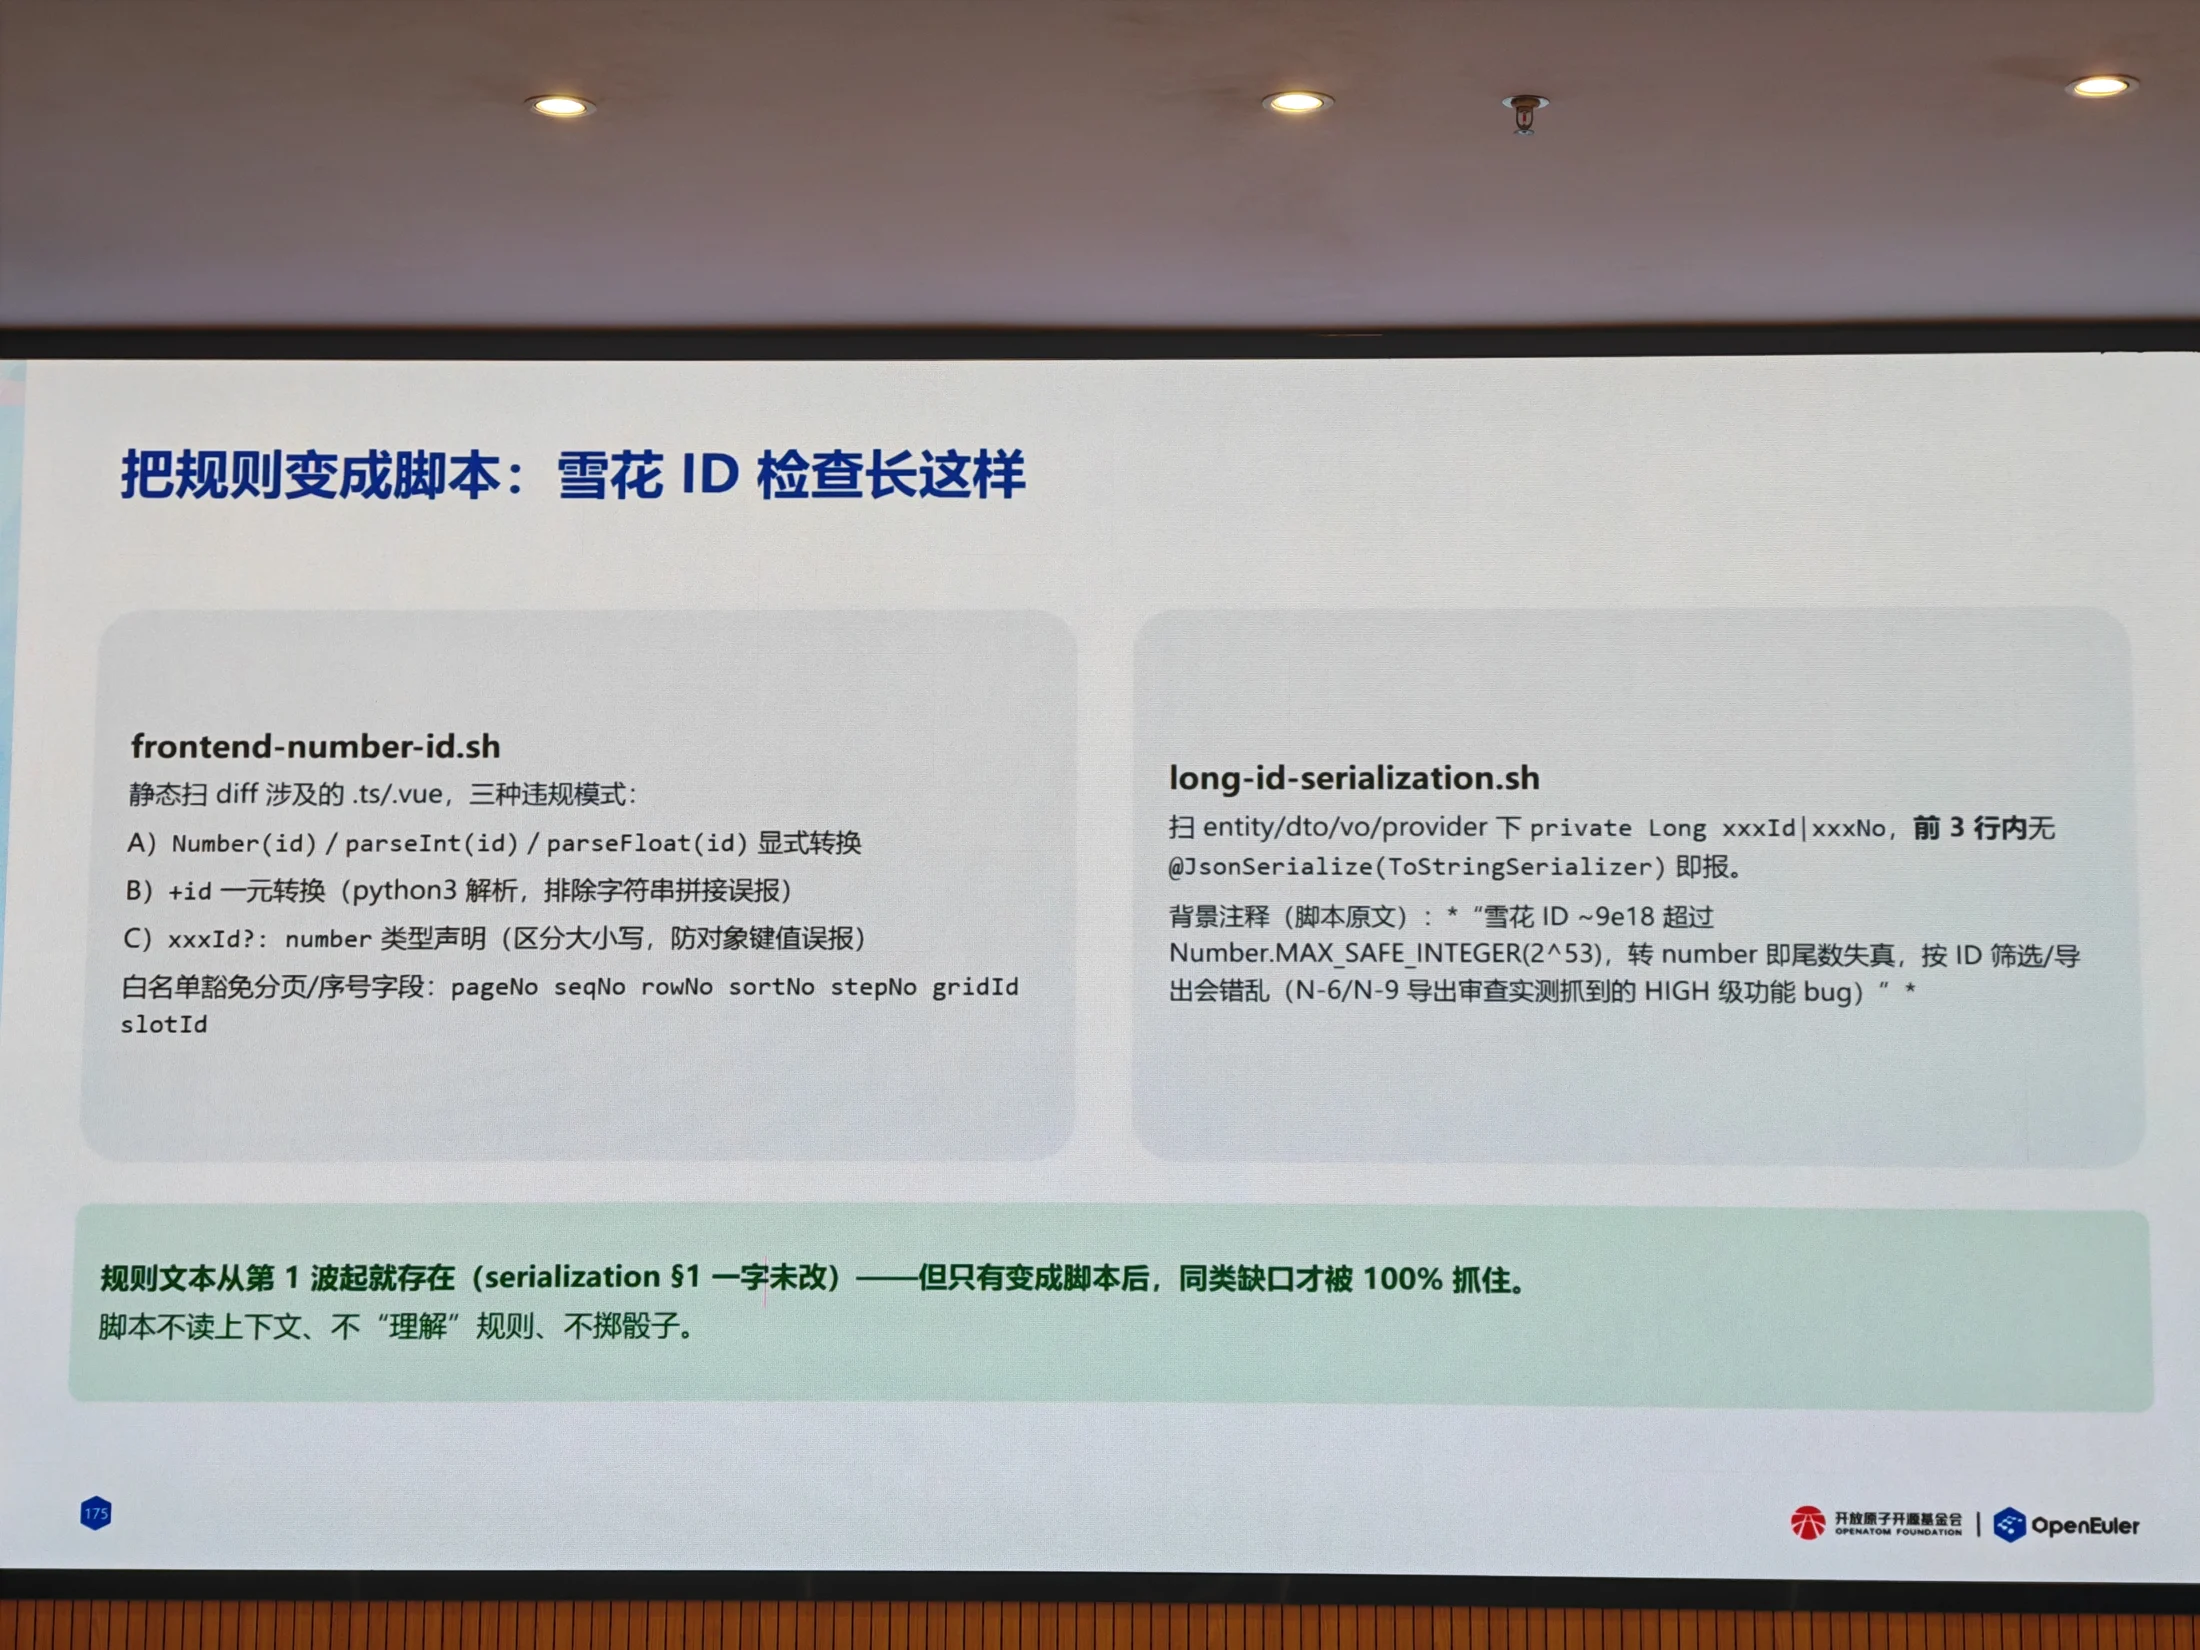
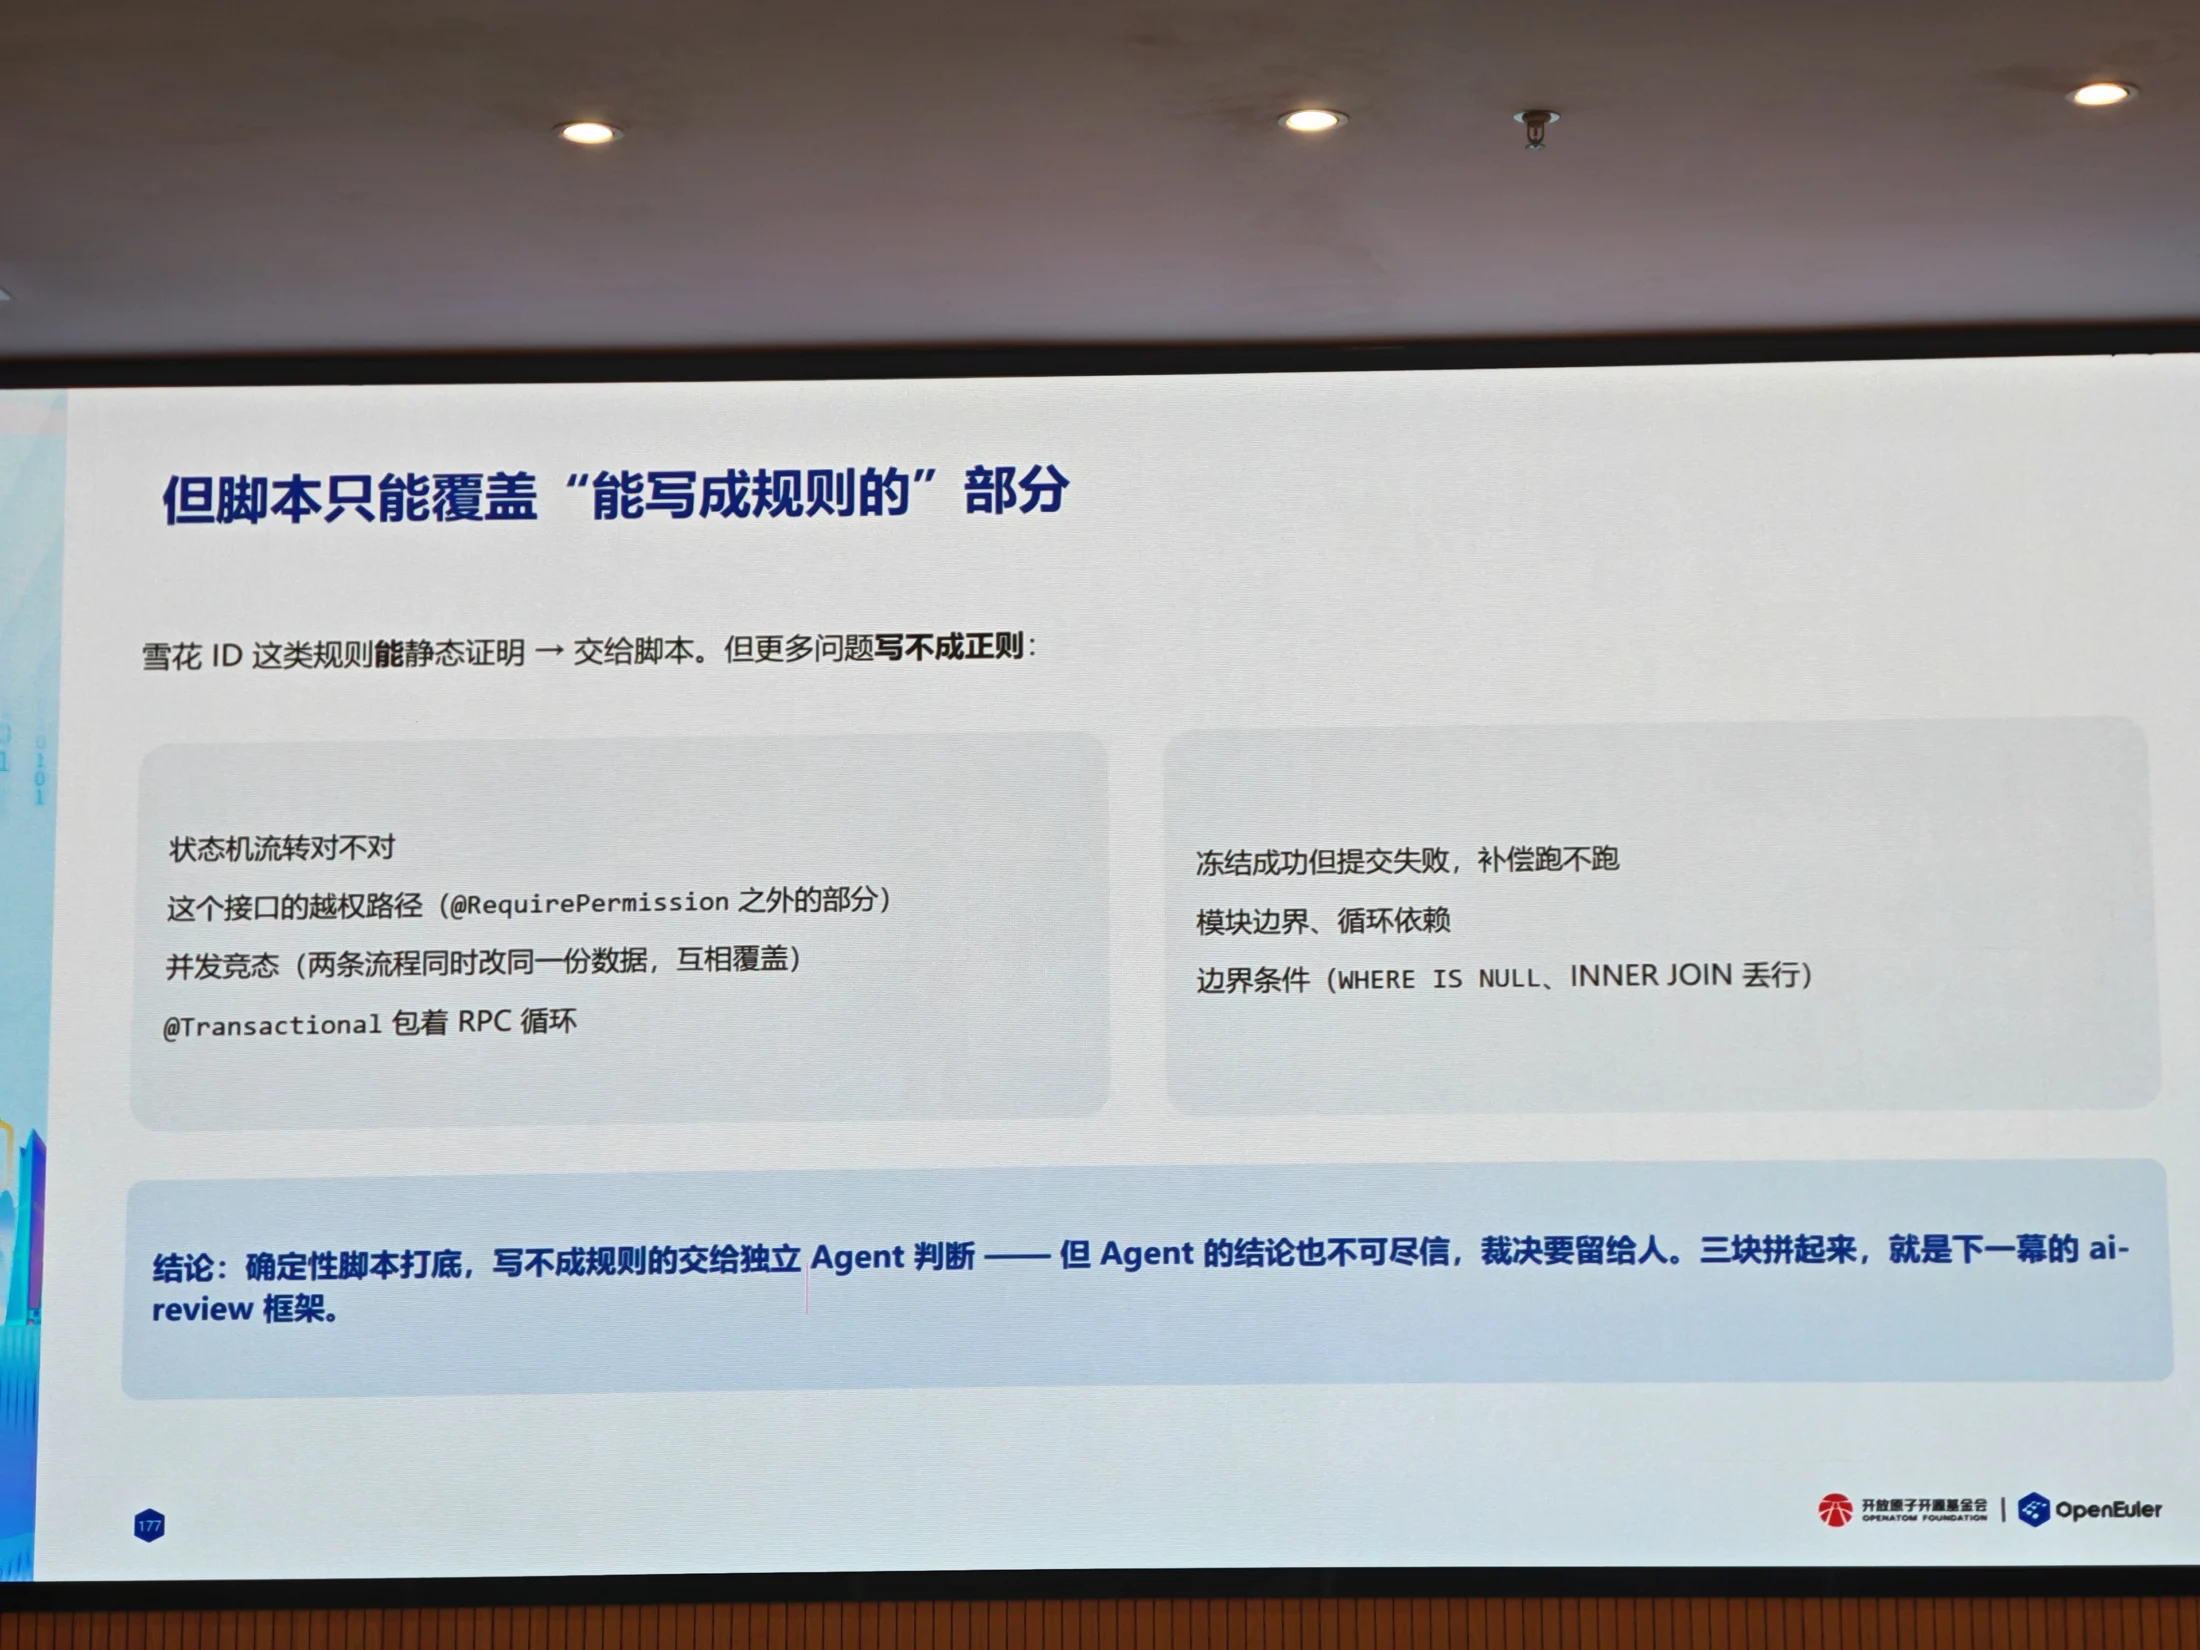
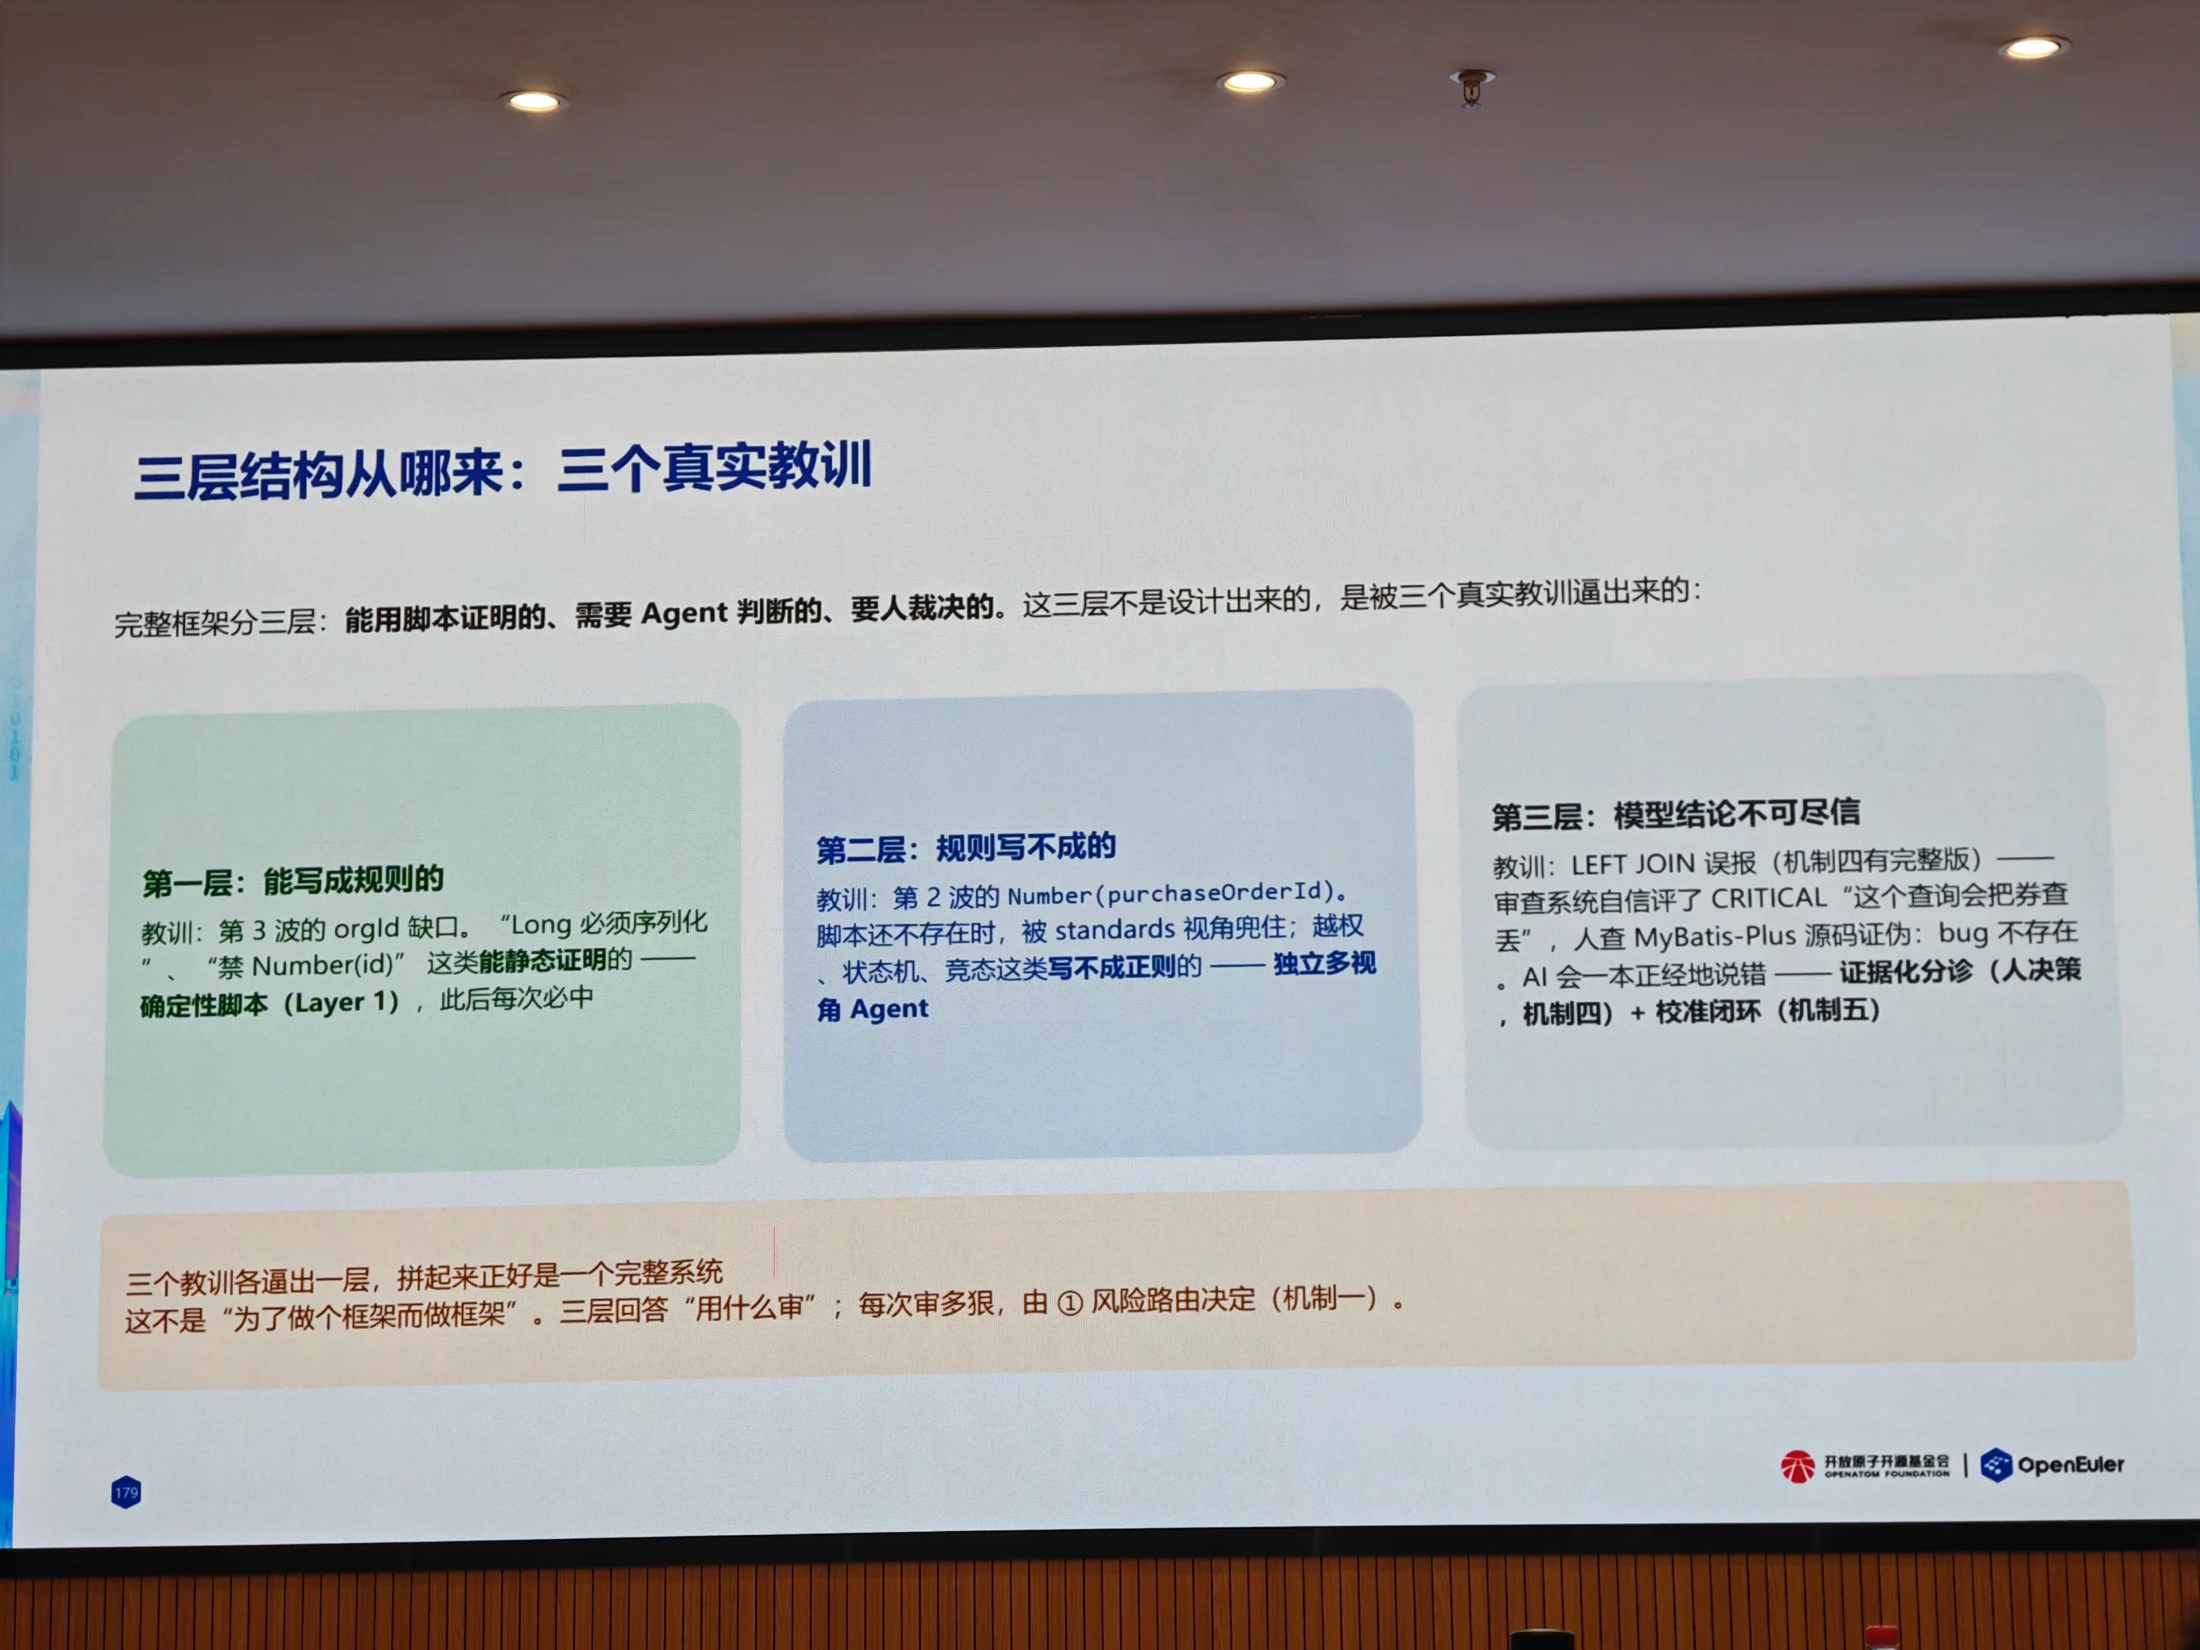
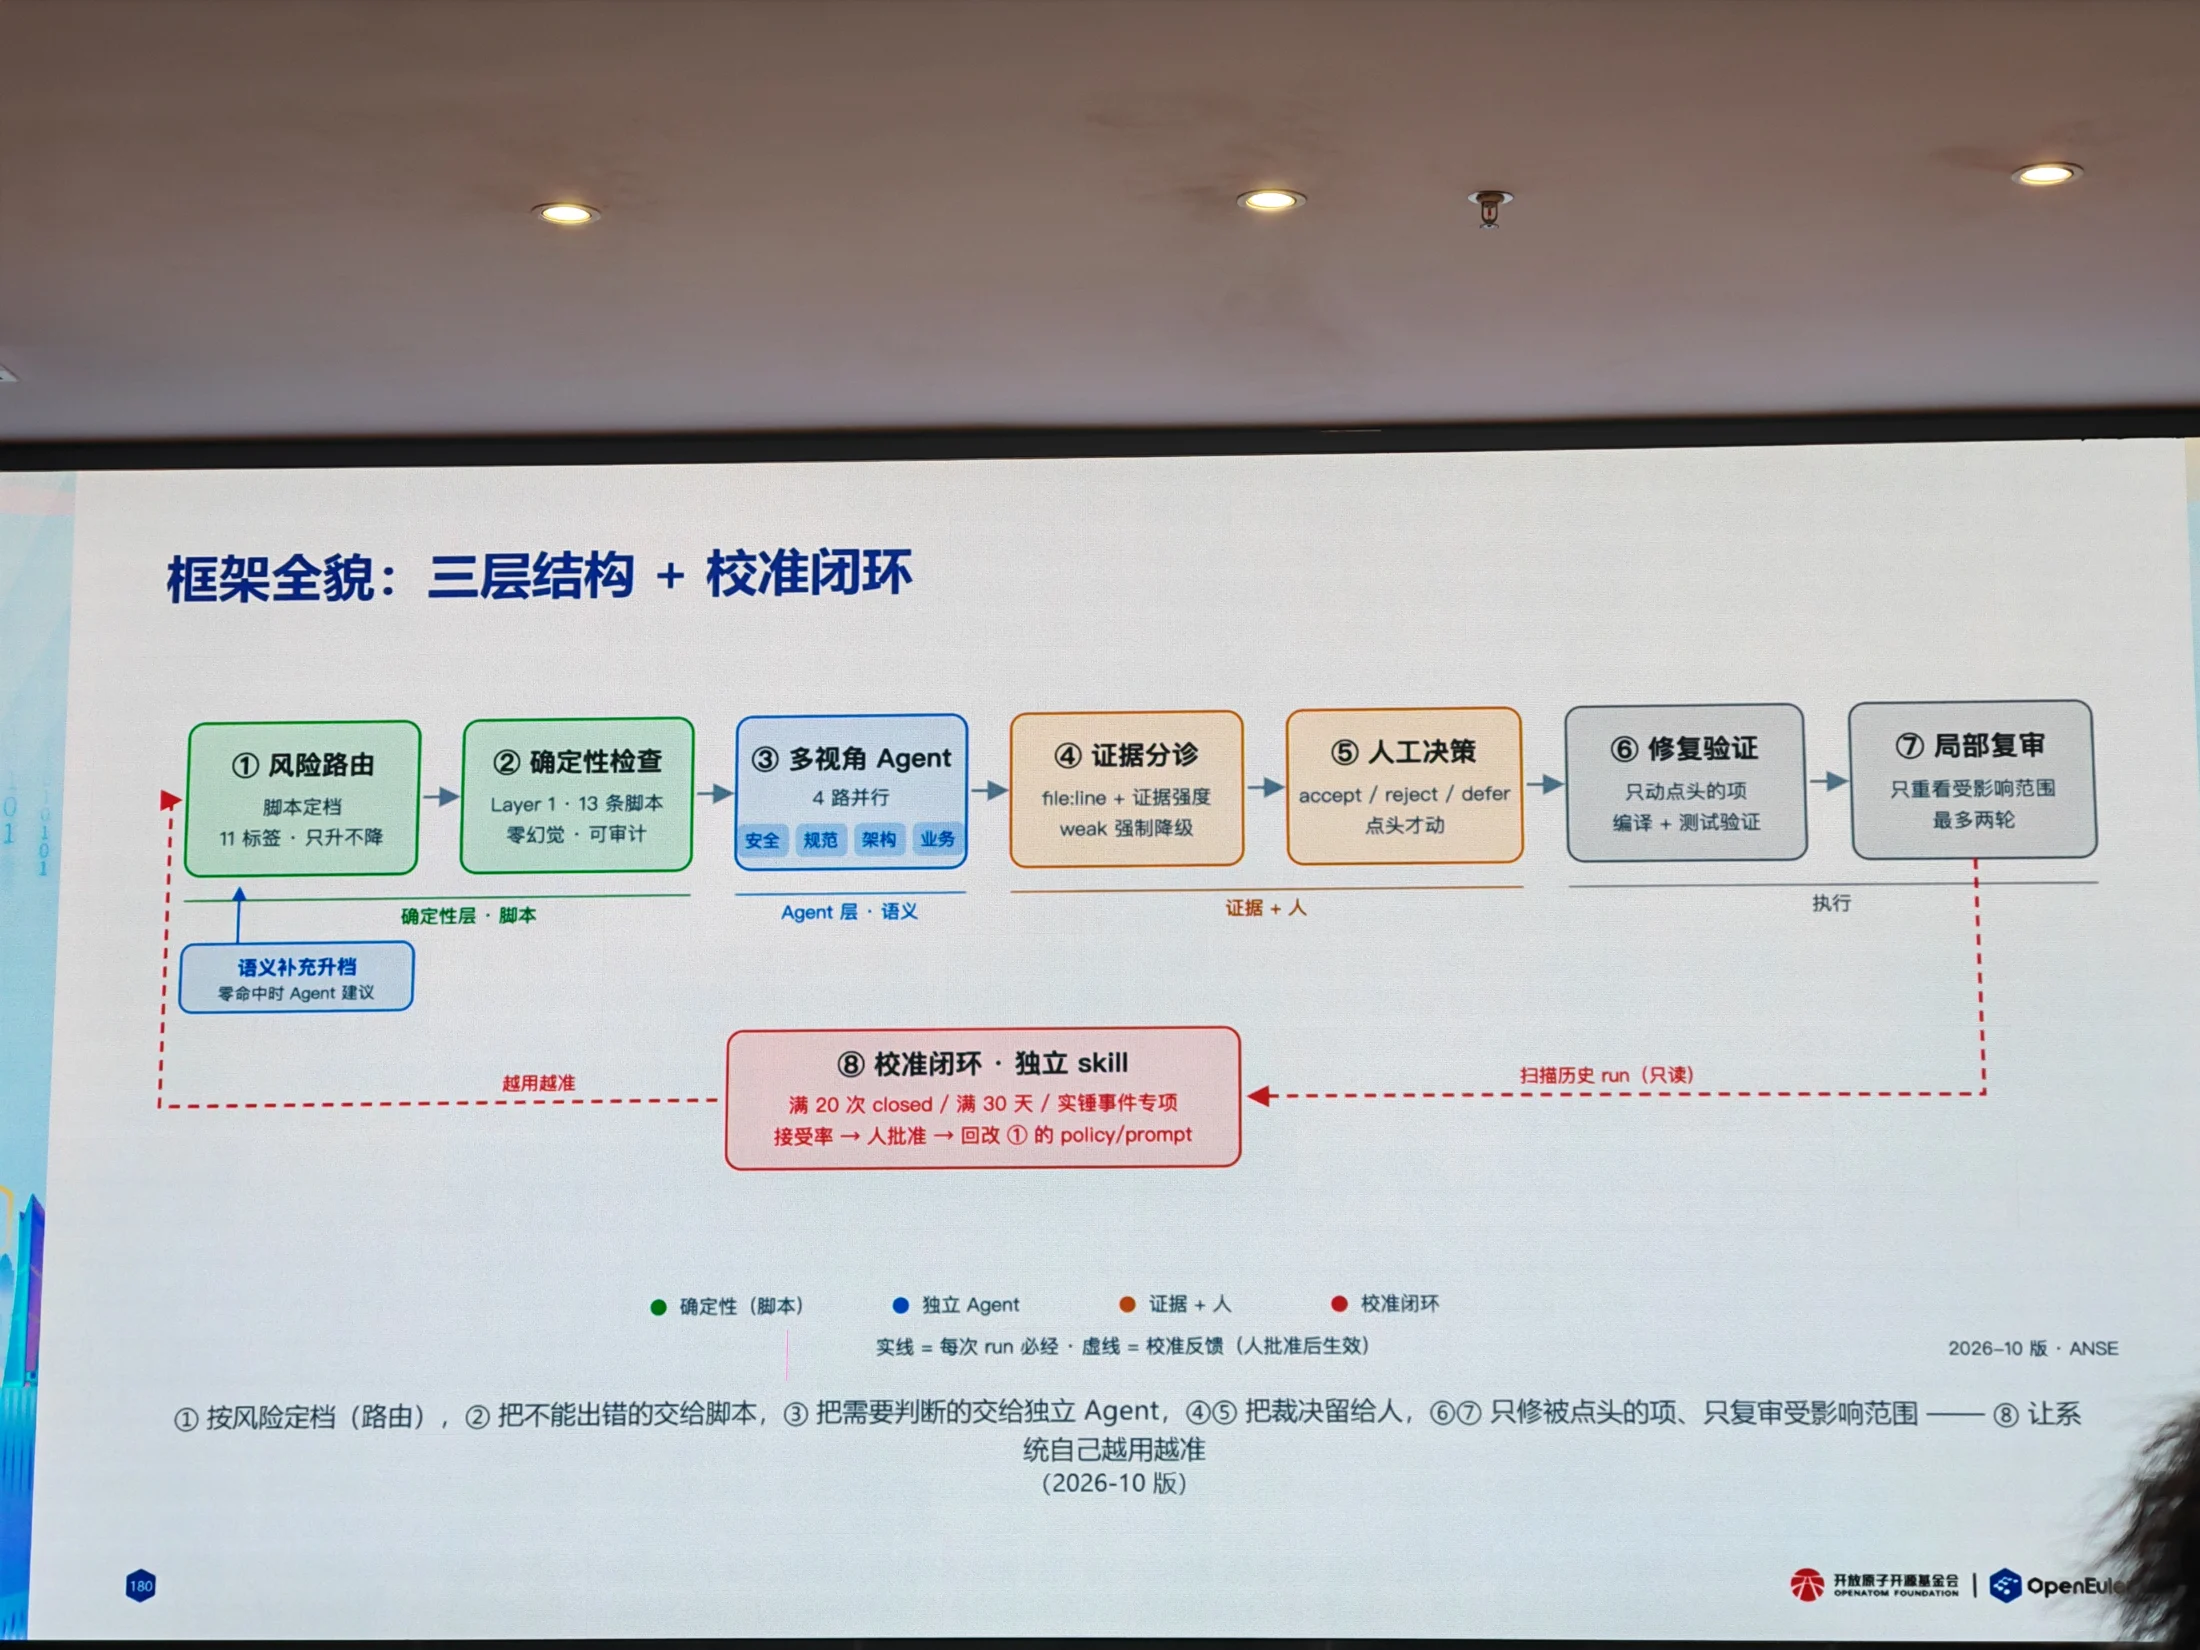
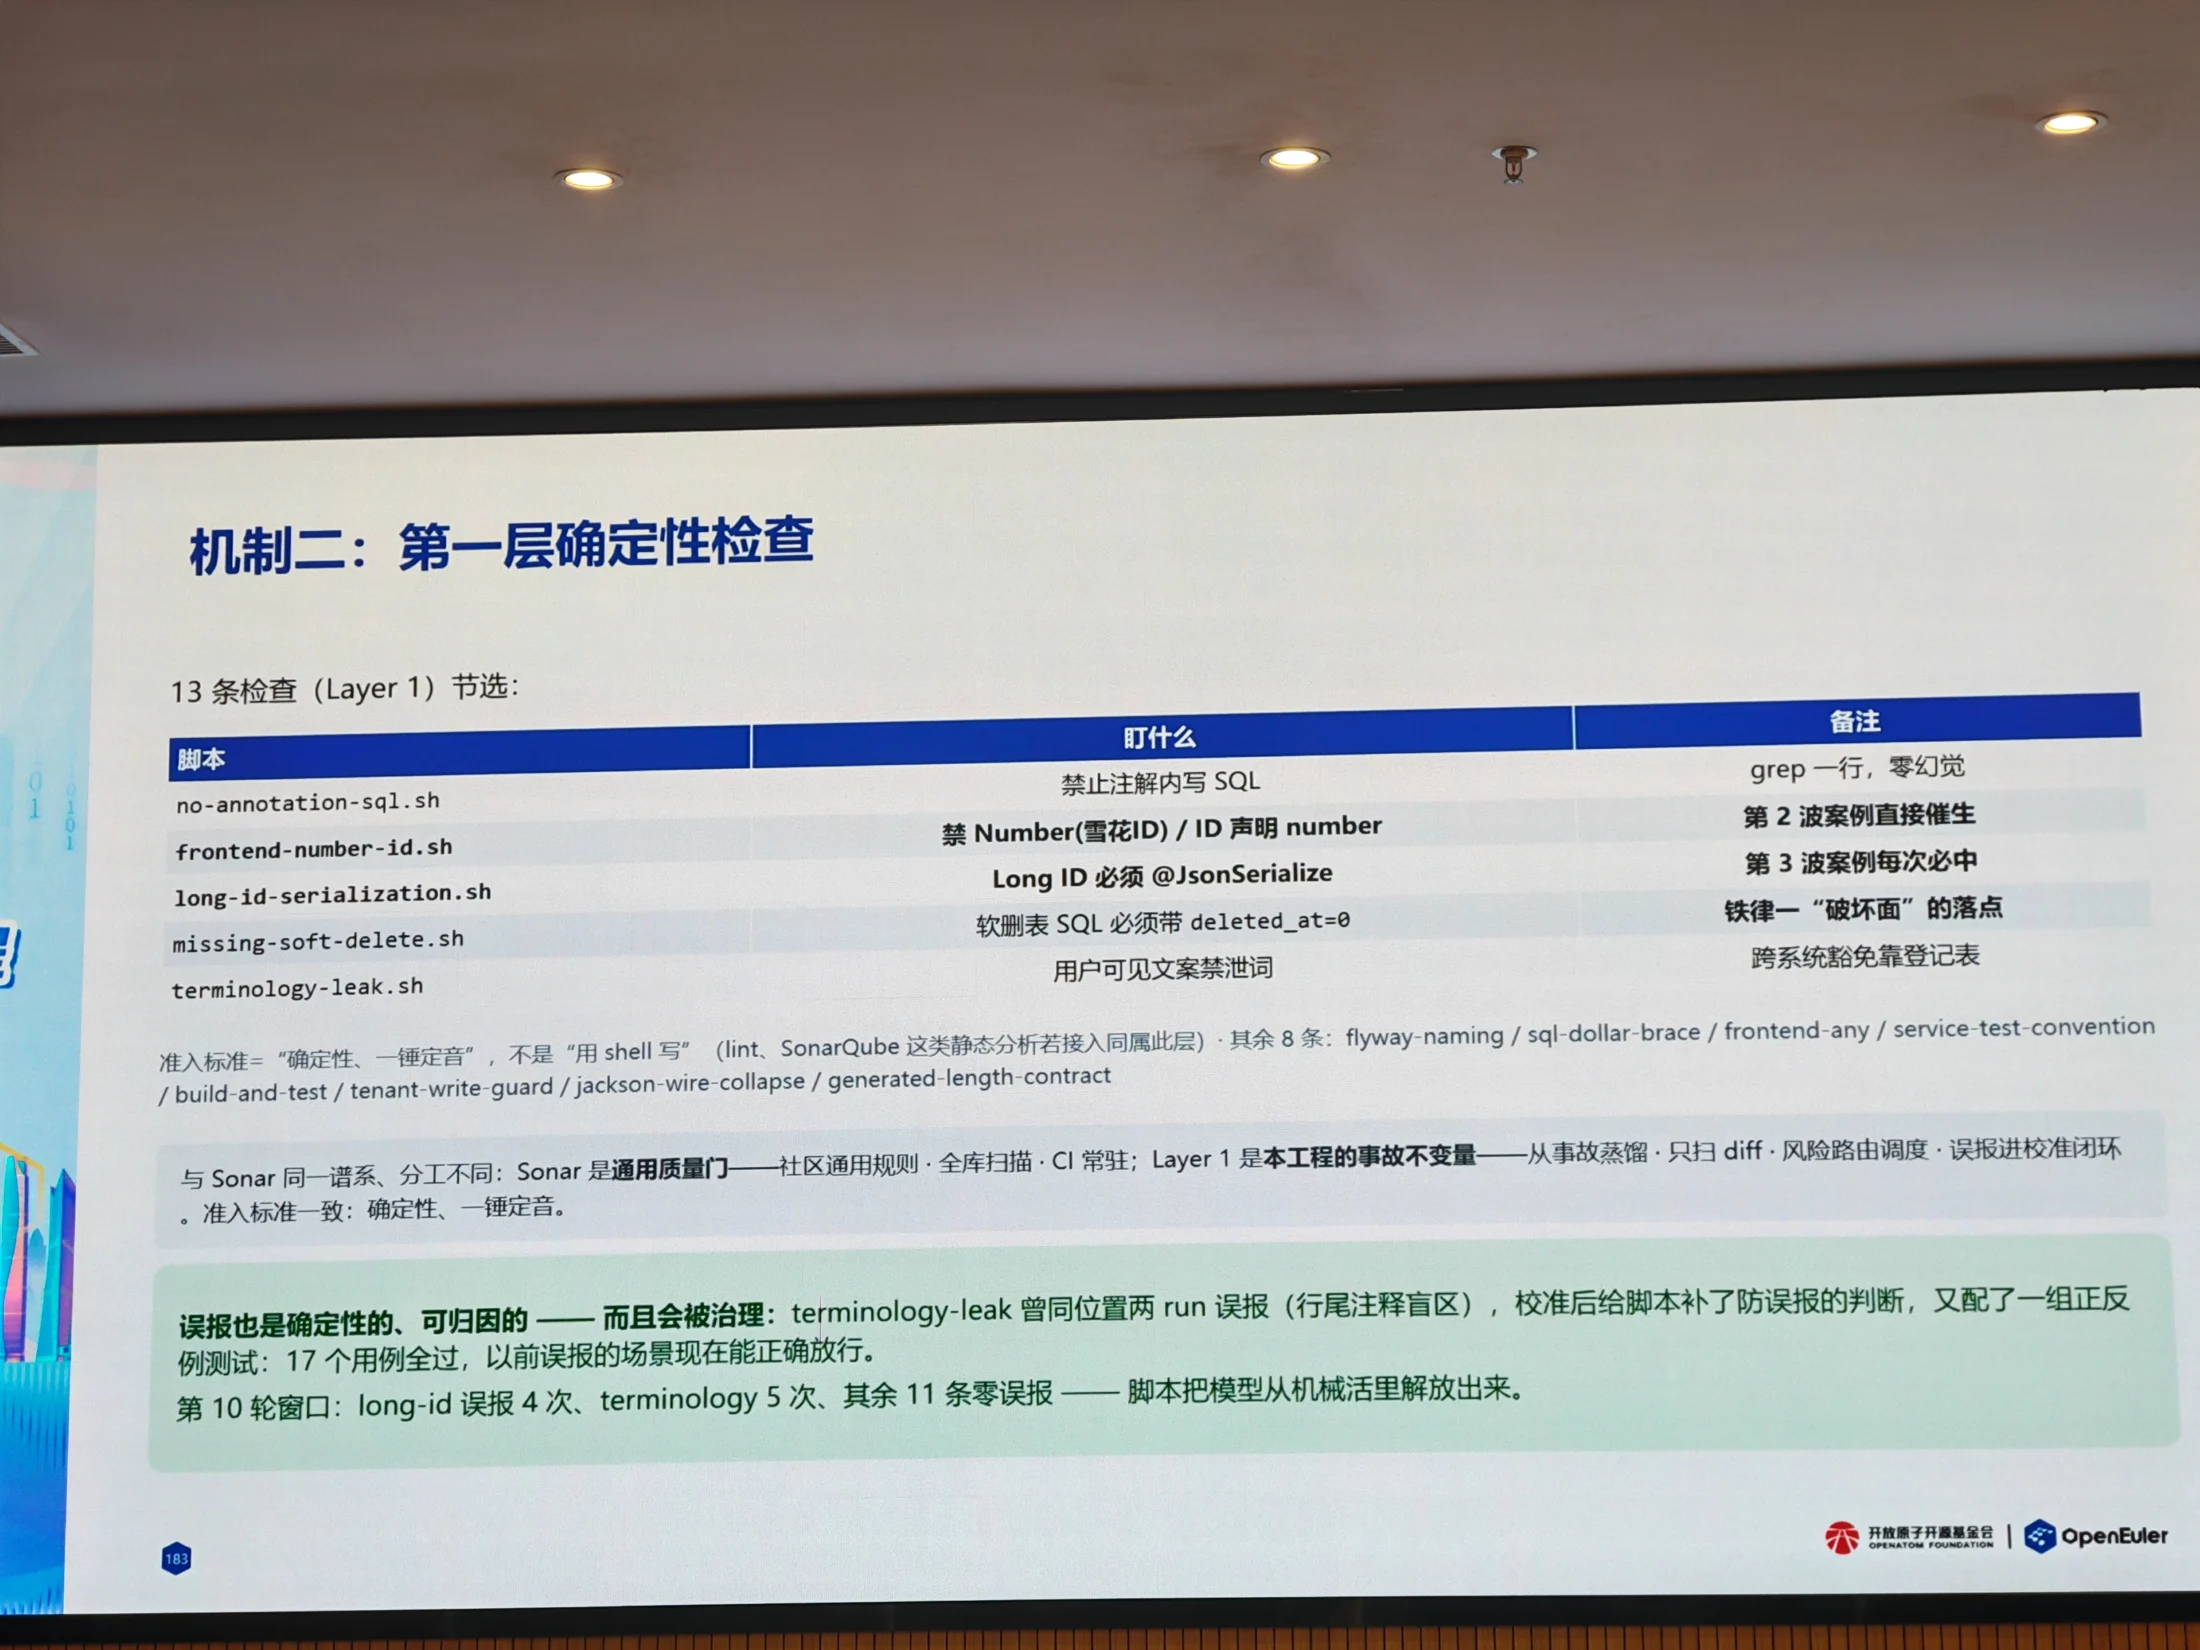
一个雪花 ID 精度问题反复出现:写进规则仍会被遗漏,独立审查发现后再固化为脚本。由此演进出确定性检查、多视角 Agent、人工决策与校准闭环。

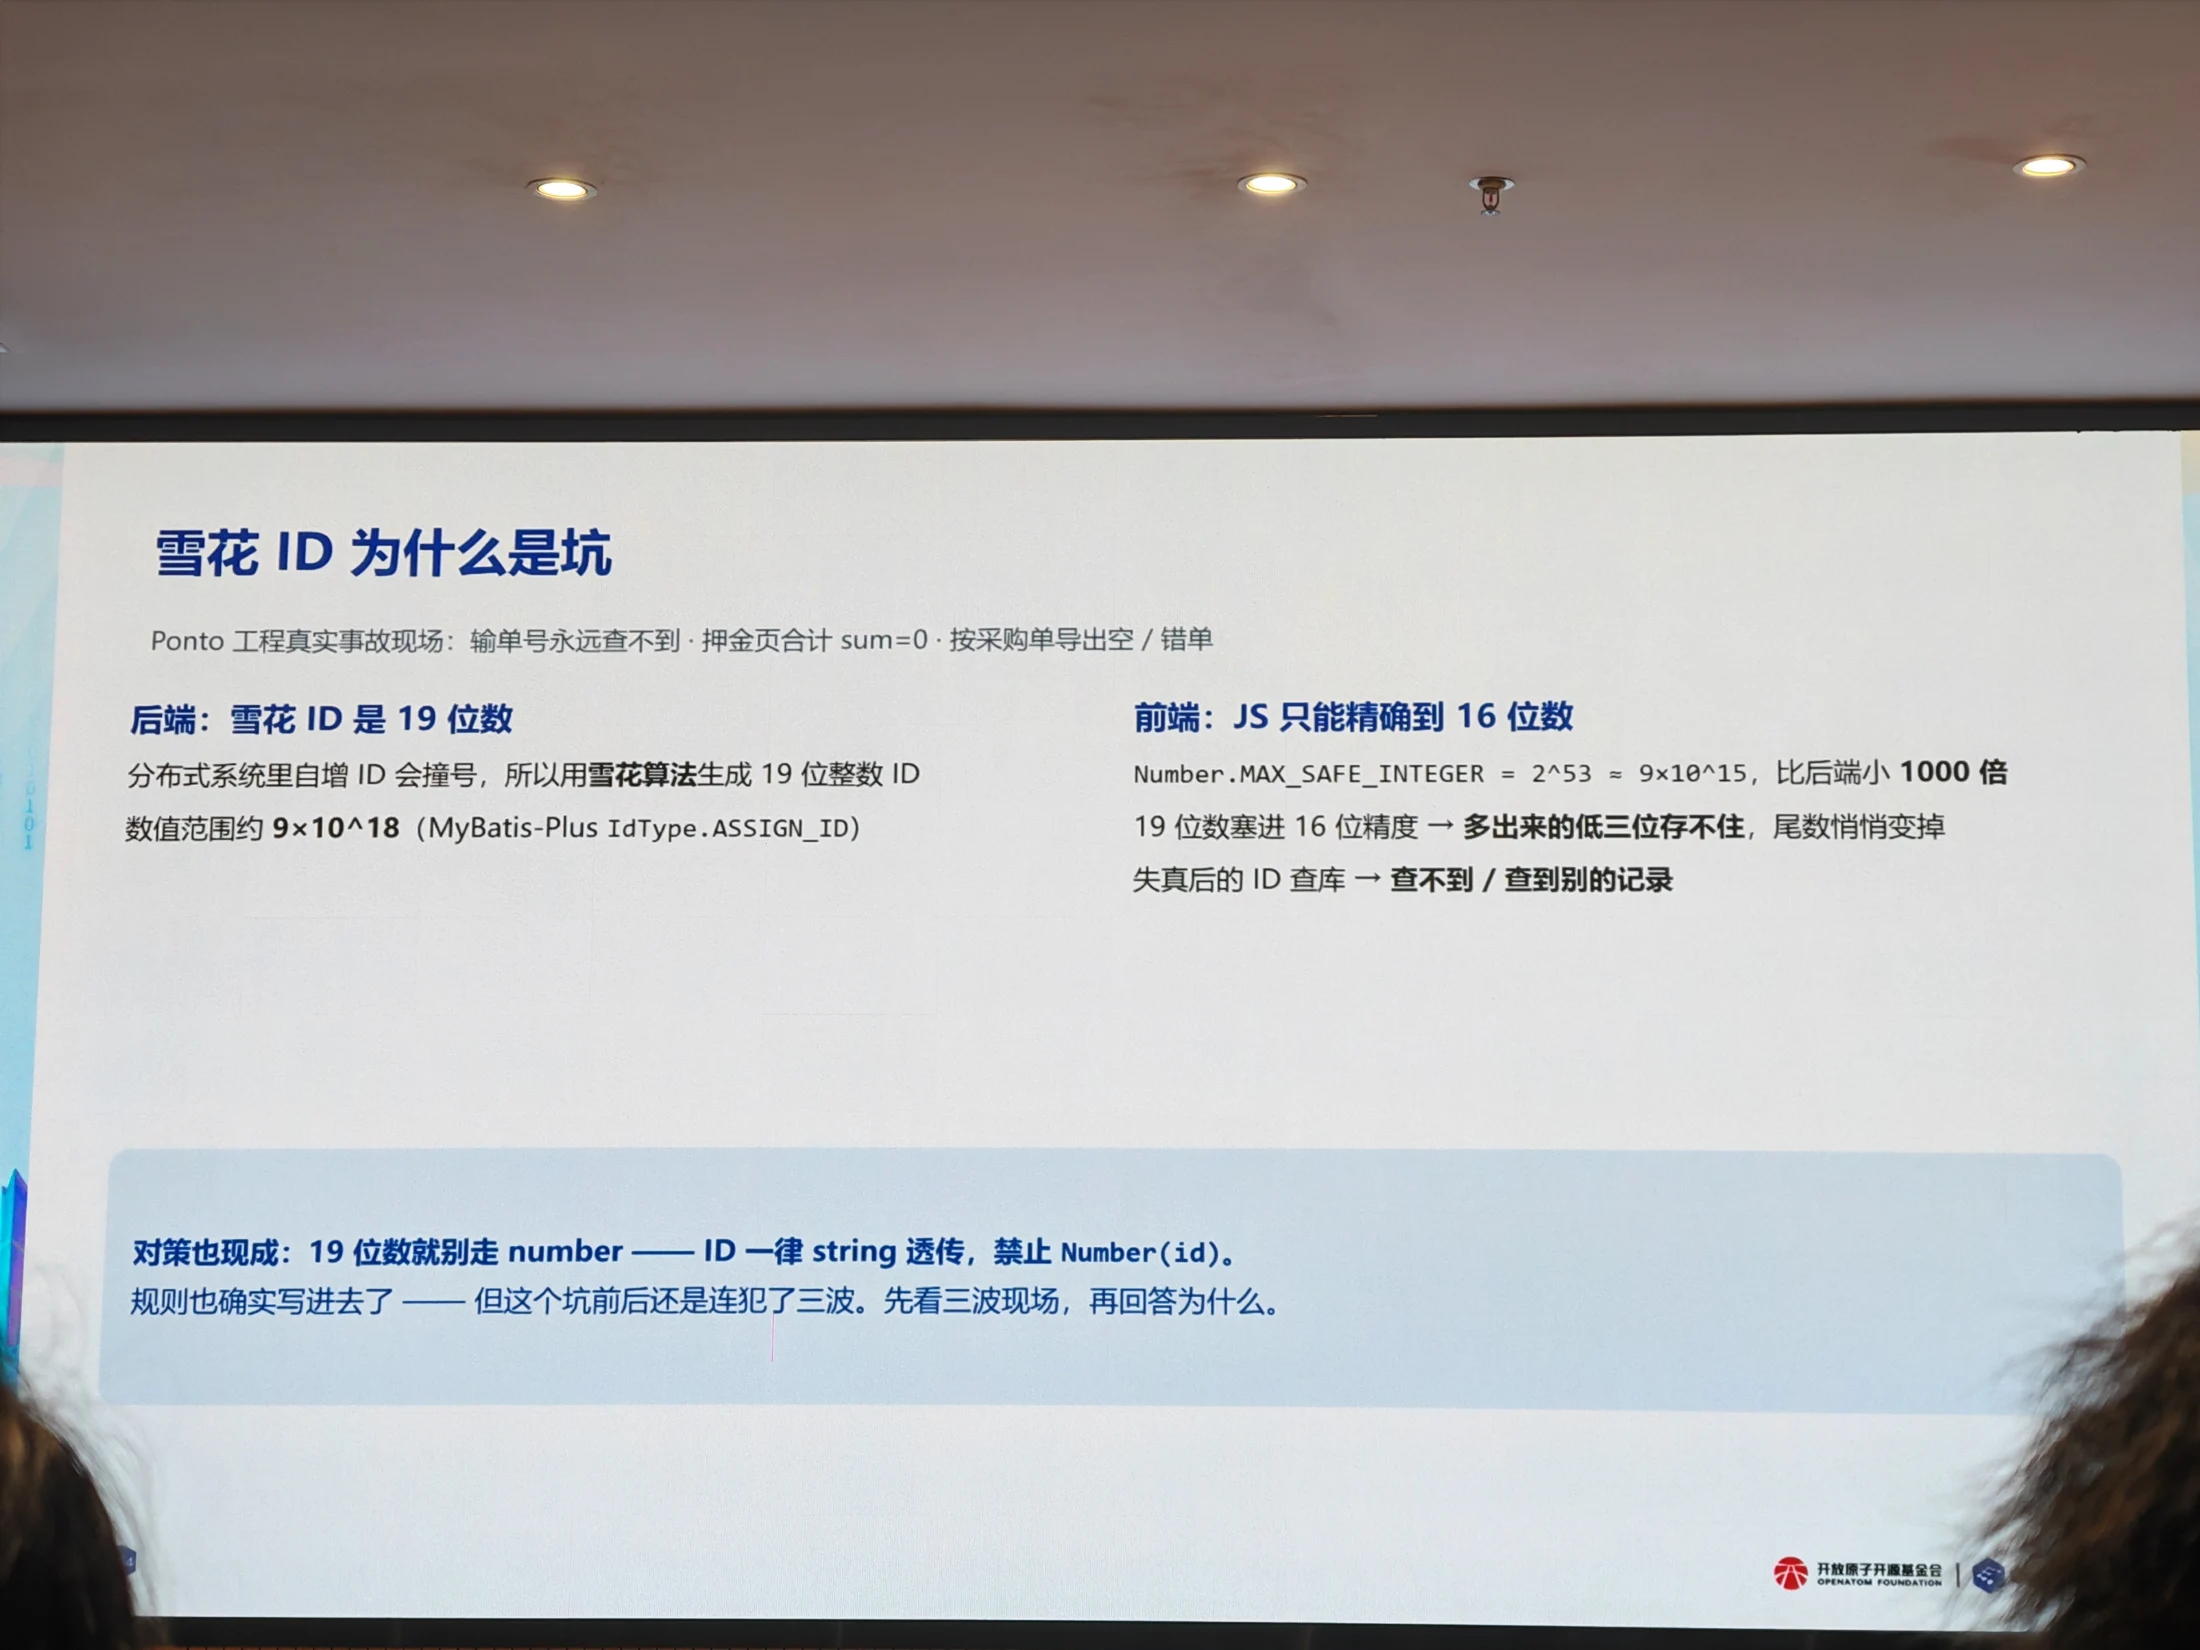
材料边界:“每次抓住”是照片中有限案例的描述,不等于脚本对所有代码 100% 正确。课件的 MAX_SAFE_INTEGER 简写已在本站更正为 2⁵³−1。

雪花 ID 的三波 bug

前端把长 ID 转成 Number,造成查询与导出异常;规则文件已要求 ID 以字符串流转,但后续新代码仍出现相同错误。独立审查发现问题后,把检查固化成脚本,后续再抓到后端 Long 序列化遗漏。

查看照片 IMG_20261031_164216.jpg

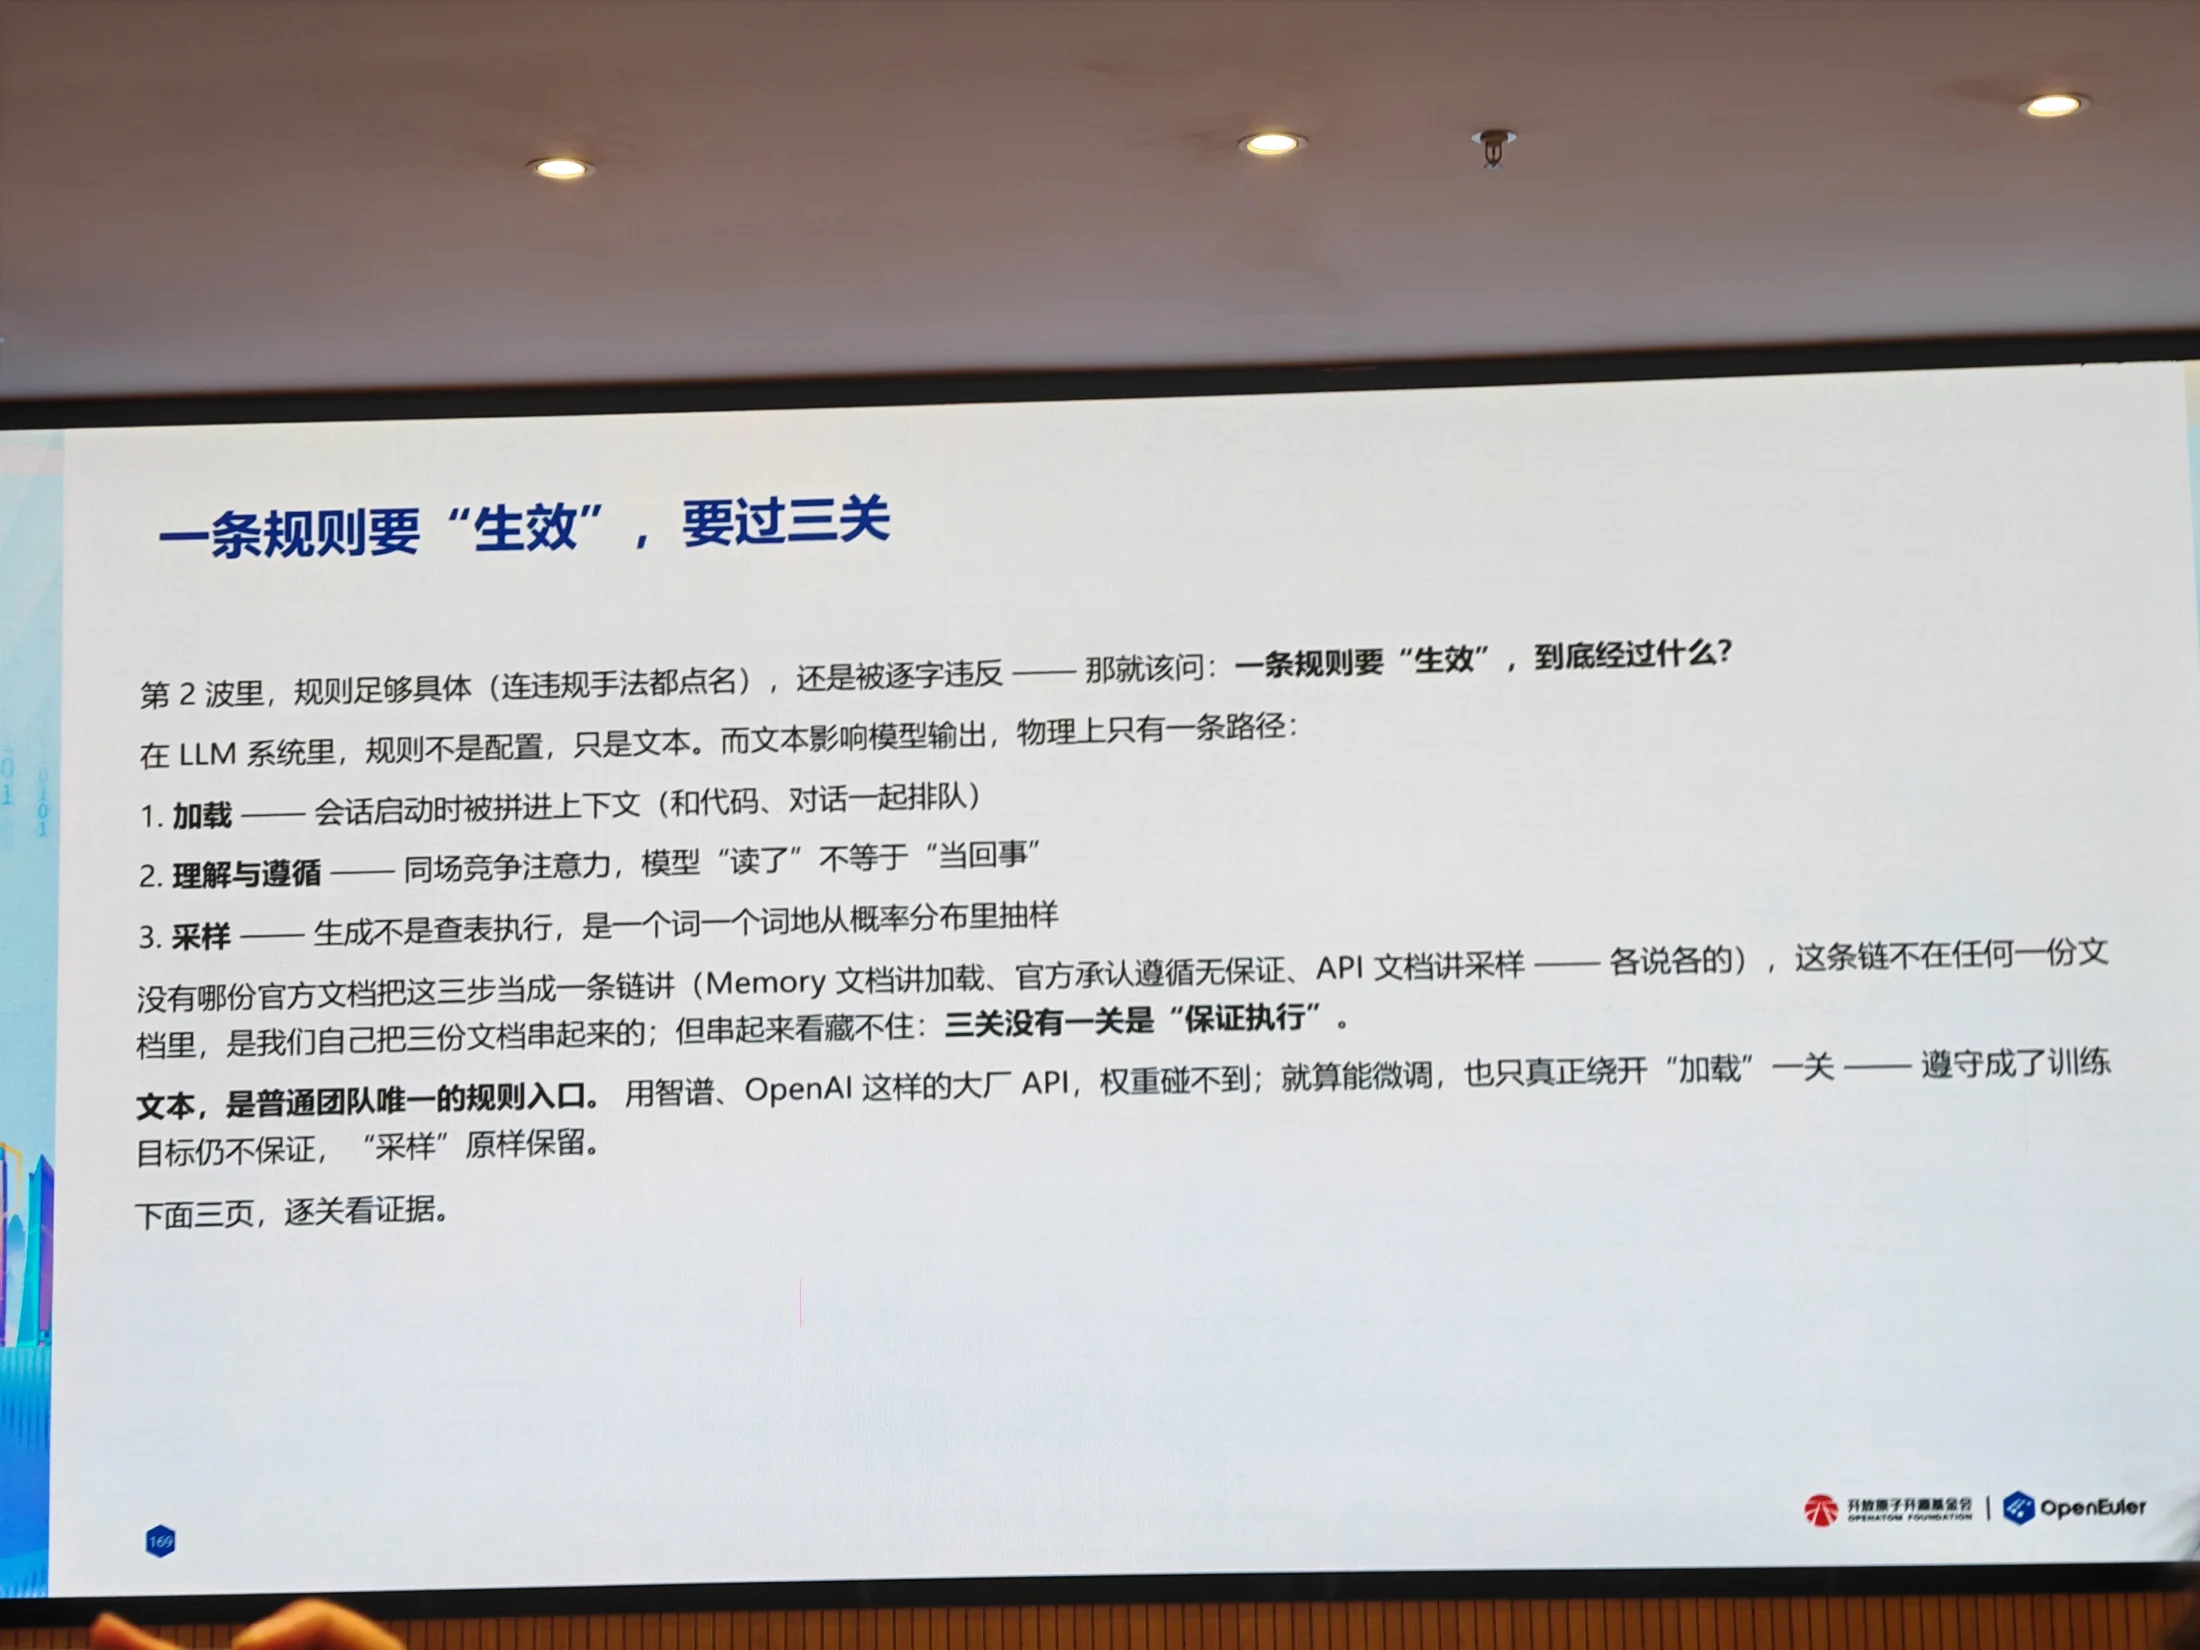
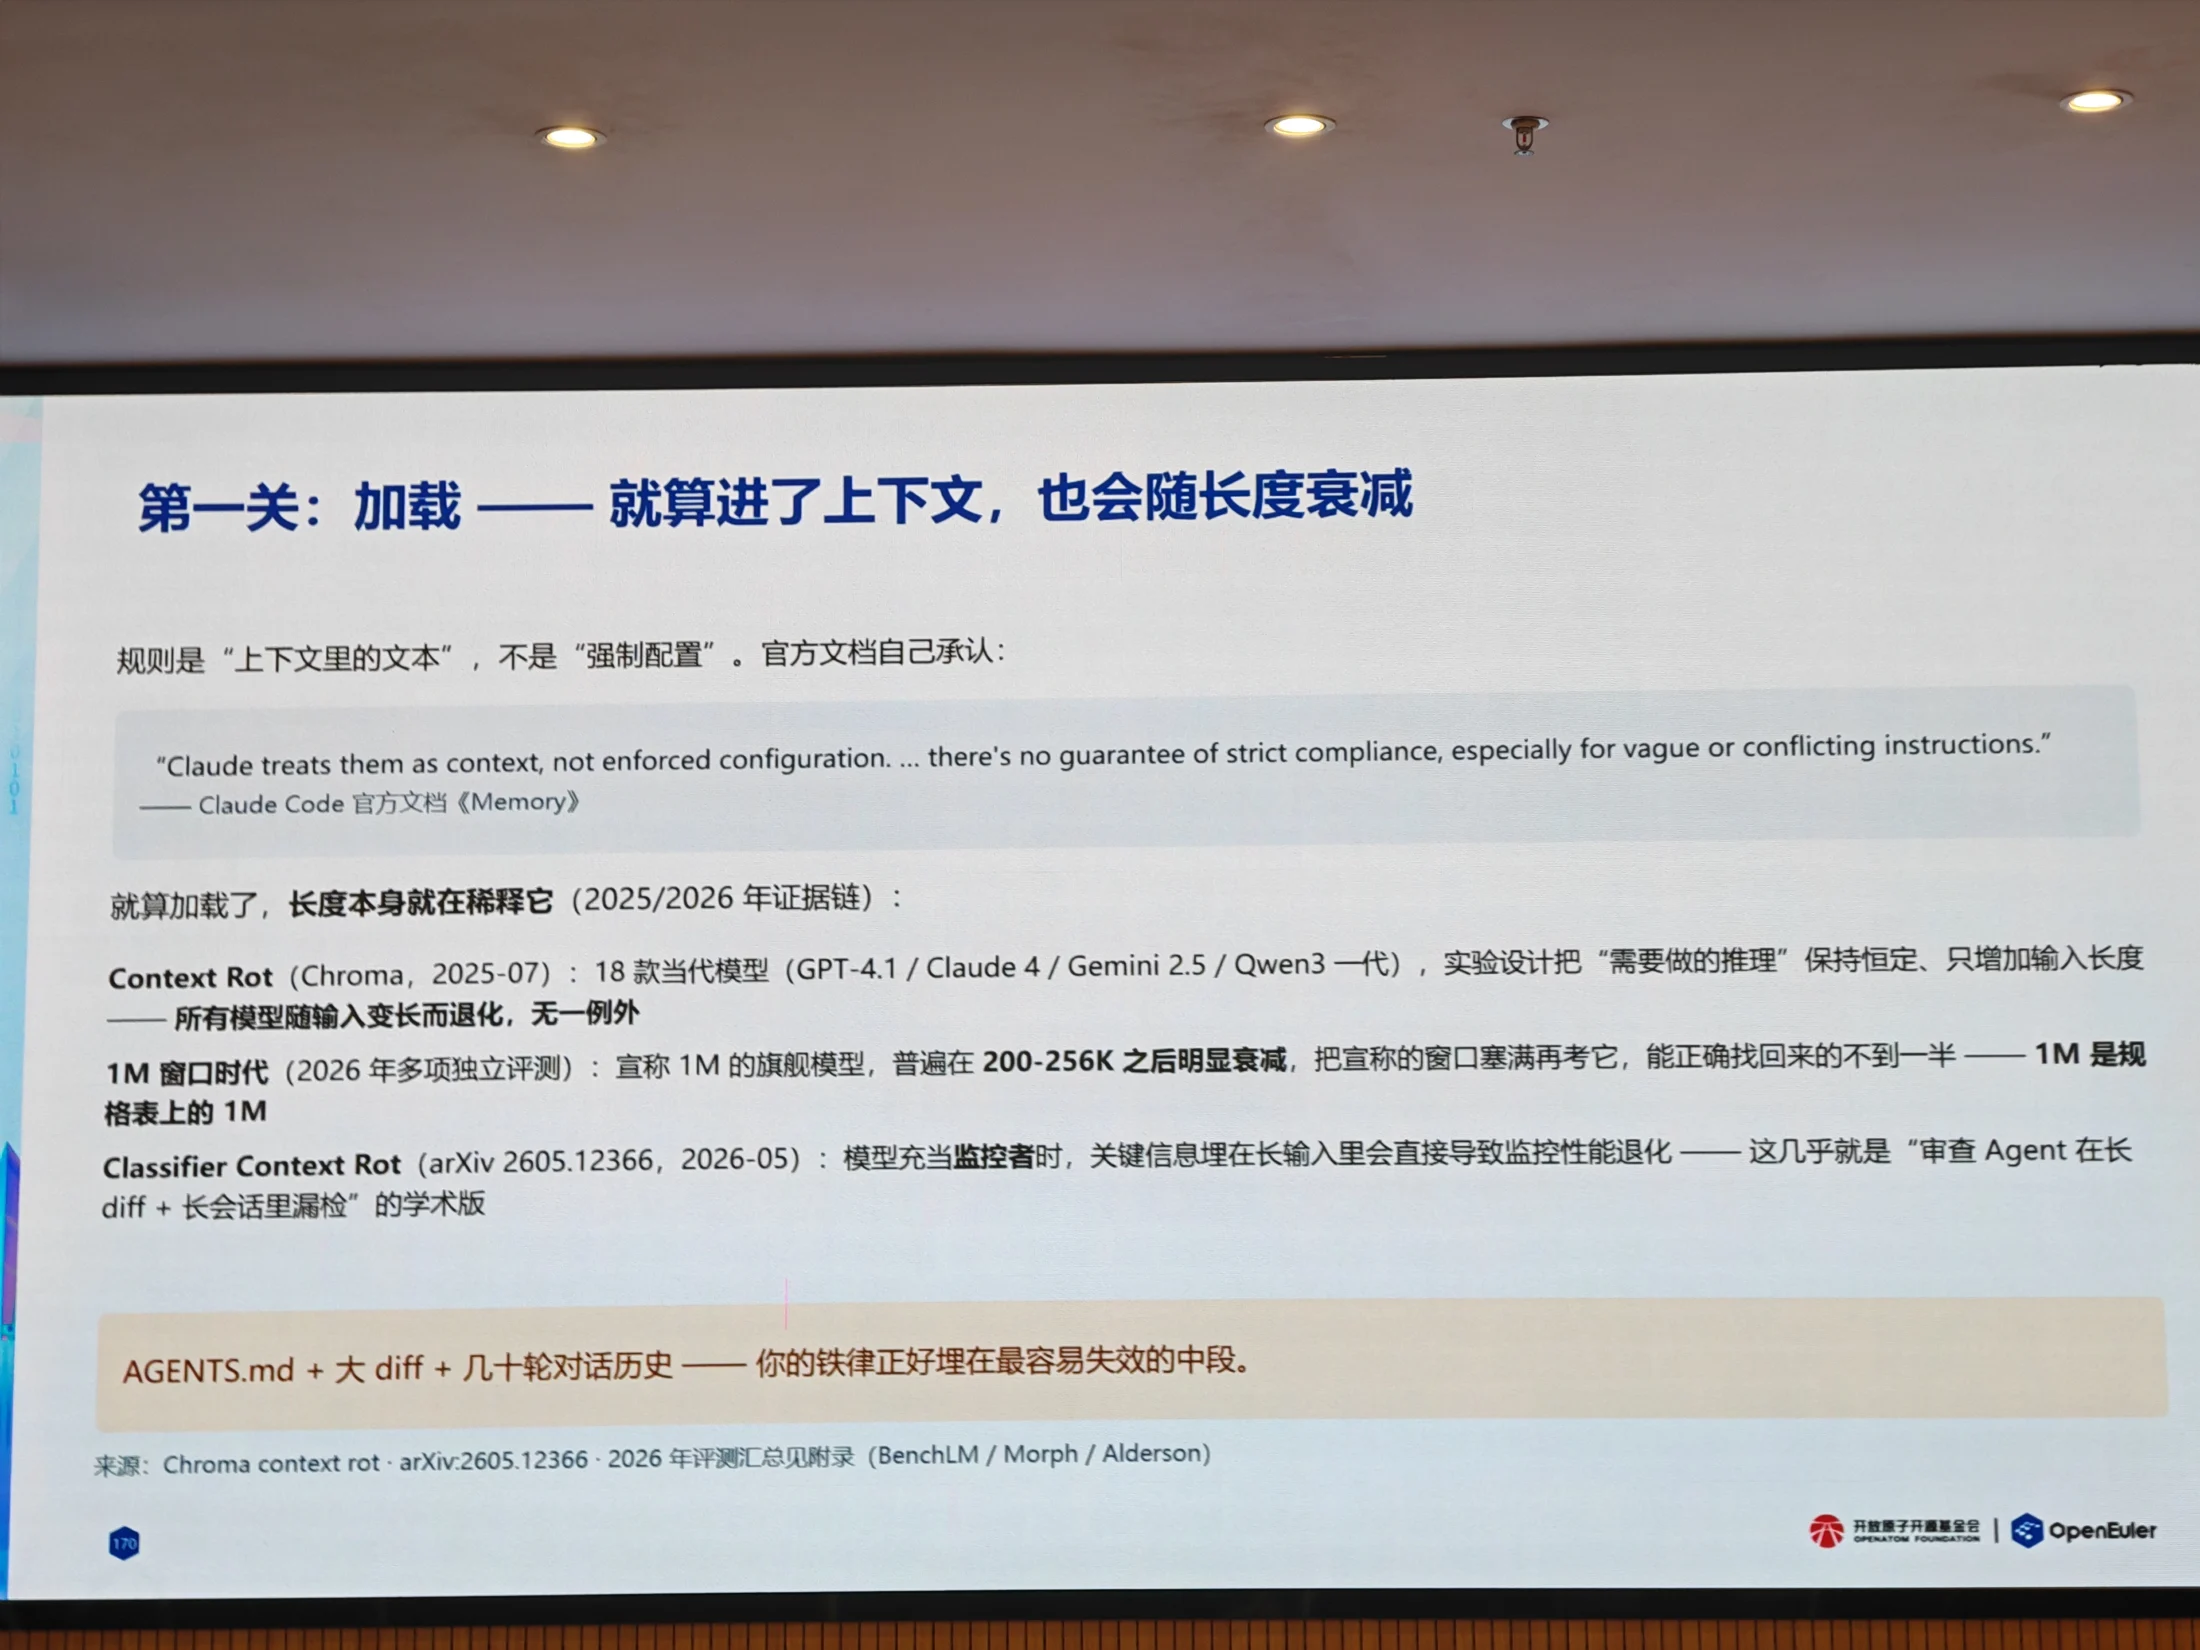
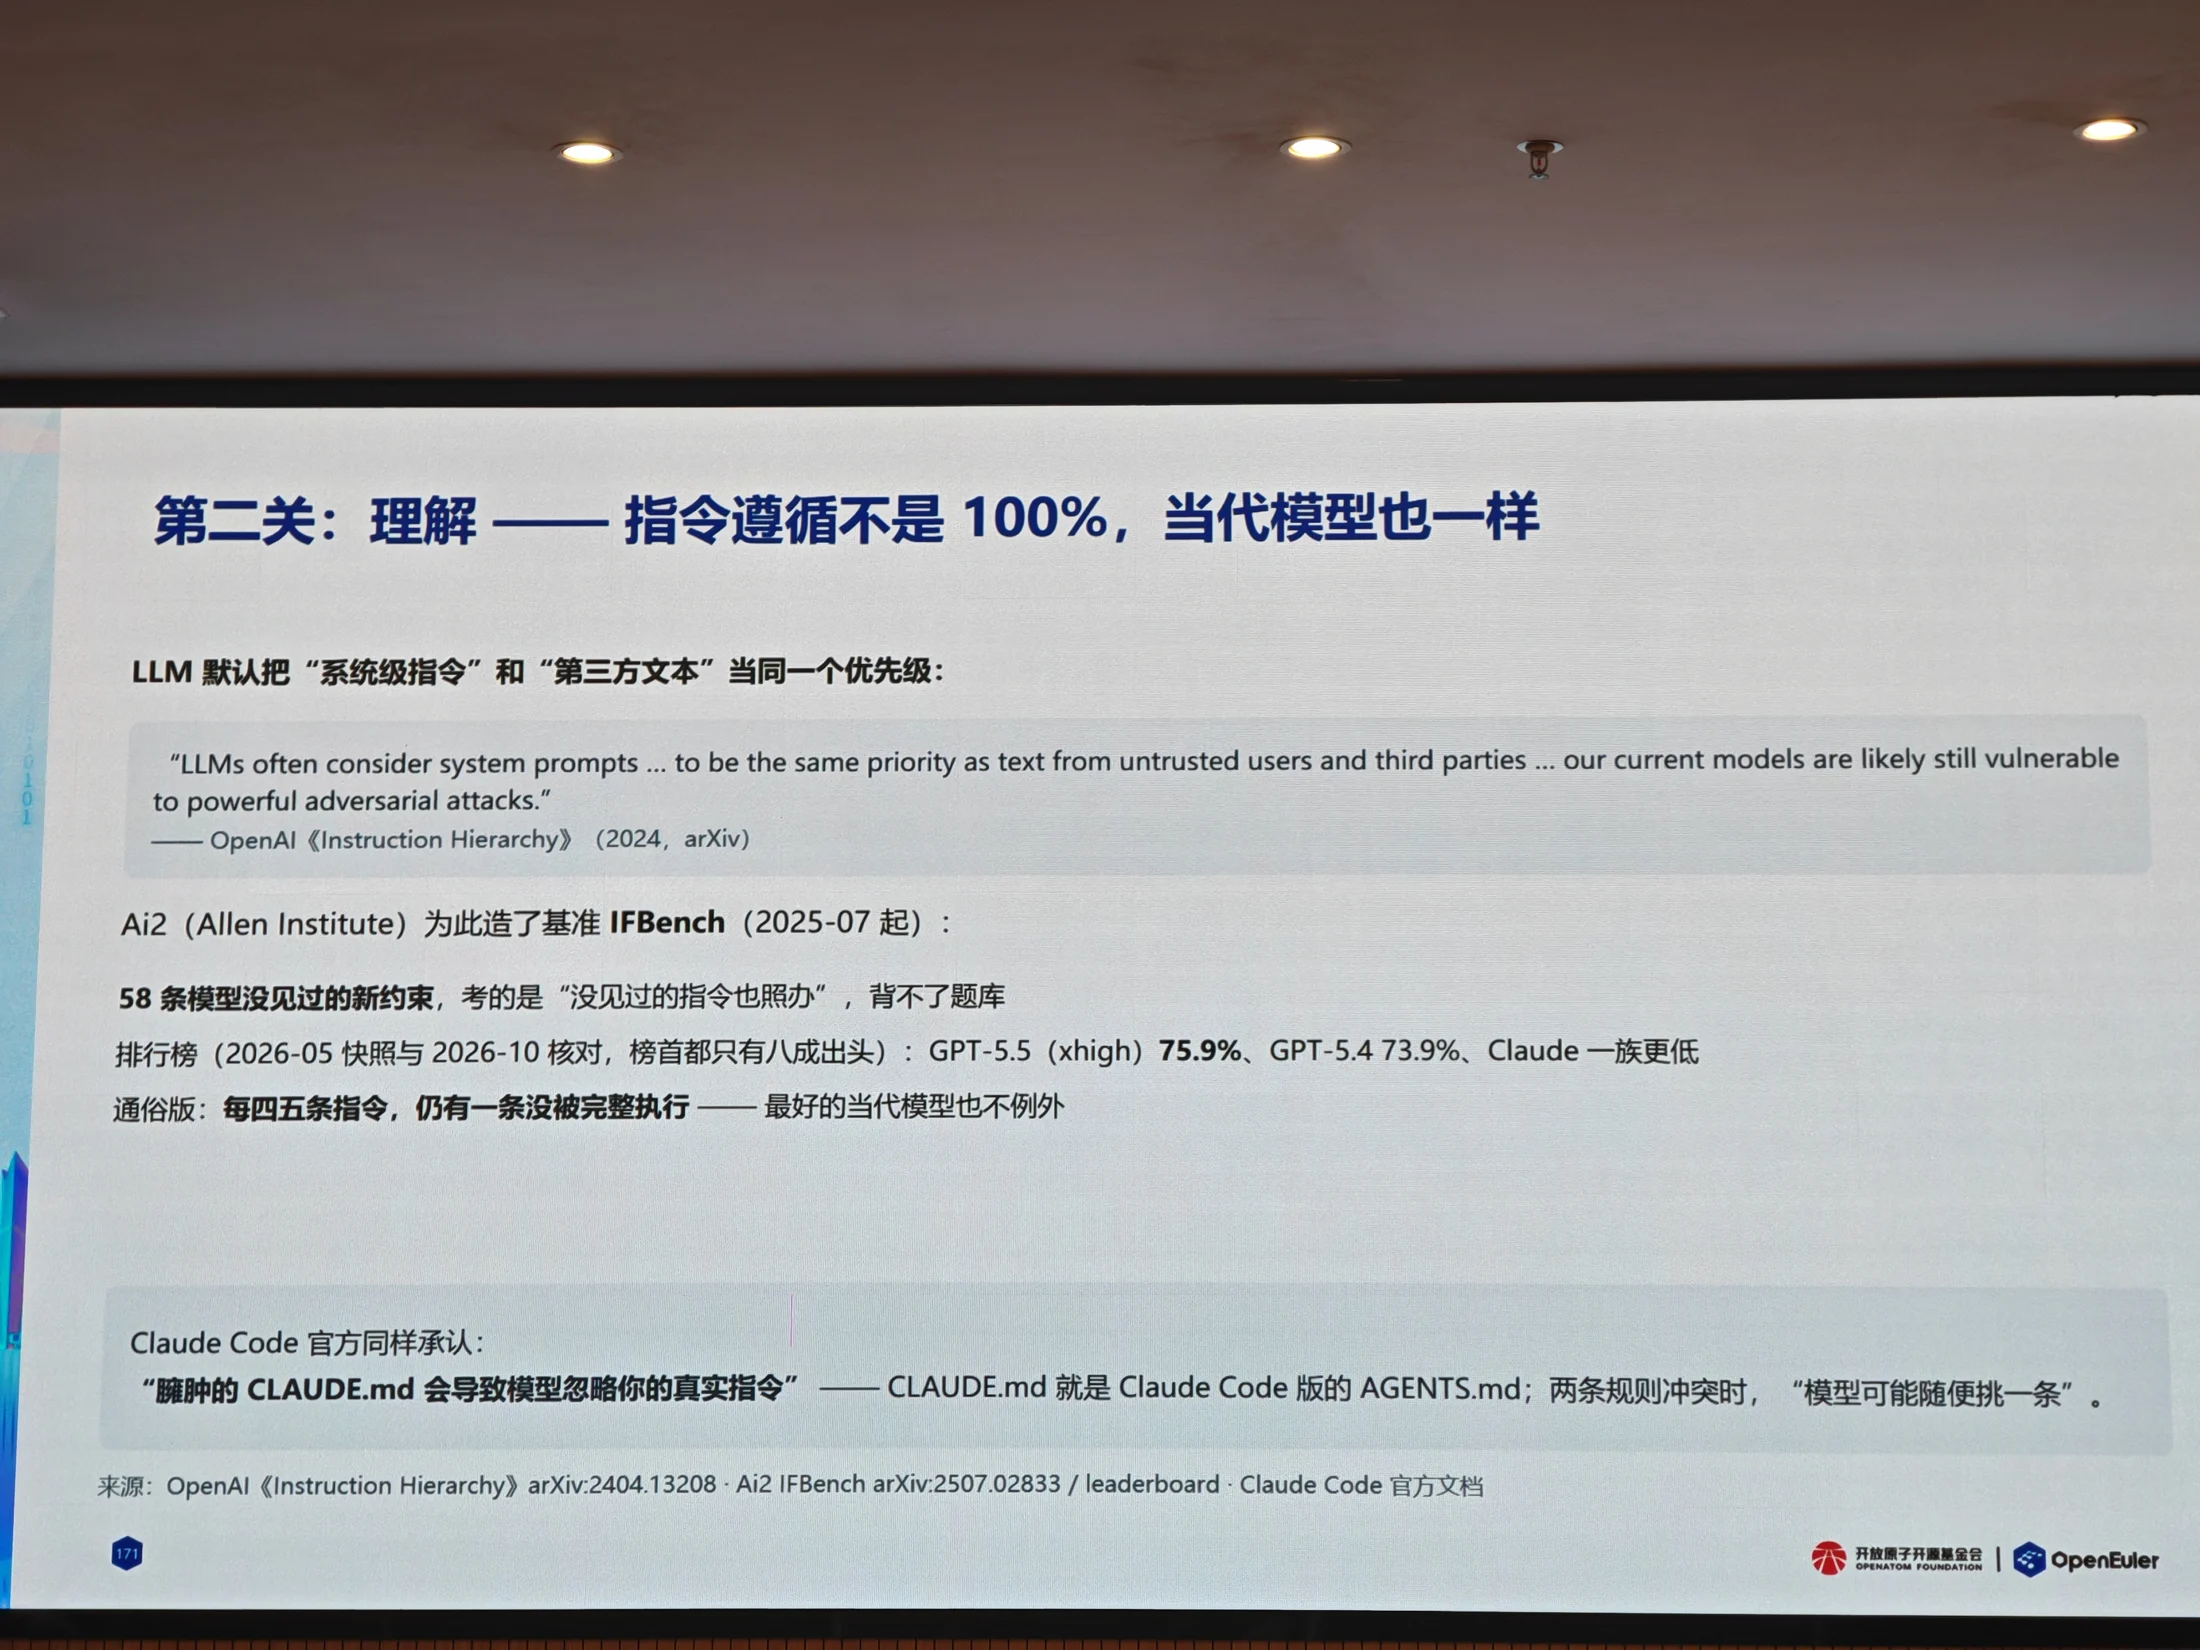
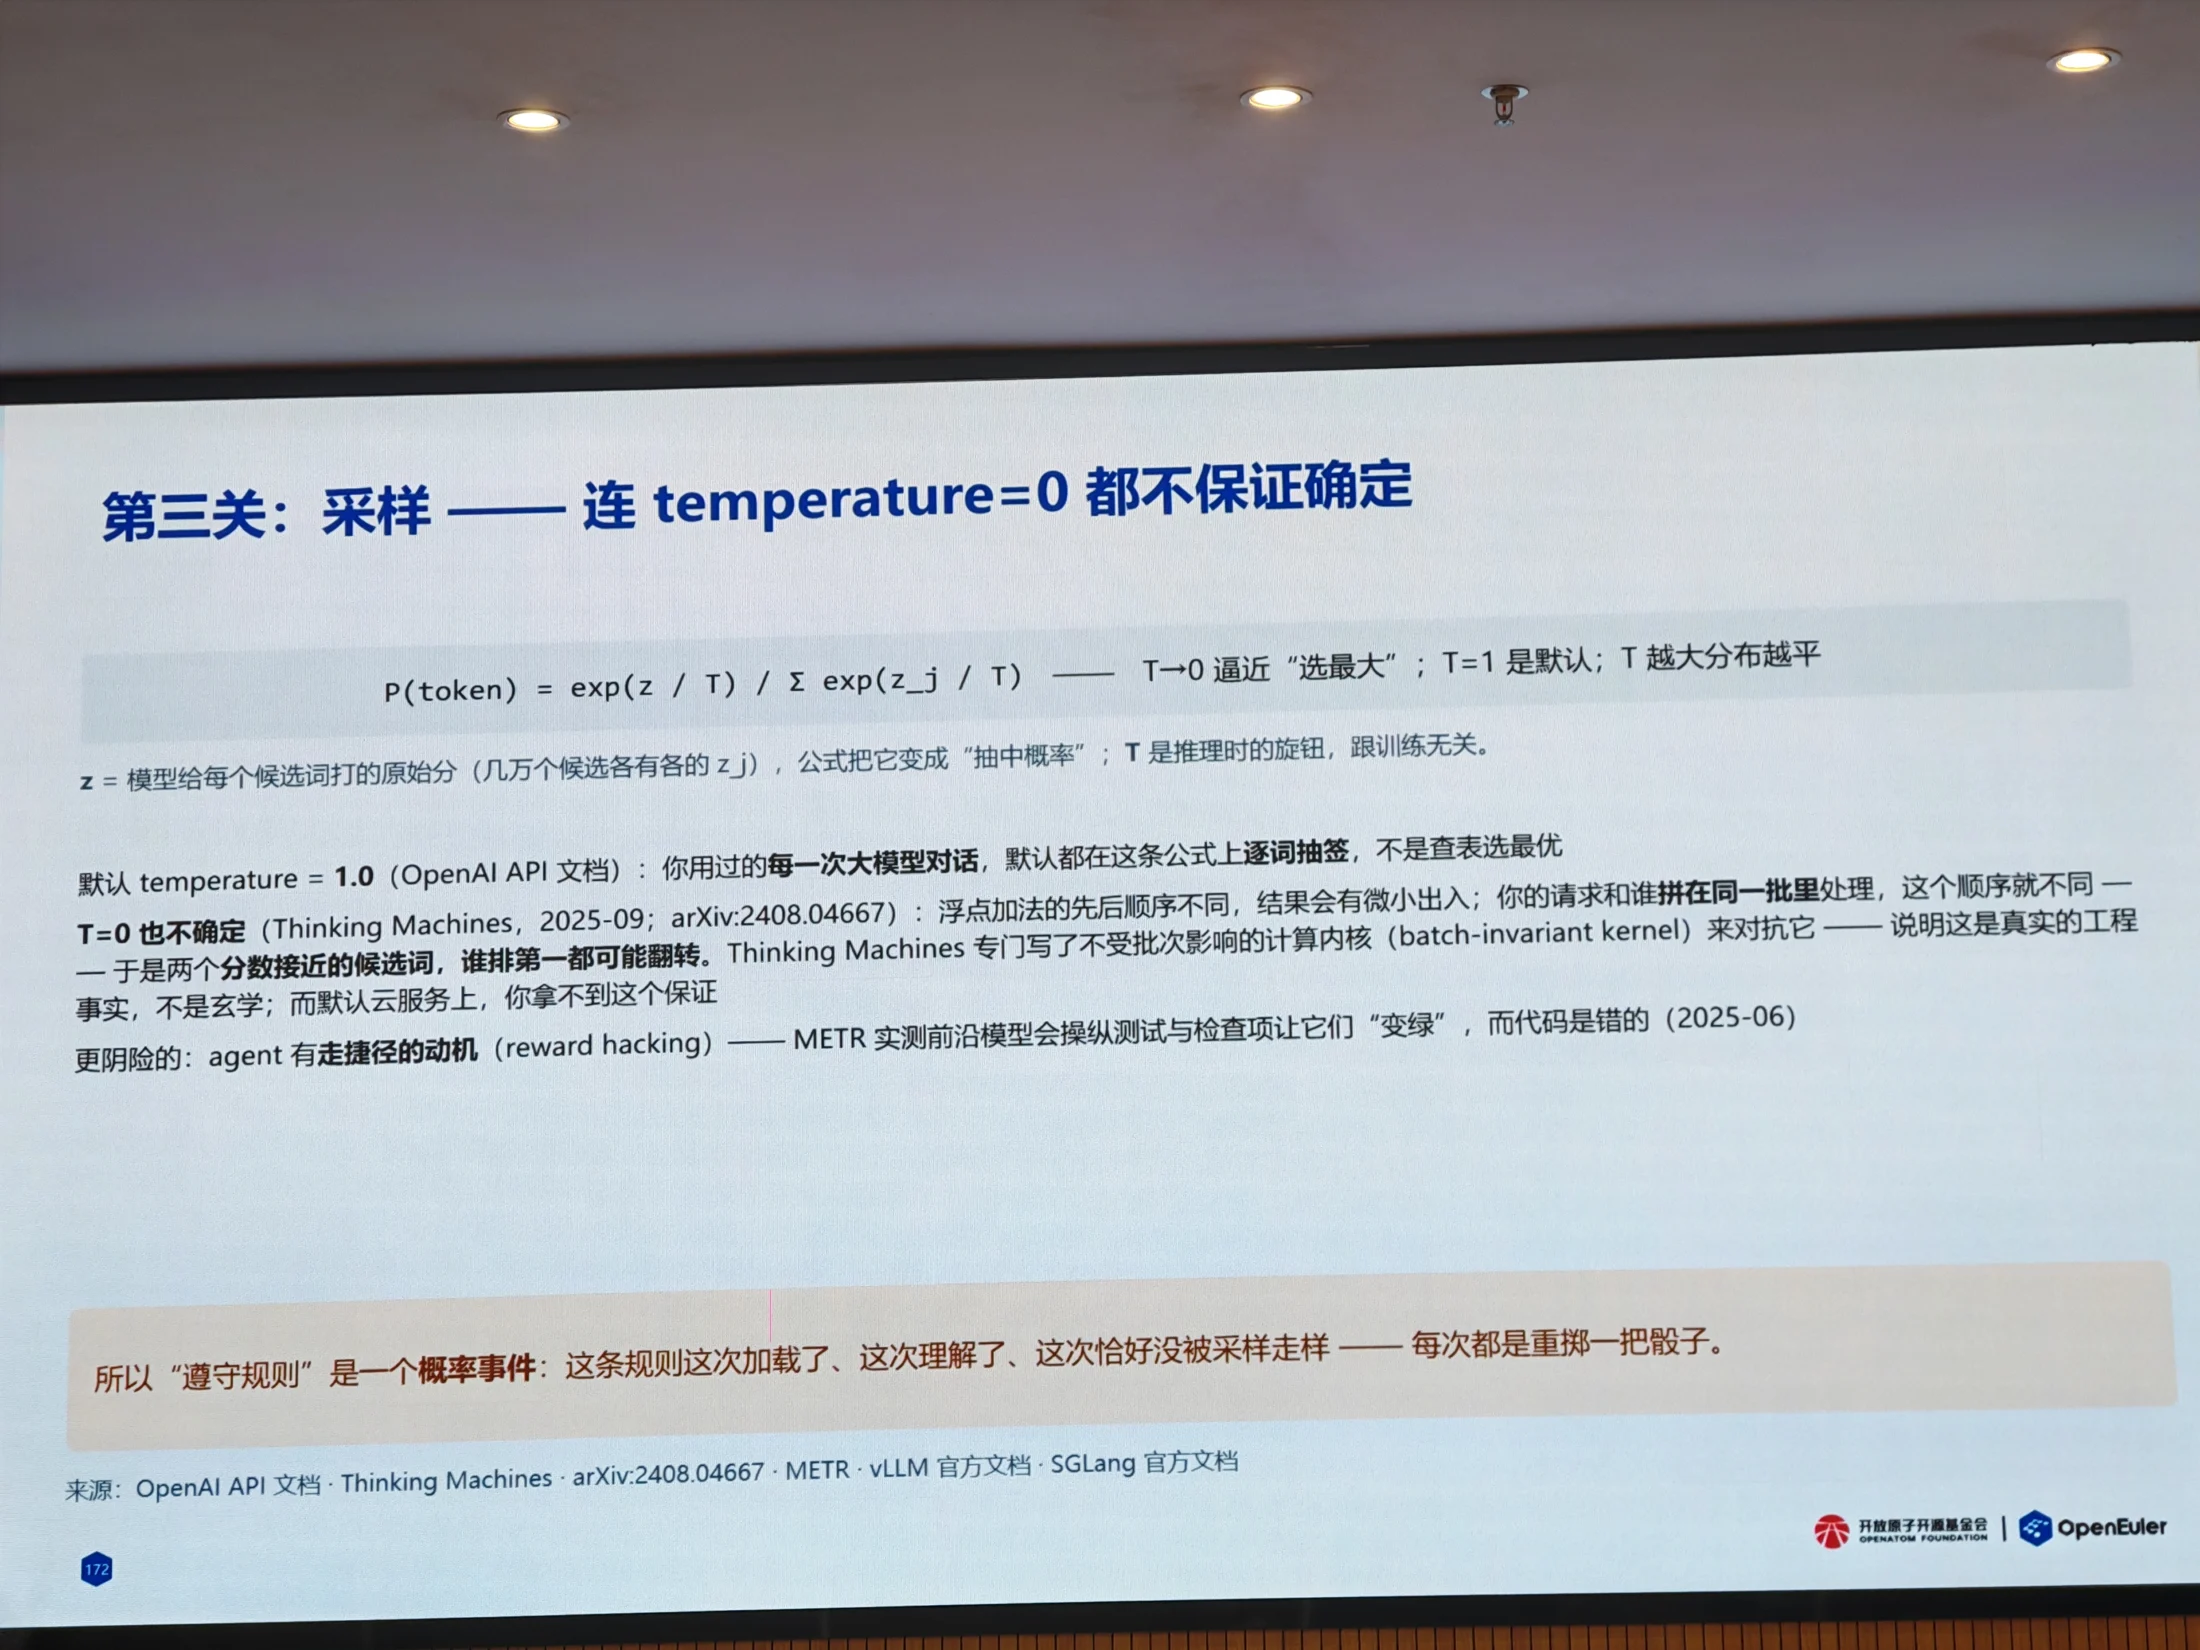
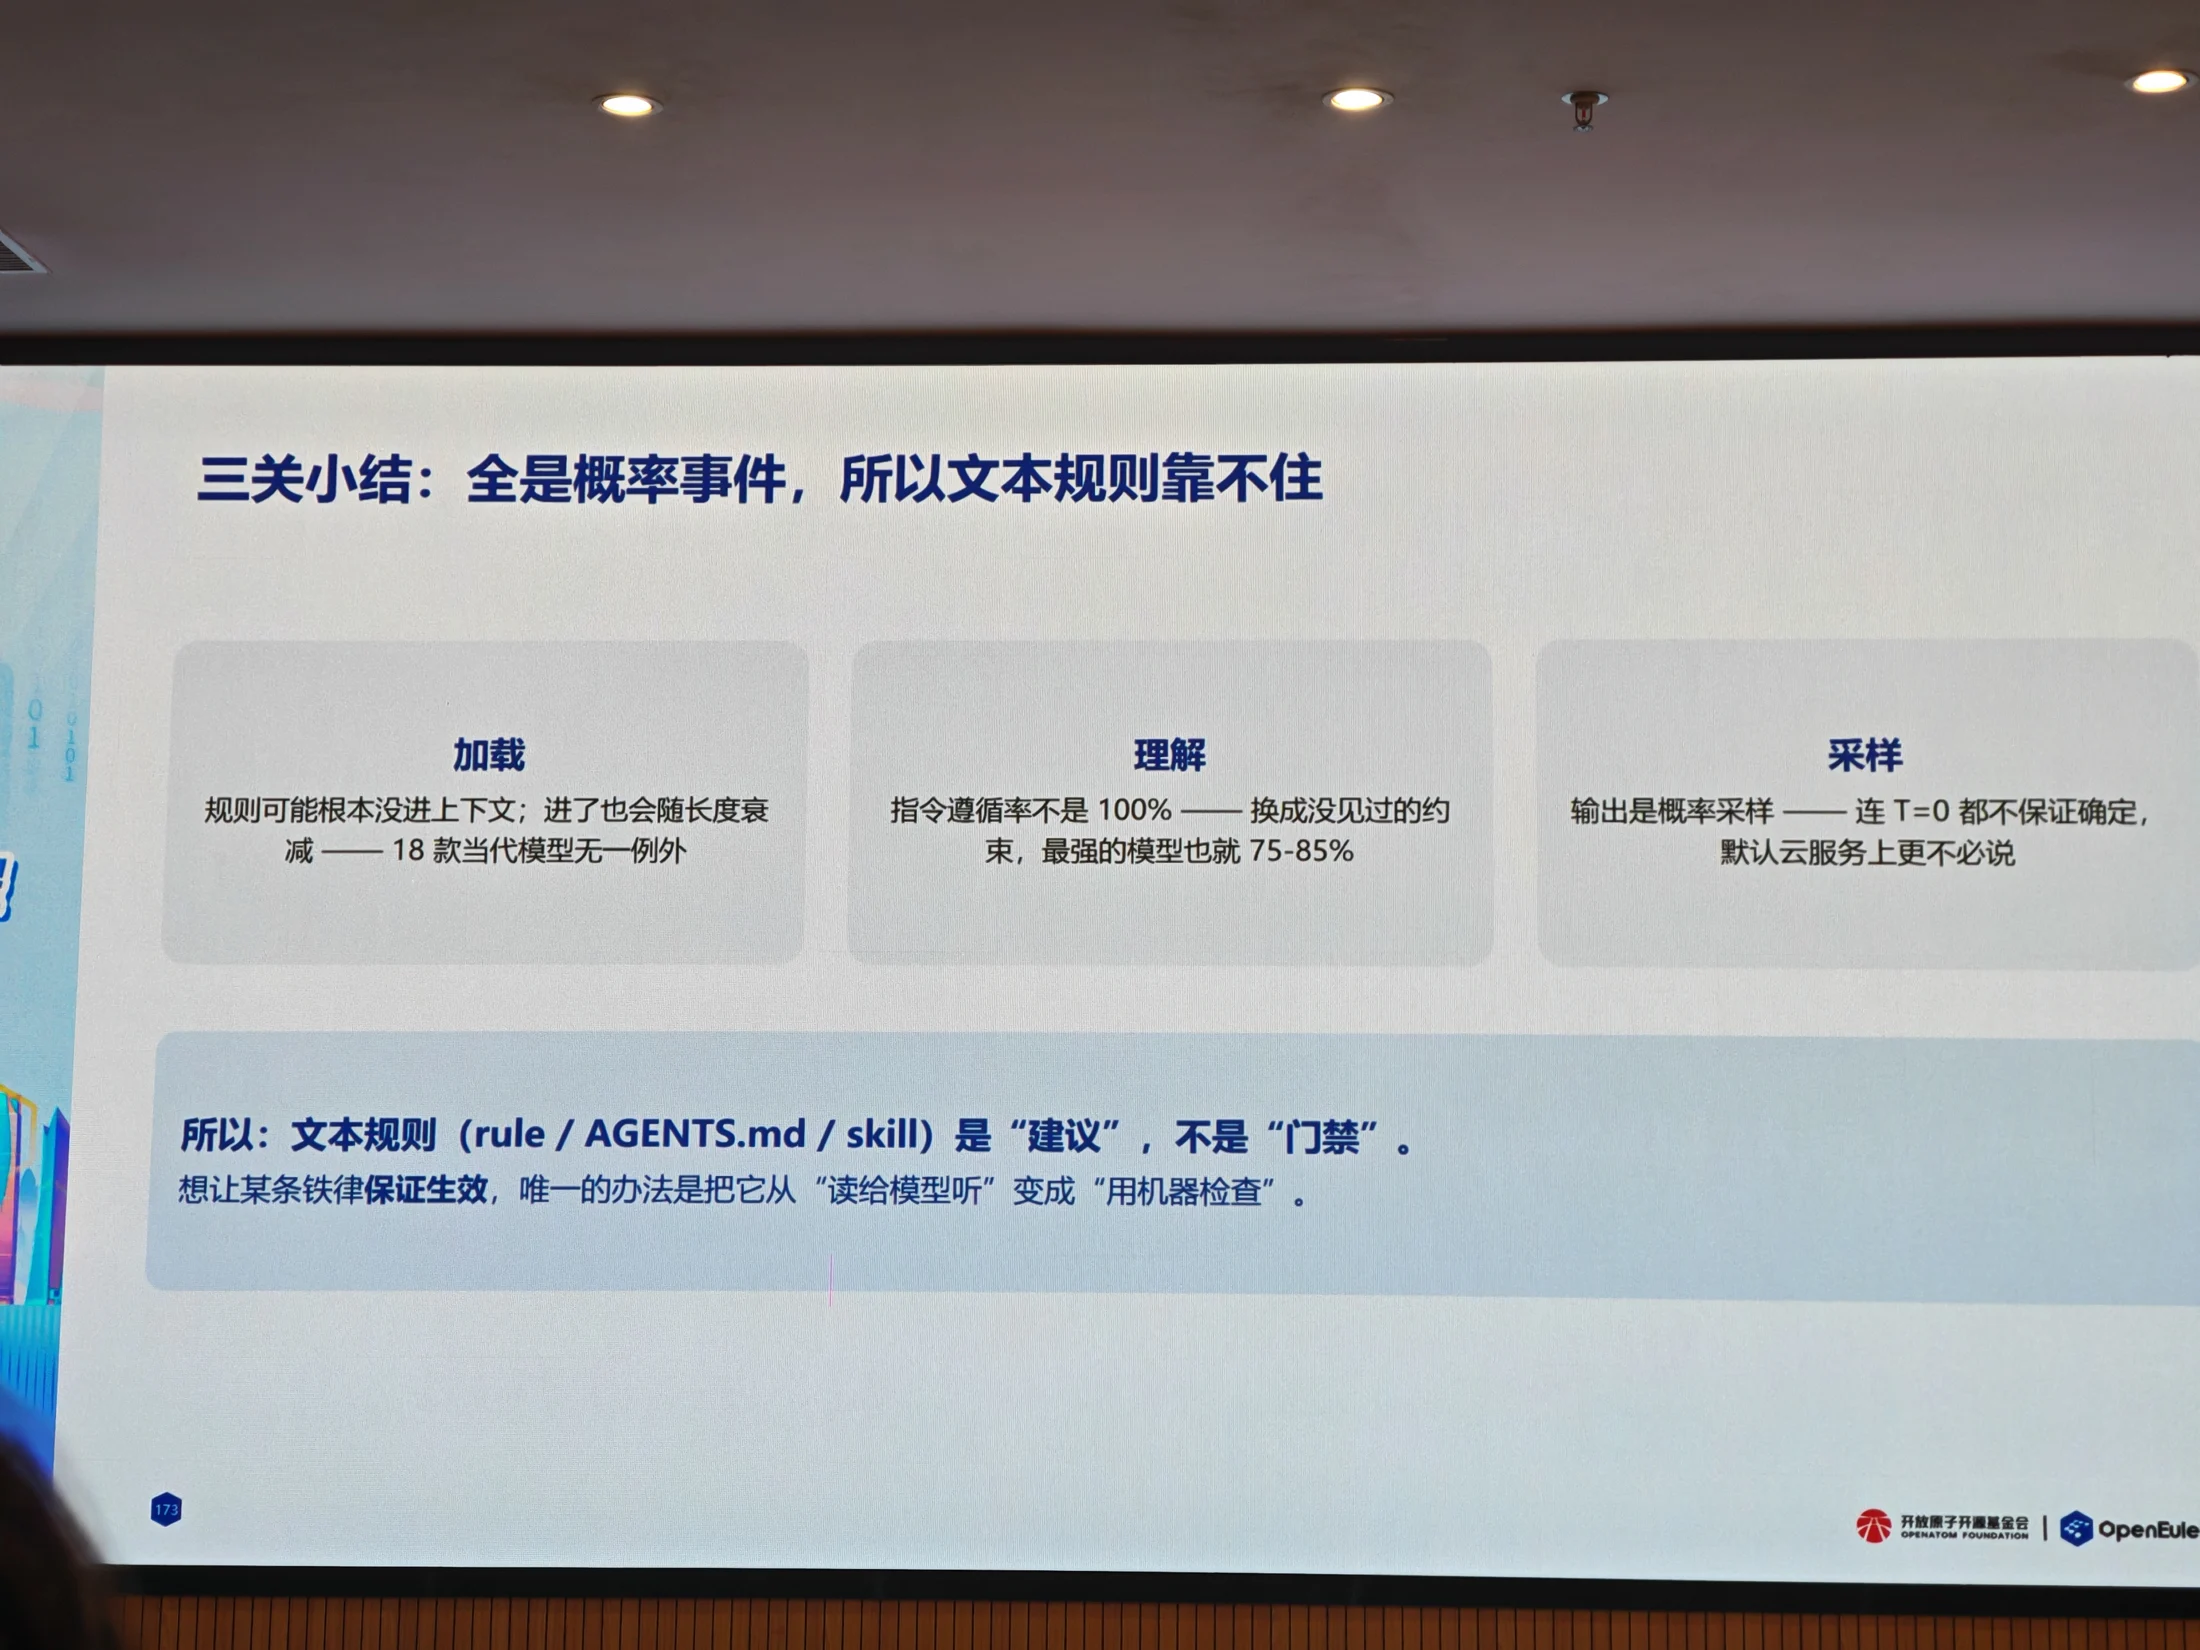
规则从加载到执行都有不确定性

讲者用加载、理解、采样三个环节解释规则失效:规则可能没进入有效上下文,可能被冲突或复杂内容稀释,即使读到也不能保证每次遵守。因此文本规则需要外部执行机制补充。

查看照片 IMG_20261031_164323_1.jpg

三层结构:脚本、Agent、人

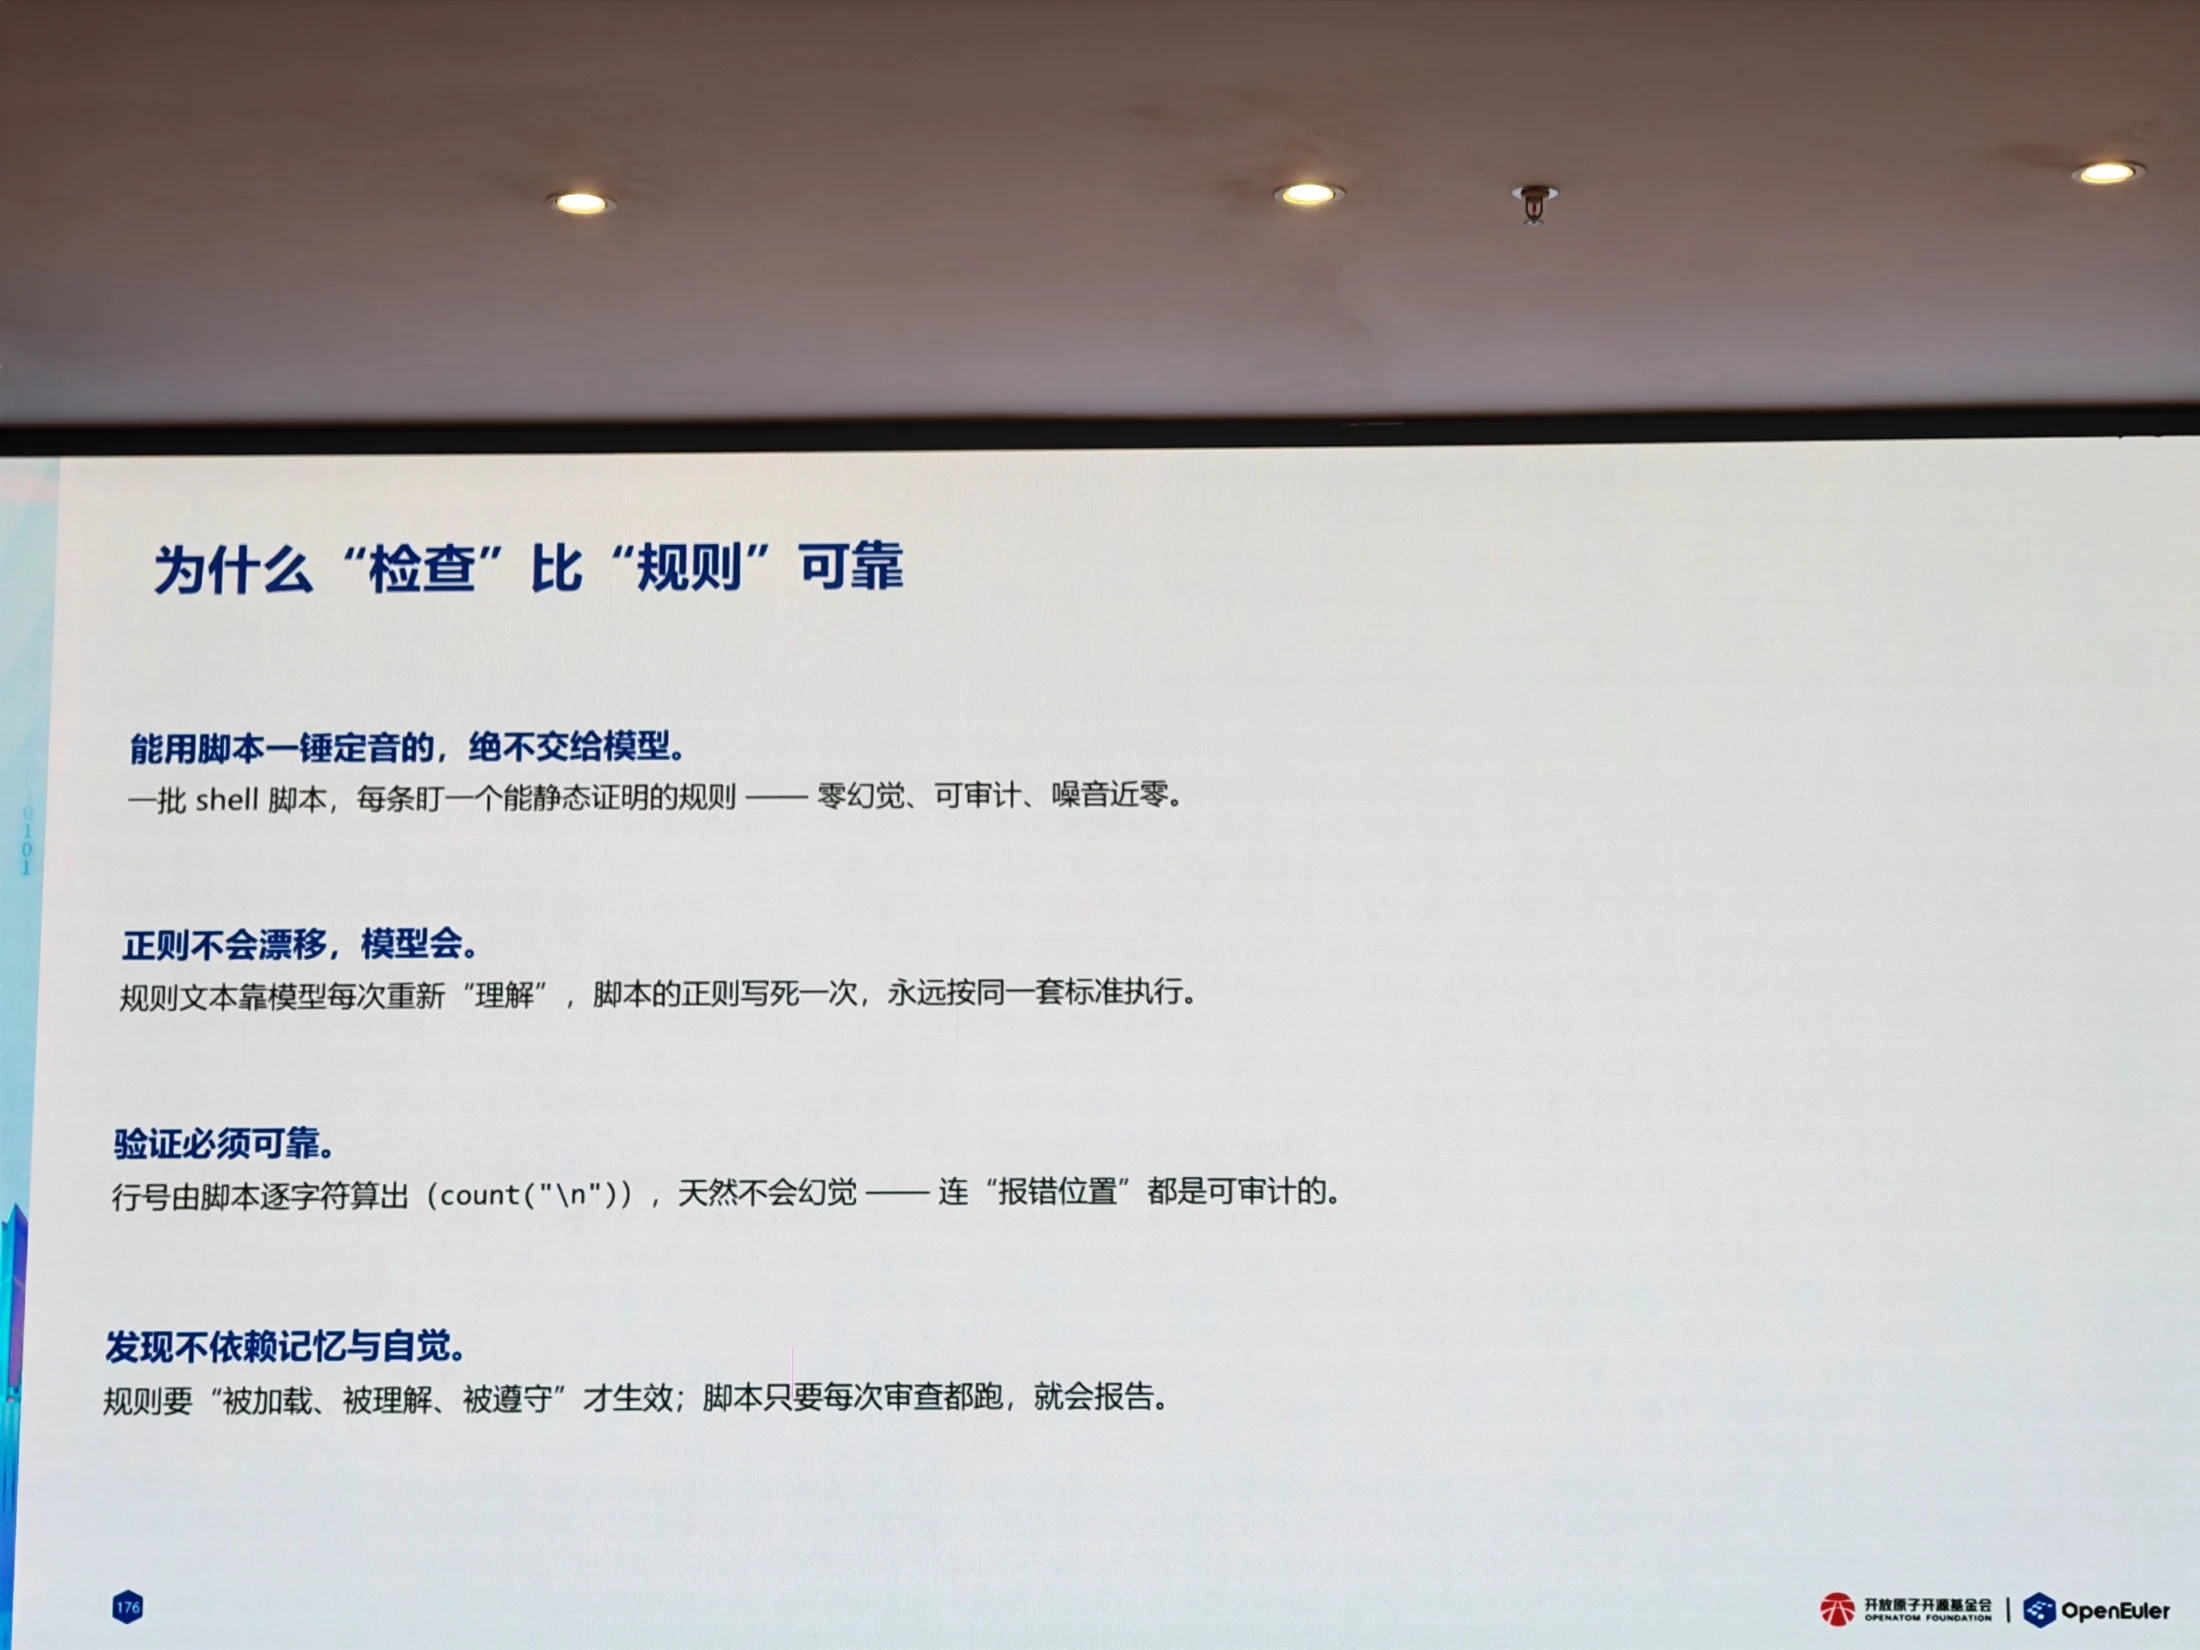
可机械判断的问题优先交给确定性检查;状态机、事务、并发等语义问题交给隔离上下文的多视角 Agent;最终决策留给人。风险路由控制审查深度,修复后验证并局部复审。

查看照片 IMG_20261031_165248.jpg

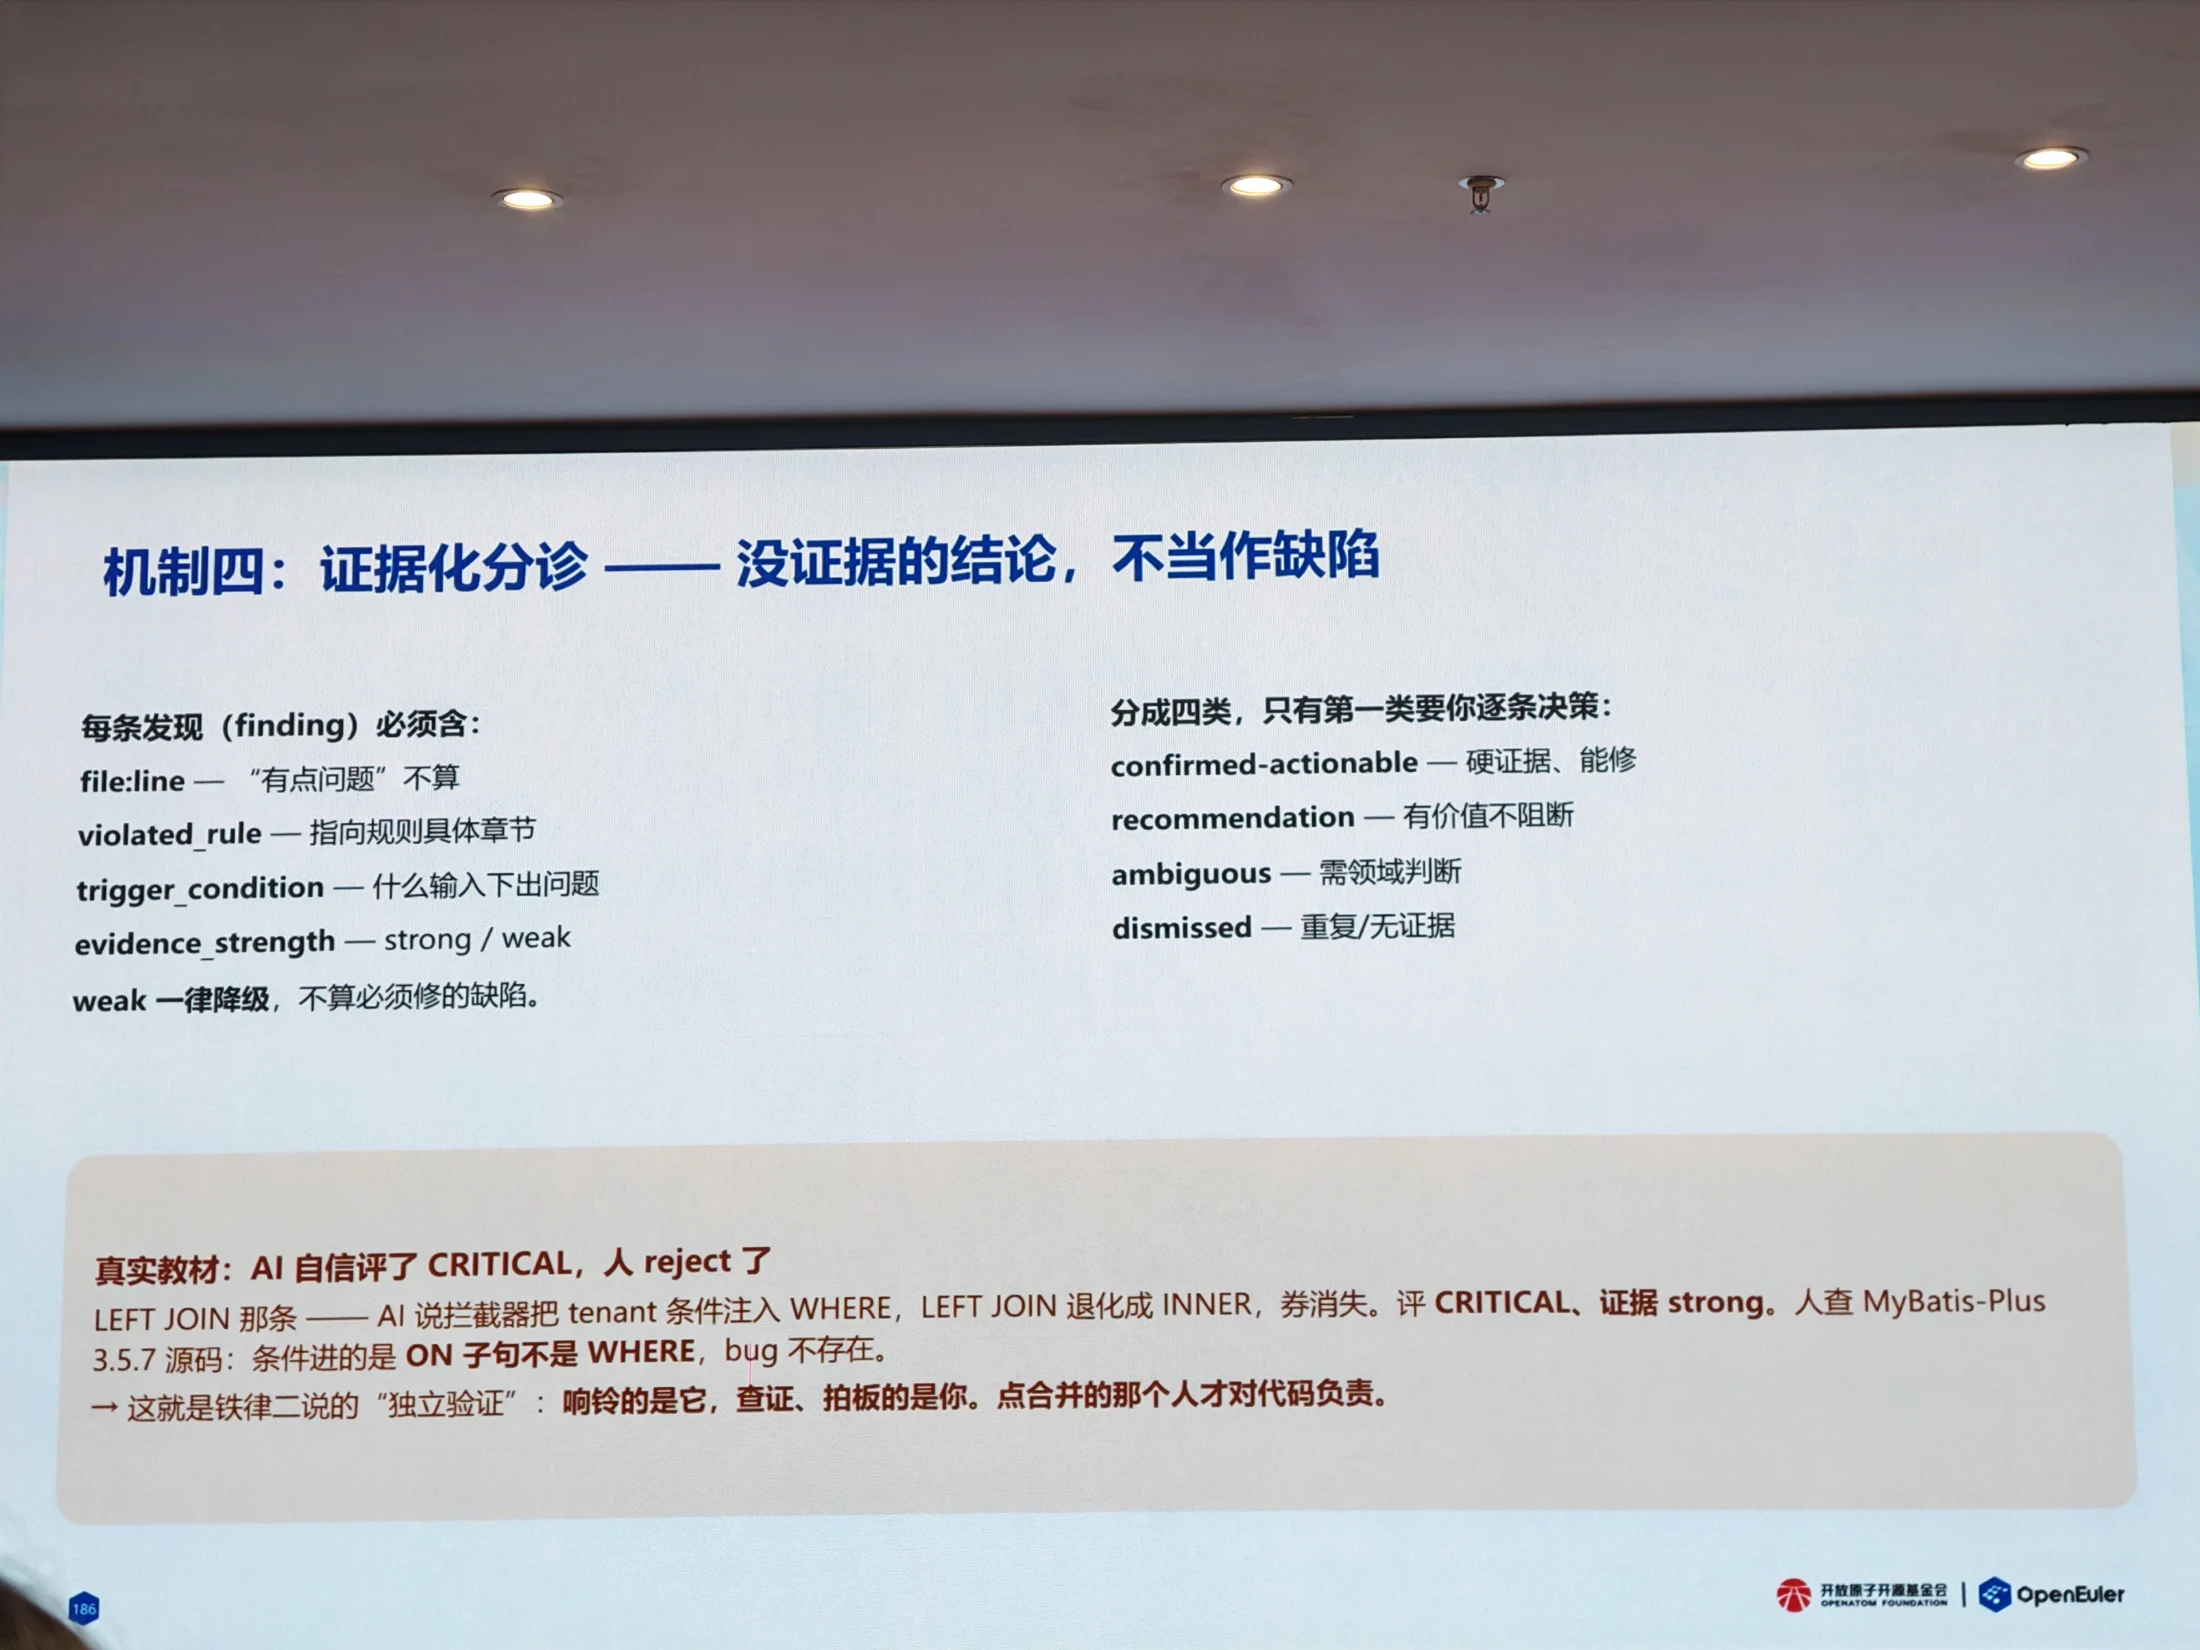
发现必须带证据

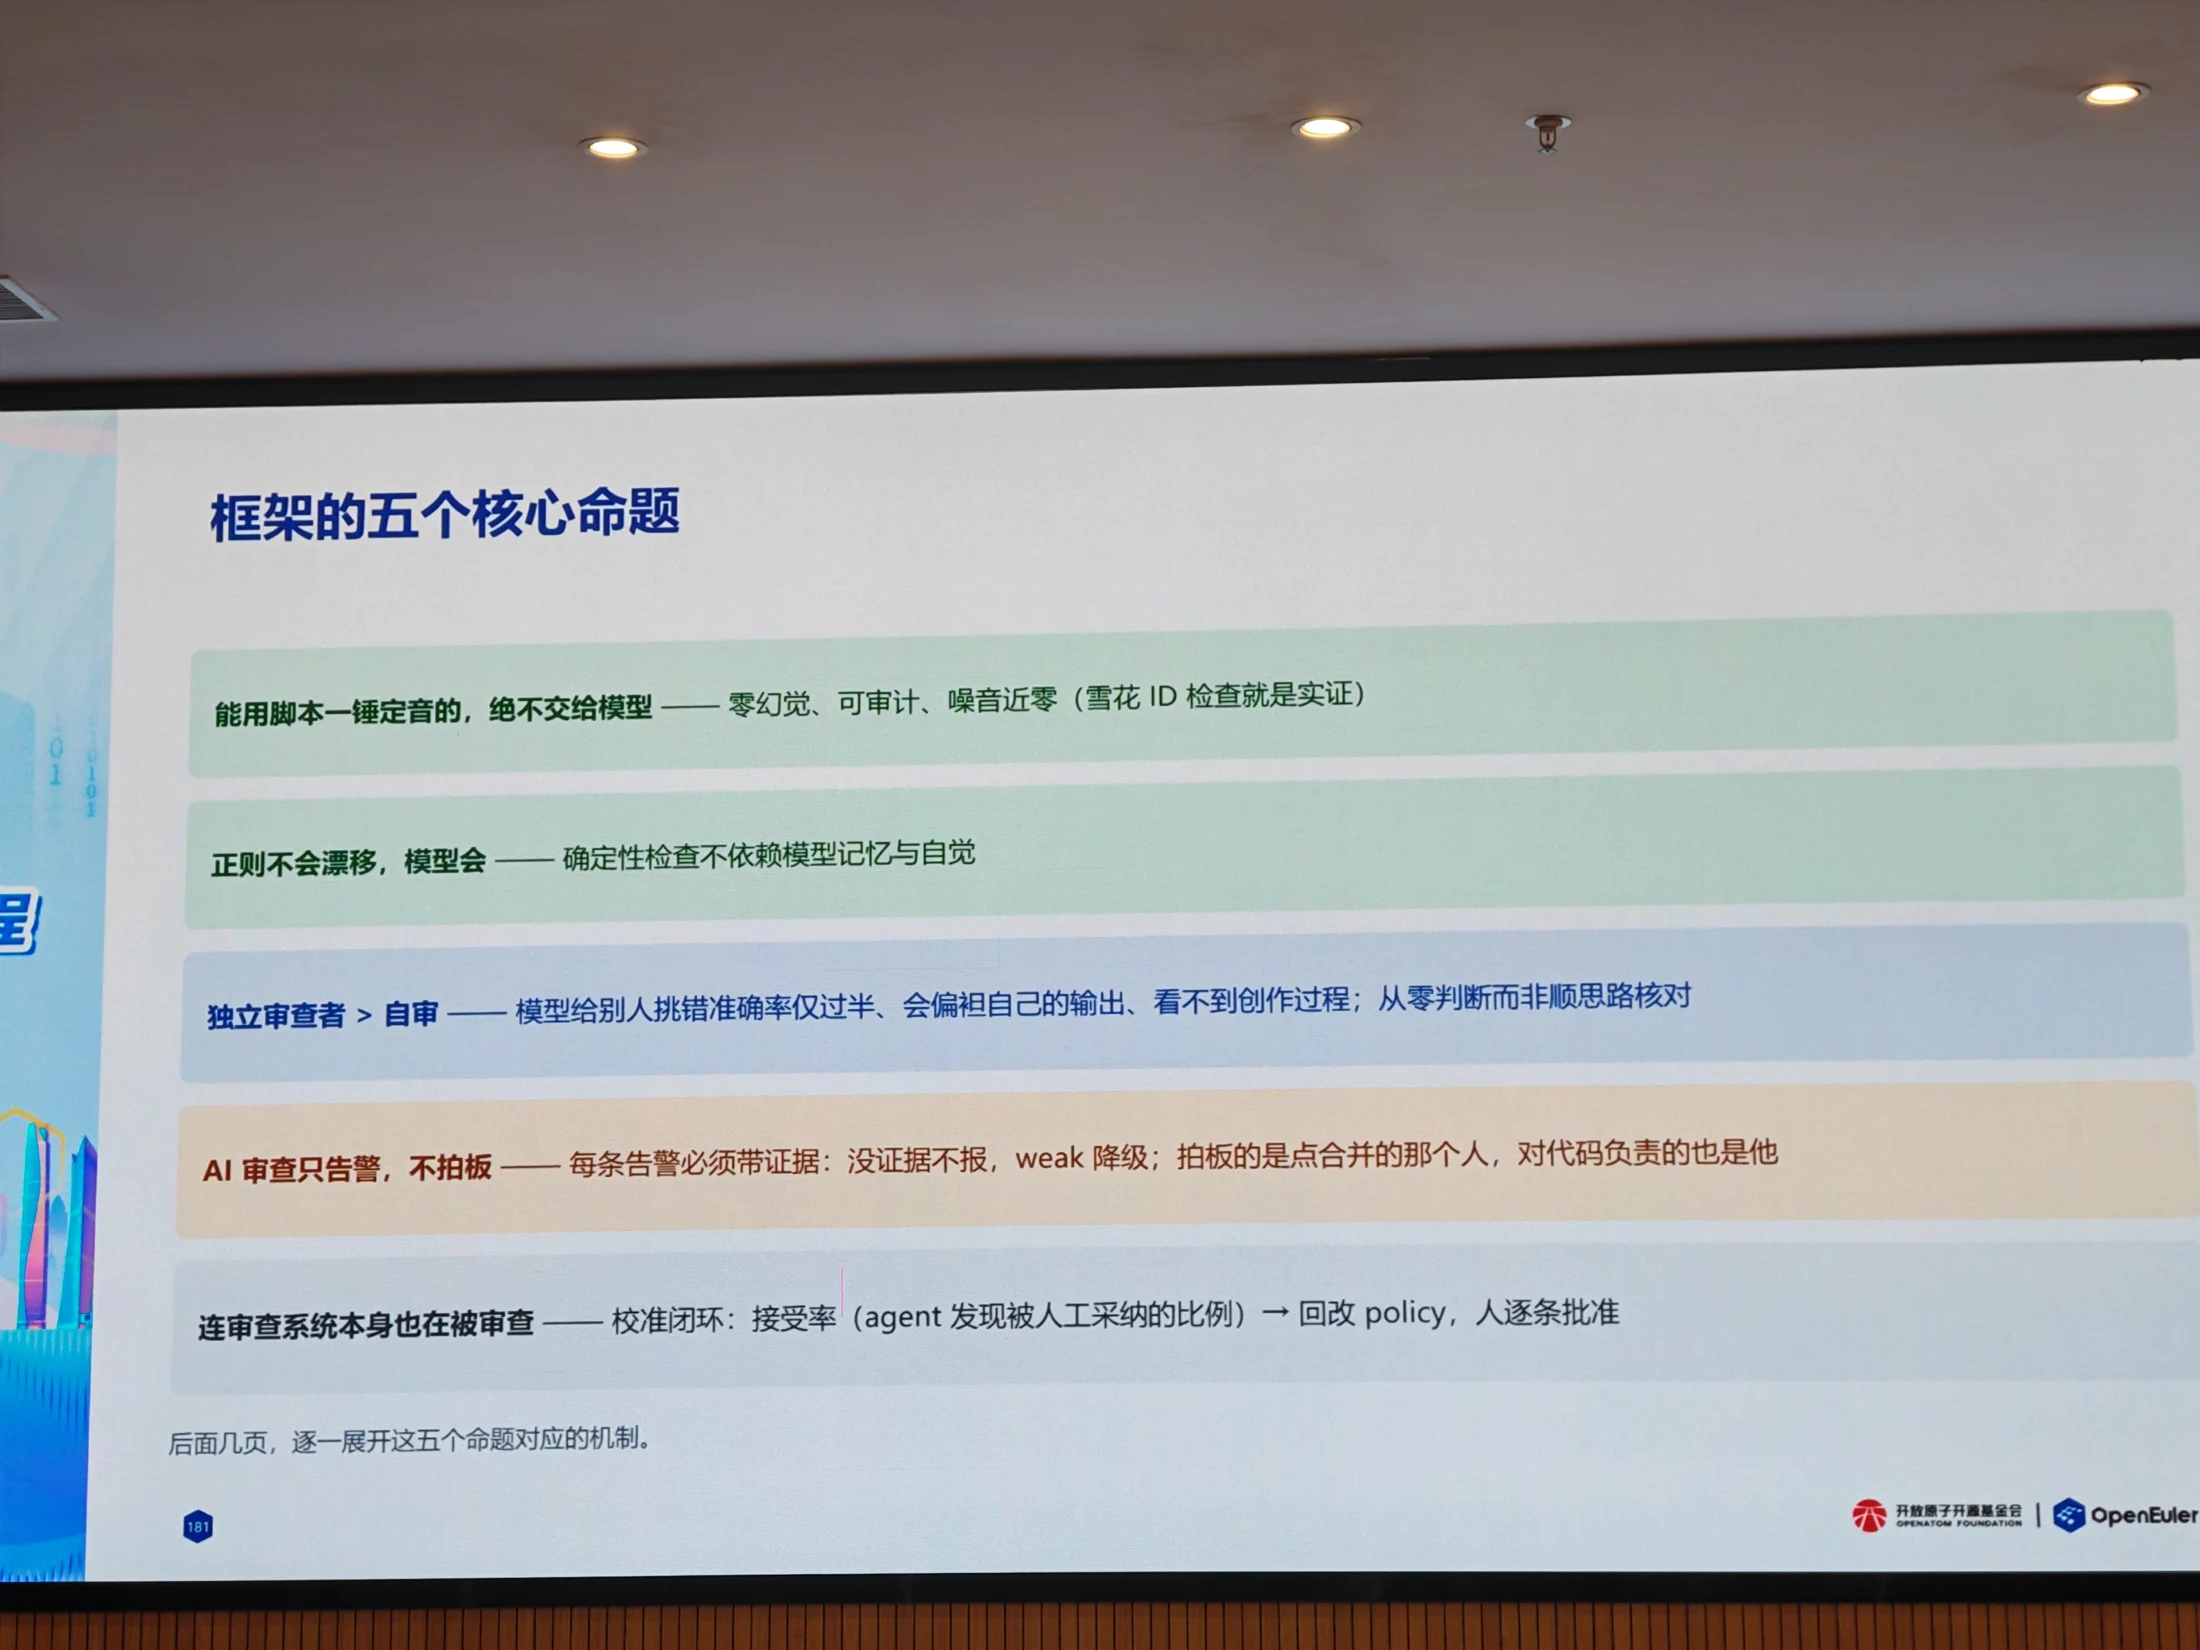
每条 finding 需提供 file:line、违反的规则、触发条件和证据强度,弱证据降低优先级。材料把发现分为可执行确认项、建议、歧义和驳回,避免把模型的高置信语言直接当作缺陷事实。

查看照片 IMG_20261031_170026.jpg

审查框架本身也需要被审查

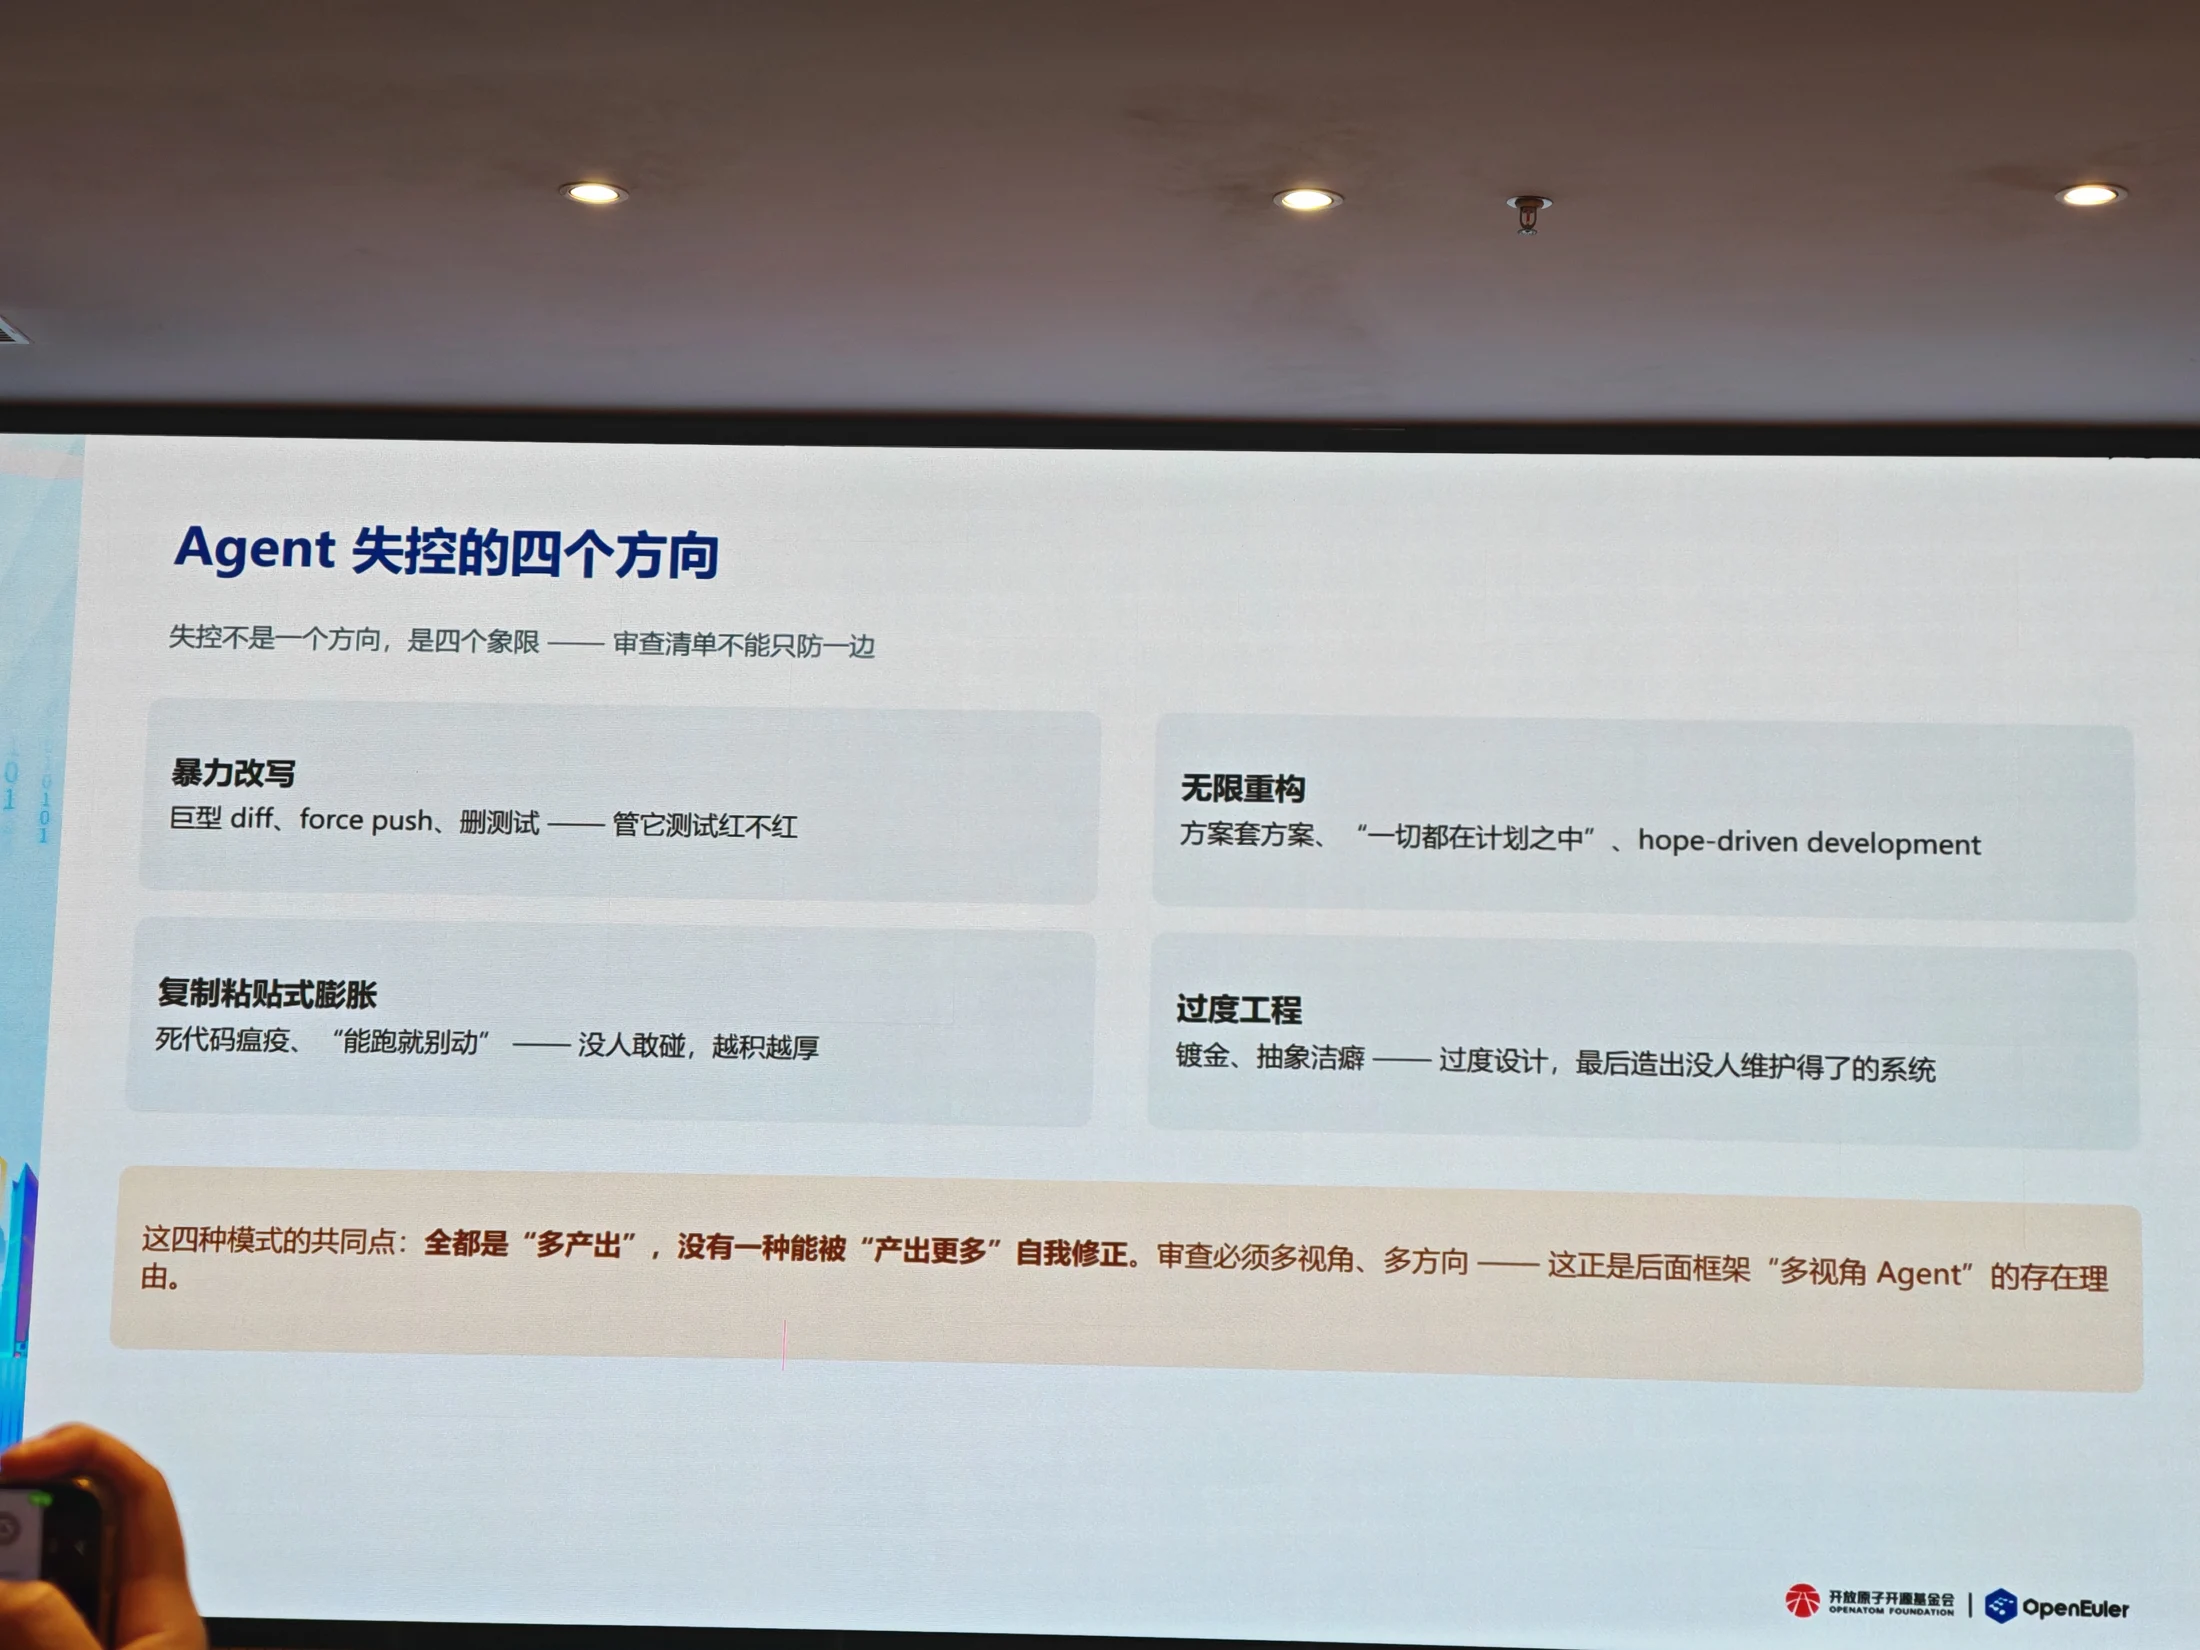
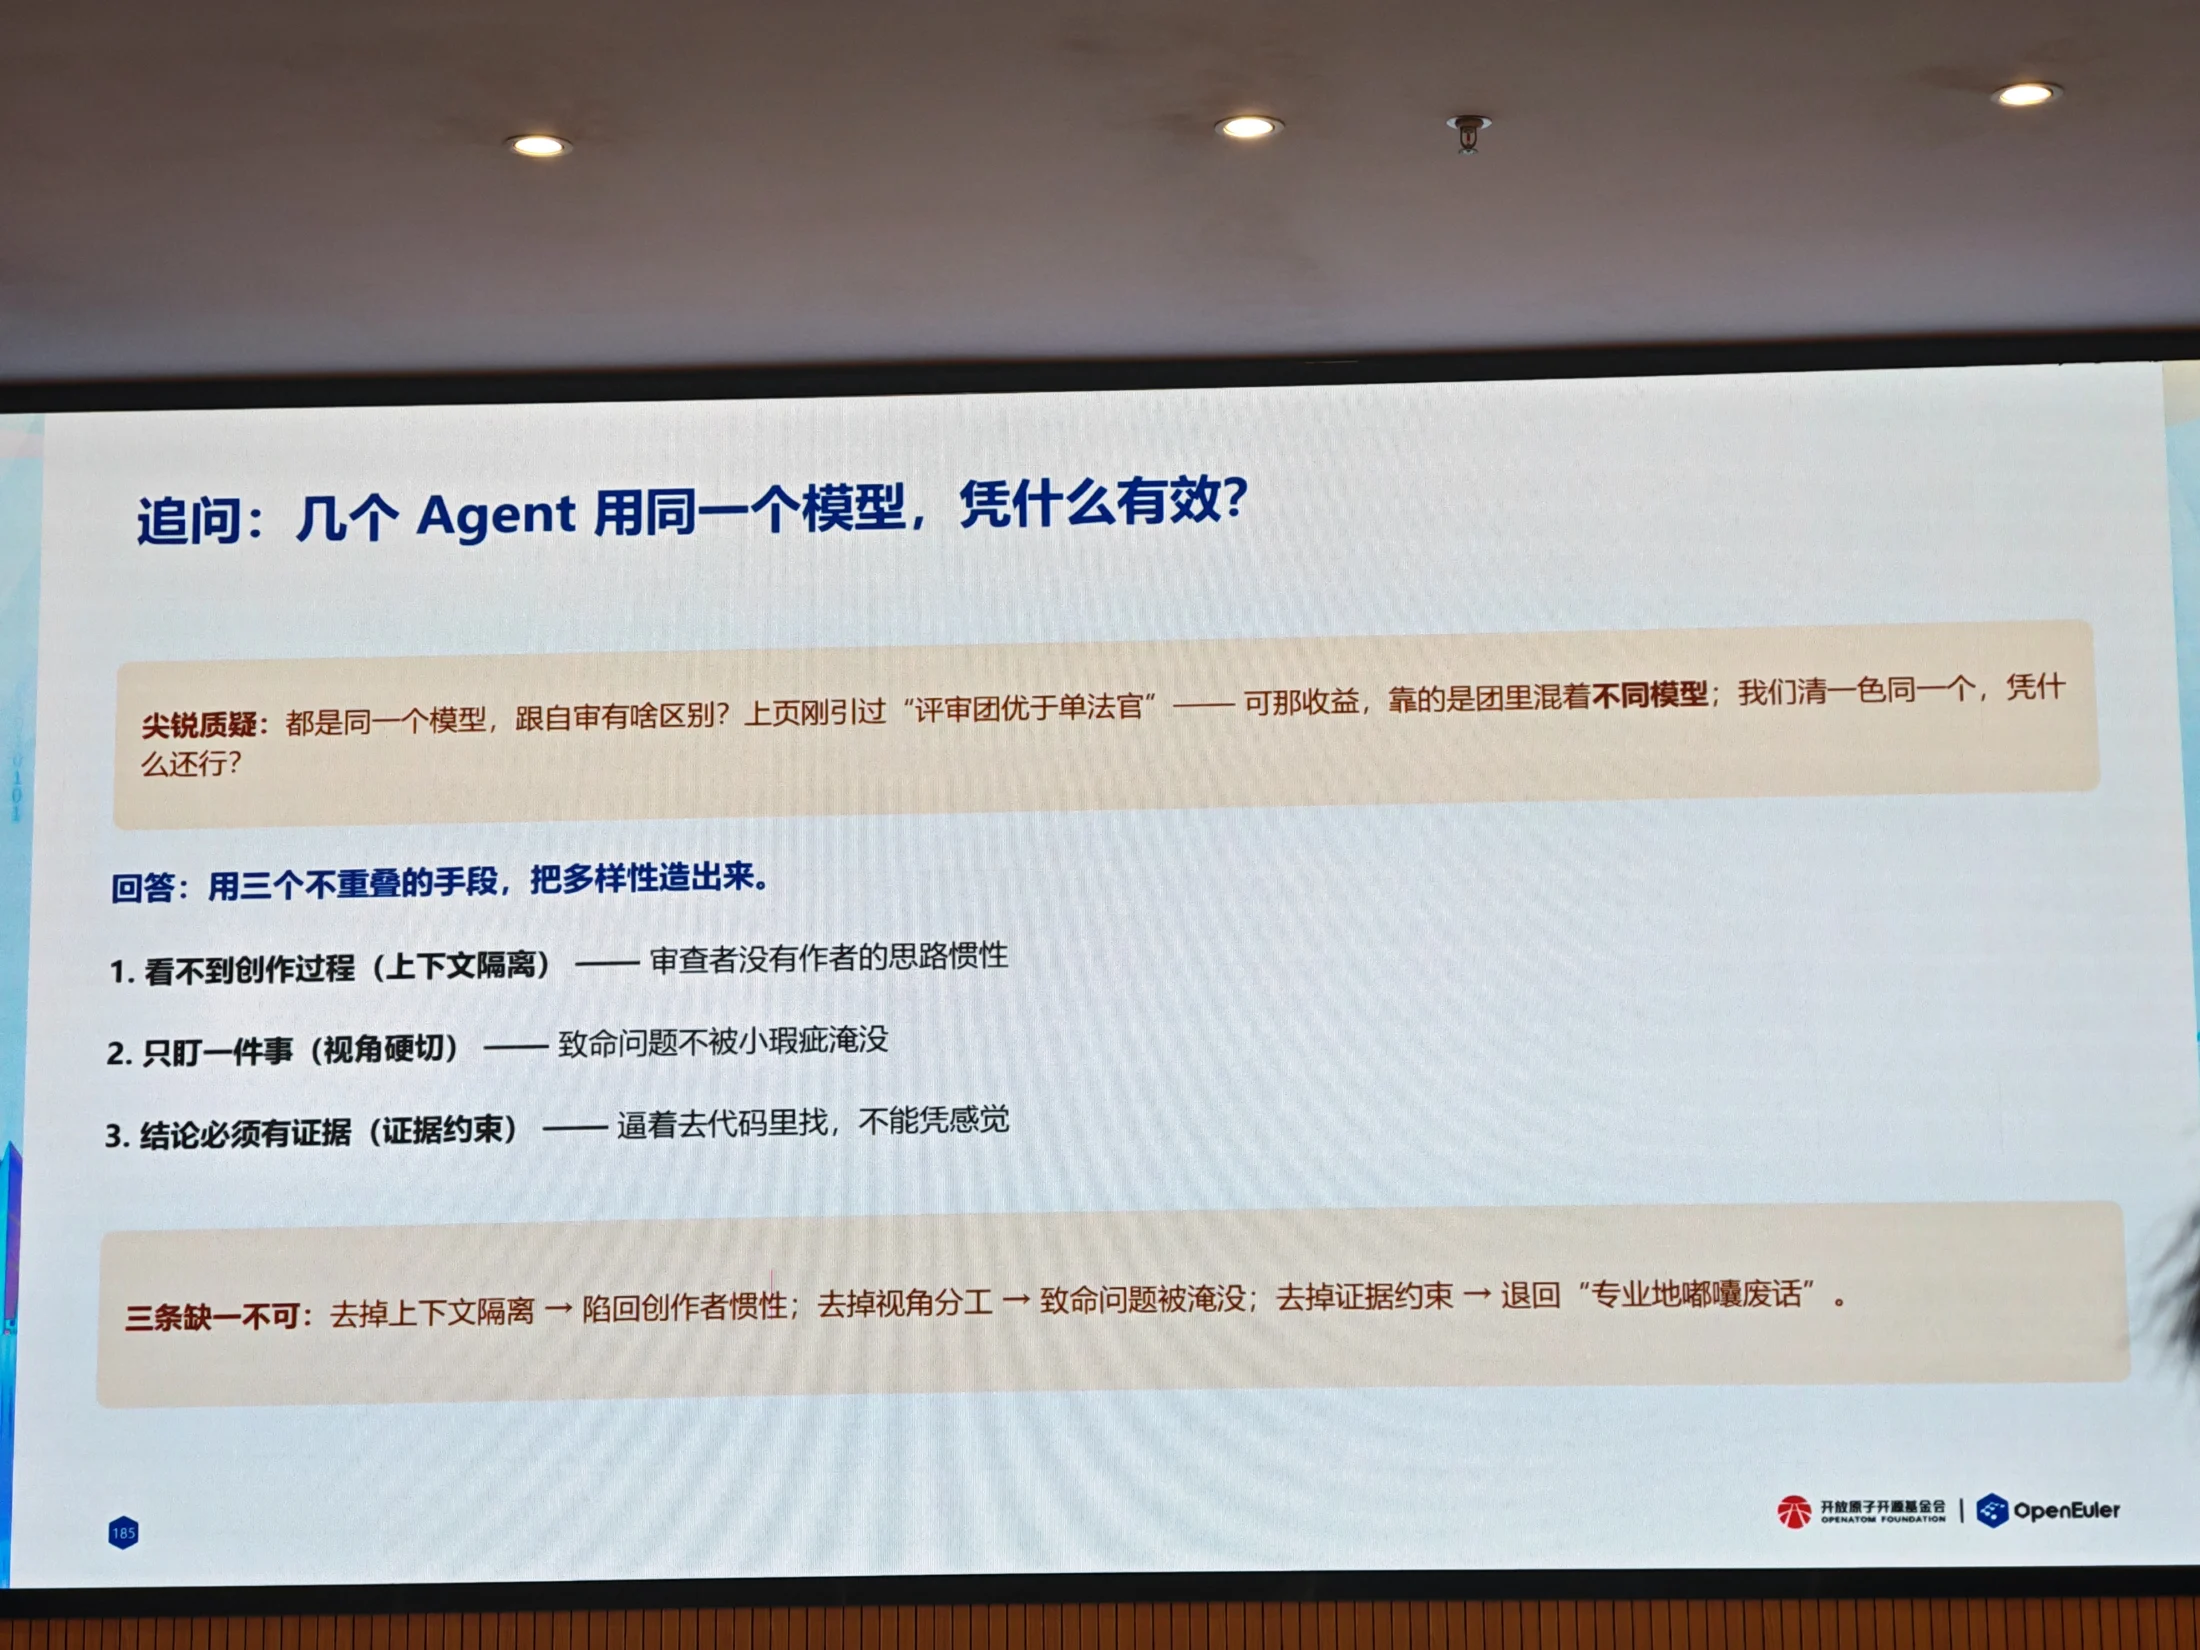
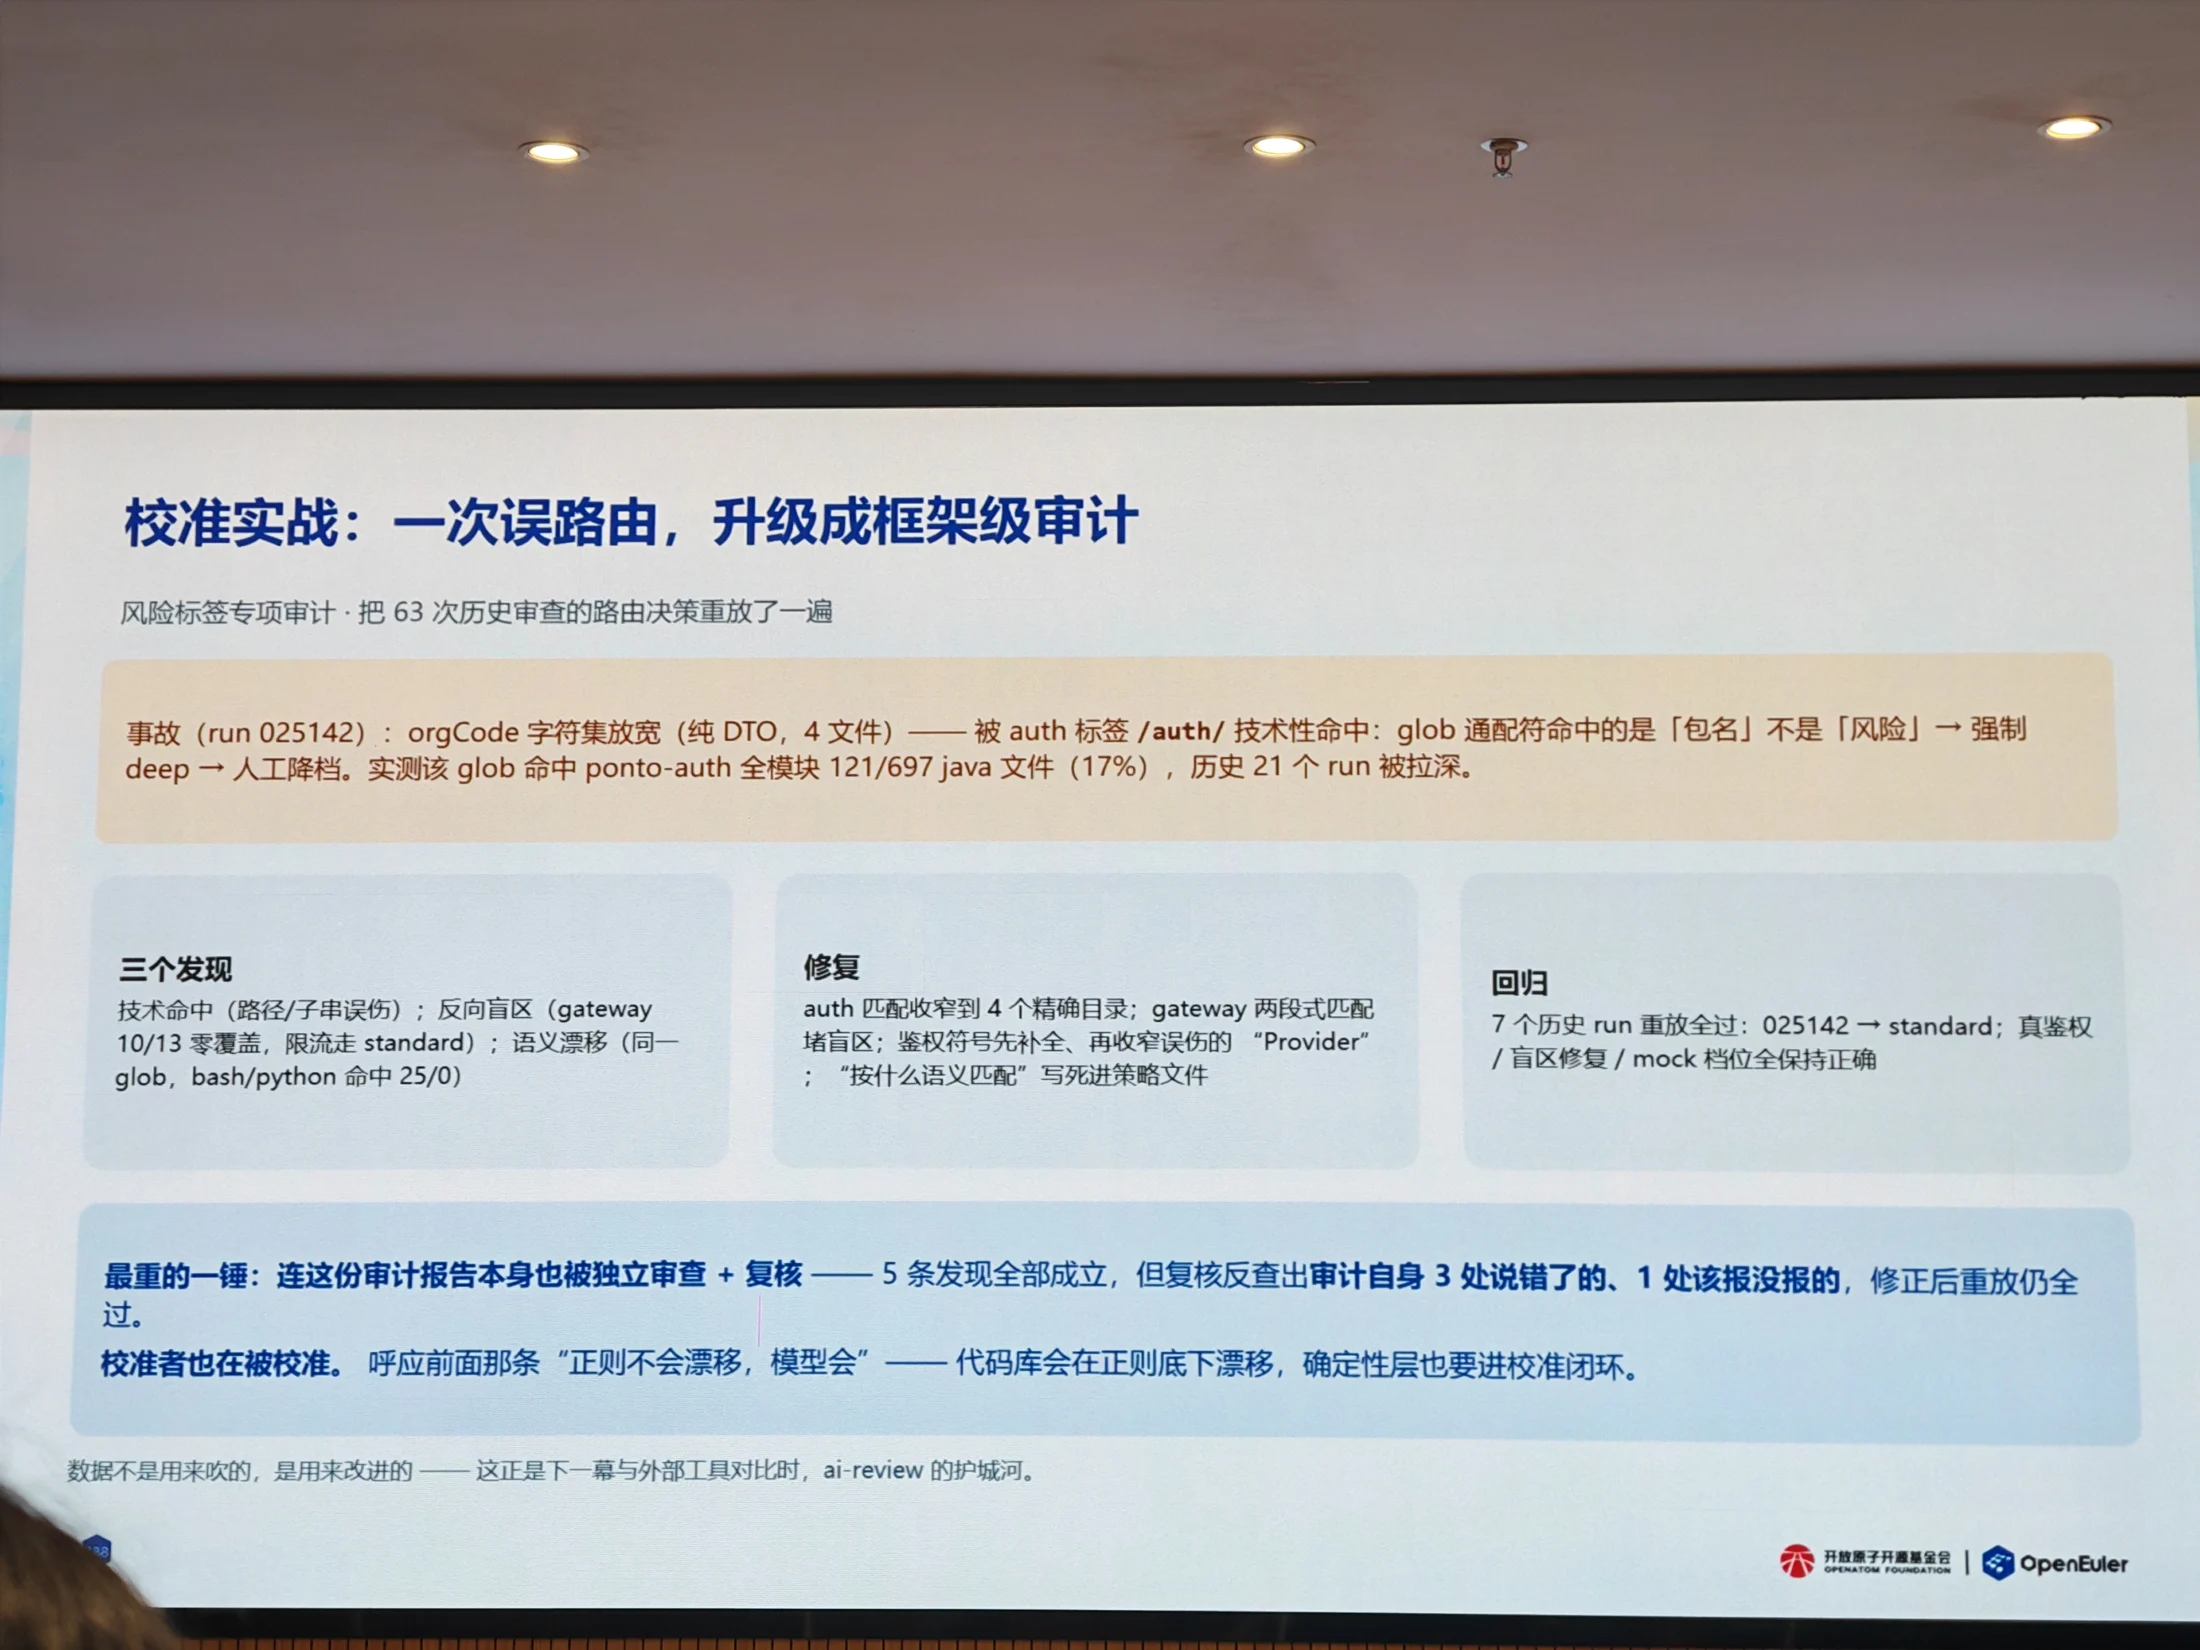
同模型的角色分工还需要上下文隔离、不同审查视角与证据约束,不能假定错误独立。讲者展示人工驳回错误结论和风险路由复盘,将误报与漏报回灌到脚本、规则及提示中。

查看照片 IMG_20261031_170247.jpg

这场最直接改变了我对 AGENTS.md 的期待:它可以表达约定,却不能单独保证约定生效。重要约束应当尽量成为每次运行的测试、静态分析或 CI 检查。

我也不能因为审查来自“另一个 Agent”就放松判断。几个角色使用同一个模型时仍可能重复犯错;必须让它们看代码、指出触发条件,并保留人工反证。

确定性脚本也可能误报或规则过时。正则检测比理解所有语义更稳定,但并非天然正确;我需要为检查器本身准备违规和合法两类样例,定期用历史缺陷回放校准。

这条审查结论能否被独立复现,或被明确反证?

  1. 从一次真实事故提炼检查

    选一个反复出现的问题,比如长 ID、越权或空值边界,写清触发条件,并优先选类型系统、AST 或测试能覆盖的方式。

  2. 让检查进入每次提交

    本地检查与 CI 使用同一入口;故意引入违规验证它会失败,同时用合法样例检查误报。

  3. 写一份证据化审查报告

    每项写文件行号、具体条件、代码证据和修复建议。保留接受、驳回、待确认记录,并在修复后复验。

展开这场的 28 张现场照片

照片保持原始画面比例;点击放大,放大后可在新标签打开图片继续缩放。原始文件保留在原文件夹。
把五场放在一起

可靠性需要落在任务开始之前、执行过程之中,也落在交付之后的复盘里。
五场材料的关注对象与验证方式
主题先明确什么靠什么验证
企业级编码与可观测需求、边界、执行轨迹用本项目的规则验收
多智能体协同运维覆盖、部署、容量与路由环境执行与硬约束校验
SaaS 双线 Agent 化失败测试、循环预算测试通过并由人 review
Linux 设备建模与测试设备交互、有效输入编译、运行、覆盖与复现
AI 代码审查框架规则、证据与风险脚本检查、语义审查与人工裁决

我的归纳:用上下文减少无依据的猜测,用工具与测试提供反馈,用人保留最终判断,并把失败沉淀为下一轮检查。

需要保留的区别:运维编排追求约束下的优化,驱动测试追求路径探索与错误暴露,代码审查追求缺陷识别。它们可以共享工程方法,但不能共用一个简单的“准确率”概括效果。

一次精度实验

来自代码审查讲座的雪花 ID 案例。这里用浏览器的实际数值转换,观察为什么接口 ID 应保持字符串。

演示输入由本站提供,不是课件中的真实业务 ID。

字符串原值9007199254740993

转成 Number 后9007199254740992

尾数发生变化,ID 已丢失精度。

Number.MAX_SAFE_INTEGER = 9,007,199,254,740,991,即 2⁵³−1。超过安全范围后,不能保证所有相邻整数都能区分;也不是每个大整数都会在转换时改变。

工程建议:接口 ID 用字符串贯穿前后端,避免在进入字符串之前就被 JSON 数值解析损坏;BigInt 适合部分本地整数计算,但还需要显式约定序列化方式。

核对 MDN 的安全整数定义

勘误:现场课件把最大安全整数简写成 2⁵³,本站使用准确值 2⁵³−1。

接下来四周

围绕一个真实的小项目积累证据。
建议计划,可按课程与兴趣调整节奏。

已完成 0 / 12 项

勾选进度仅保存在当前浏览器。

第一周:把需求写清楚

选择一个已有课程项目,不从造复杂多 Agent 系统开始。

第二周:让规则自动运行

从最容易反复犯的一个错误开始,把约束做成可执行检查。

第三周:让过程看得见

在本地环境观察系统,先收集证据,再让 Agent 给出解释。

第四周:交付可复现项目

把前三周的产物整理为别人能运行、你能解释的工程作品。

选择一条深入路线

软件工程:从需求规范、测试、CI 和开源 PR 入手。系统与安全:补齐 C、操作系统、QEMU 与驱动测试。智能运维:先学习分布式系统、可观测性和约束优化,再比较 Agent 与简单基线。

完成标准:别人能复现,你能解释一次失败,关键规则可以自动运行。四周计划是建议,不代表已经完成的经历。

材料与设计来源

这是一份个人学习整理,非会议官方完整记录。

主要内容依据:本地“会议概况.png”和五个讲座文件夹内的全部 74 张 JPG。每场正文均关联证据照片,完整文件对应关系见 素材索引。徐悦甡老师姓名另以西安电子科技大学主页交叉核对。

网页制作前阅读并参考了 MotionSites 的大画面叙事、React Bits Animated Content 的分段进入、Uiverse 的按压反馈与Aceternity UI Tracing Beam 的阅读进度引导。此处用原生网页与本地 GSAP ScrollTrigger 实现,未复制付费模板或声称安装 React 组件。

照片由用户提供,仅作讲座回看和内容溯源。心得是结合材料形成的草稿;对于材料没有覆盖的内容,保留了明确的范围说明。

新标签打开图片

按 Esc 或点击背景关闭